
Tenstorrent pristato MiniMax M3.1 Flash dirbtinio intelekto modelį debesyje su patobulintu efektyvumu
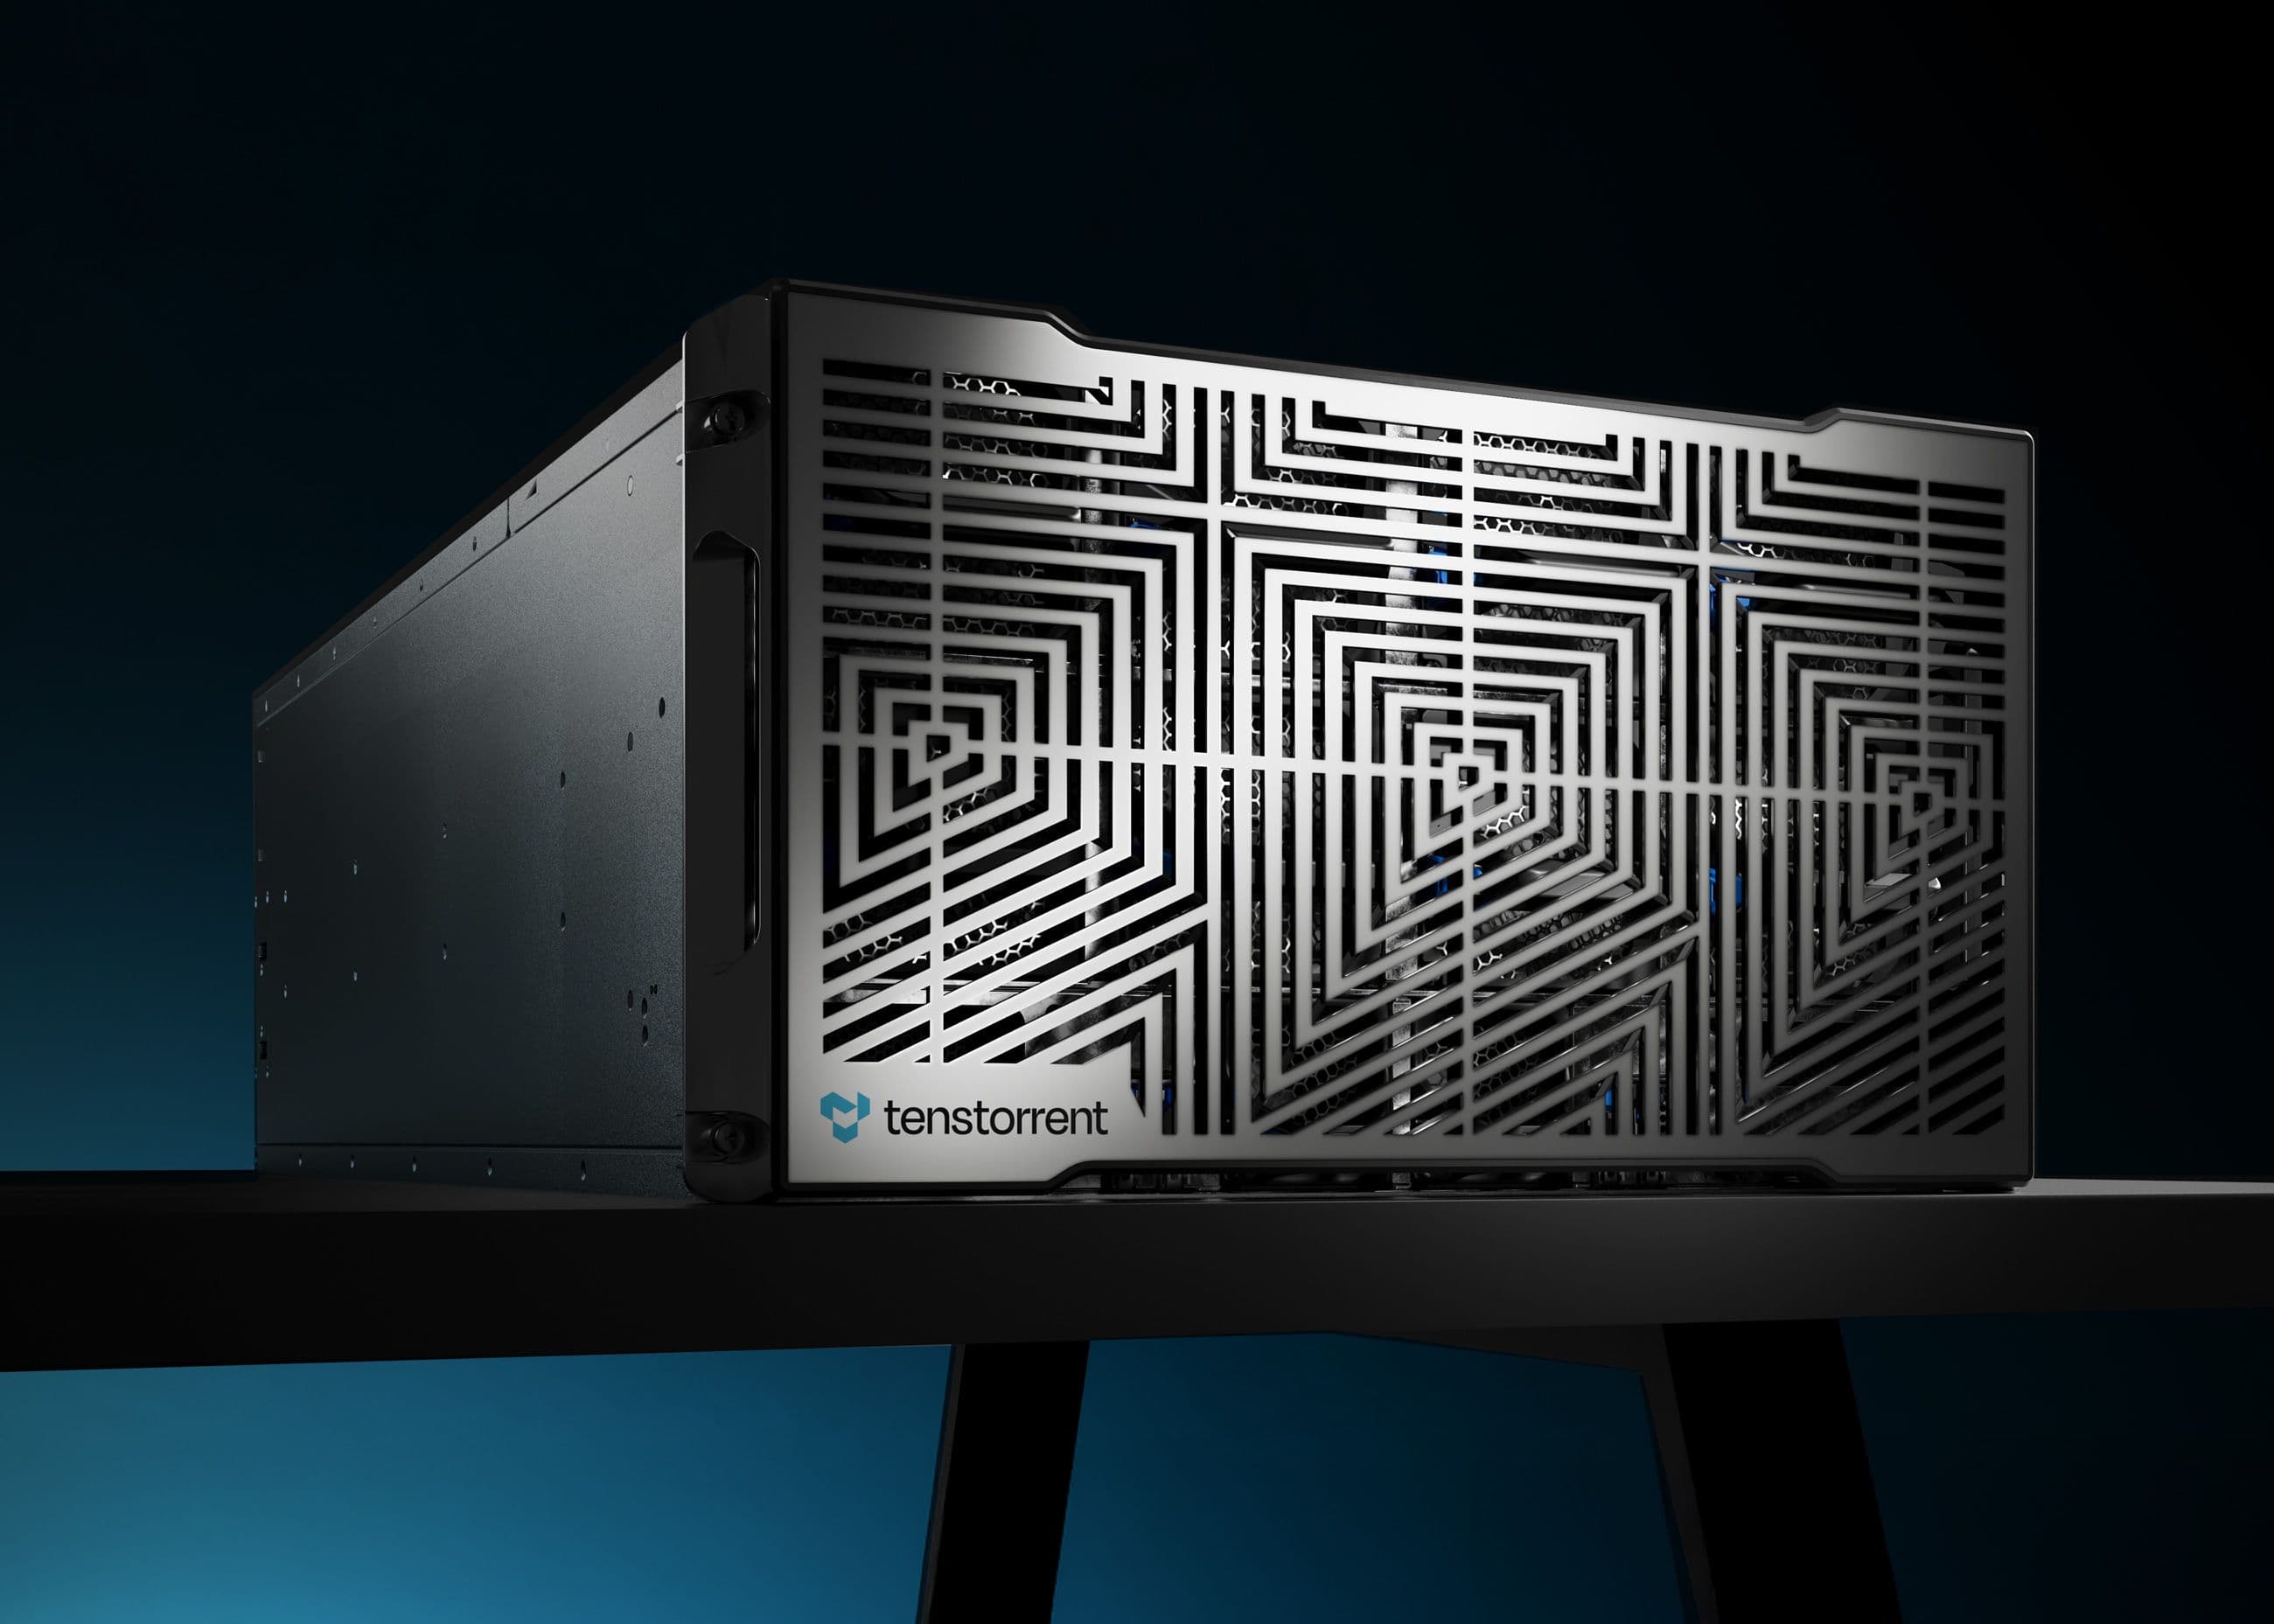
Vaizdas: Tenstorrent · Šaltinis
Tenstorrent dabar siūlo MiniMax M3.1 Flash modelį savo debesų platformoje, pasižymintį ženkliomis sąnaudų mažinimo galimybėmis ir stipriomis agentų užduočių atlikimo savybėmis, pagrįstomis architektūros inovacijomis ir modelio kvantizavimu.
Tenstorrent paskelbė, kad įdiegė MiniMax M3.1 Flash dirbtinio intelekto modelį savo debesų platformoje, vykdydamas tiek duomenų paruošimo, tiek dekodavimo procesus savo patentuotoje Galaxy® superklasterio infrastruktūroje. MiniMax lygiagrečiai paskelbė modelio atvirus svorius, leidžiančius vartotojams pasinaudoti šiuo pažangiu DI įvairioms taikymo sritims.
MiniMax M3.1 Flash yra sukurtas gamybinio masto agentų užduotims atlikti ir pasiekia maždaug 70 % mažesnes veiklos sąnaudas, palyginti su savo pirmtaku MiniMax M3. Kainos už milijoną įvesčių tokenų sumažėja iki 0,15 USD, o už išvesčių tokenų - iki 0,60 USD, tai yra perpus mažesnė kaina nei ankstesniame modelyje. Talpinamų įvesčių tokenų kaina dar mažesnė – 0,015 USD už milijoną tokenų.
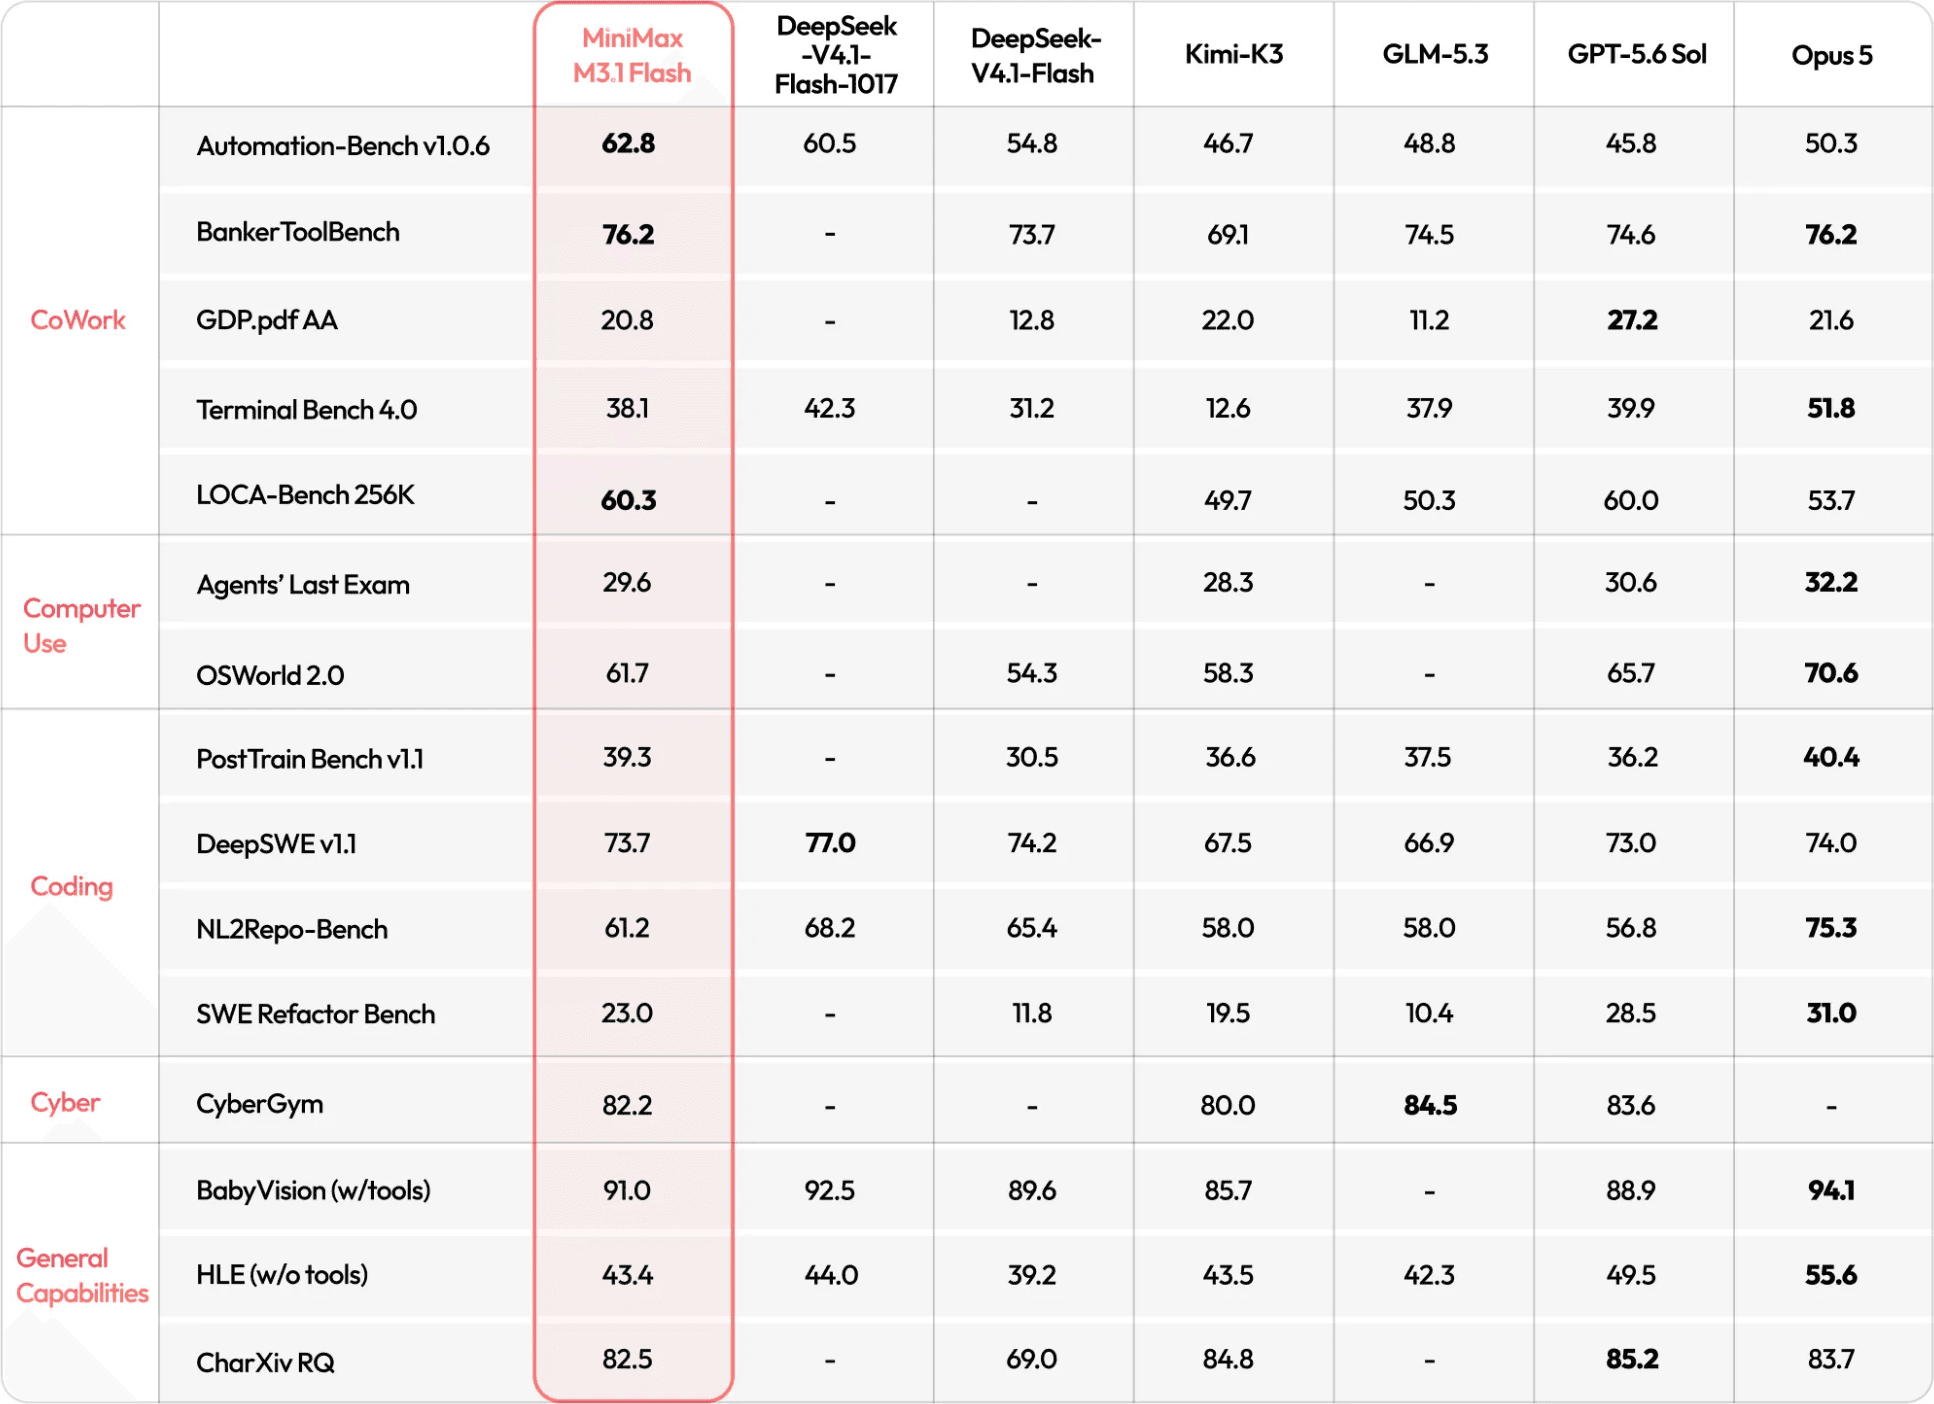
Veiklos rodikliai rodo, kad MiniMax M3.1 Flash lenkia visus MiniMax vidinius modelius AutomationBench ir LOCA-Bench 256K testuose, o BankerToolBench jo rodikliai prilygsta Claude Opus 5 modeliui. Ankstyvoji šio modelio versija, pavadinta „Space Bunny Alpha“, jau demonstravo mastelį apdorodama daugiau nei 200 trilijonų tokenų.
Modelio efektyvumo pagrindą sudaro architektūriniai patobulinimai ir kvantizavimo technikos. Tradicinė globalios grupuotos užklausos dėmesio sistema buvo pakeista į retą dėmesį, ribojančią kiekvienam tokenui galimybę apdoroti tik dalį konteksto. Tankūs daugiasluoksniai perceptronai (MLP) palikti tik pirmuose trijuose sluoksniuose, taip sumažinant skaičiavimo apkrovą ir atminties srautus, ypač dirbant su ilgu kontekstiniu įvesties kiekiu.
Be to, MiniMax naudoja agresyvų kvantizavimą: MLP svoriai, dėmesio svoriai, indeksatorius ir bendri ekspertų komponentai yra kvantizuoti iki MXFP8 tikslumo, o maršrutuotų ekspertų svoriai – NVFP4 formatu. Šis metodas leidžia išlaikyti arba net nežymiai pagerinti modelio galimybes, palyginti su nekvantizuotu M3.
Tenstorrent aptarnauja MiniMax M3.1 Flash superklasteryje, sudarytame iš kelių Blackhole Galaxy sistemų. Šios sistemos yra specializuotos ir suskirstytos į duomenų paruošimo (prefill) ir dekodavimo funkcijas, optimizuojant kiekvieną jų darbo krūvį. Prefill apdoroja įeinančius agentų užklausimus per daugelį lustų, užtikrindamas didelį tarpįrenginio pralaidumą, o dekodavimo sistemos generuoja išvesties tokenus nepriklausomai, išlaikydamos reagavimo greitį ilgo prefill proceso metu. Komunikacija tarp lustų vyksta per mažos latencijos Ethernet grandines, o tokie duomenys kaip svoriai ir raktas-reikšmė kešai saugomi įrenginiuose esančioje DRAM ir SRAM atmintyje greičiui užtikrinti.
Svarbi funkcija yra raktas-reikšmės kešų perkėlimas, kuris saugo pakartotinai naudojamus kontekstinius būsenos duomenis didelėse DRAM ir SSD saugyklose (1 TB DRAM ir keli terabaitai SSD kiekvienoje sistemoje), taip sumažinant pasikartojančių skaičiavimų apimtį agentų sąveikų metu.
Tenstorrent tobulinimas grindžiamas SemiAnalysis AgentX kodo-agento įrašais, pagrįstais realaus pasaulio daugiasluoksnių sesijų ir subagentų elgesiu, o ne trumpomis pokalbių testų serijomis.
MiniMax M3.1 Flash modelis šiuo metu prieinamas Tenstorrent debesų konsolėje, leidžiantis kūrėjams eksperimentuoti savo Playground aplinkoje arba integruoti tiesiogiai su agentų sistemomis.
Ši diegimo iniciatyva atspindi pažangios modelių konstrukcijos, aparatinės įrangos optimizacijos ir debesų infrastruktūros sinergiją, orientuotą į praktines DI agentų taikymo sritis, sumažinant sąnaudas ir užtikrinant stiprią veiklą.

Šaltiniai ir originalūs pranešimai
Skaityti originalų šaltinį ↗
Komentarai (0)
Komentarų dar nėra. Pradėkite diskusiją.
Rašyti komentarą
Komentarai publikuojami po moderavimo. Jūsų vardas ir komentaras bus vieši. Paskyra