
Tenstorrent lanserer MiniMax M3.1 Flash AI-modell på skyen med forbedret effektivitet
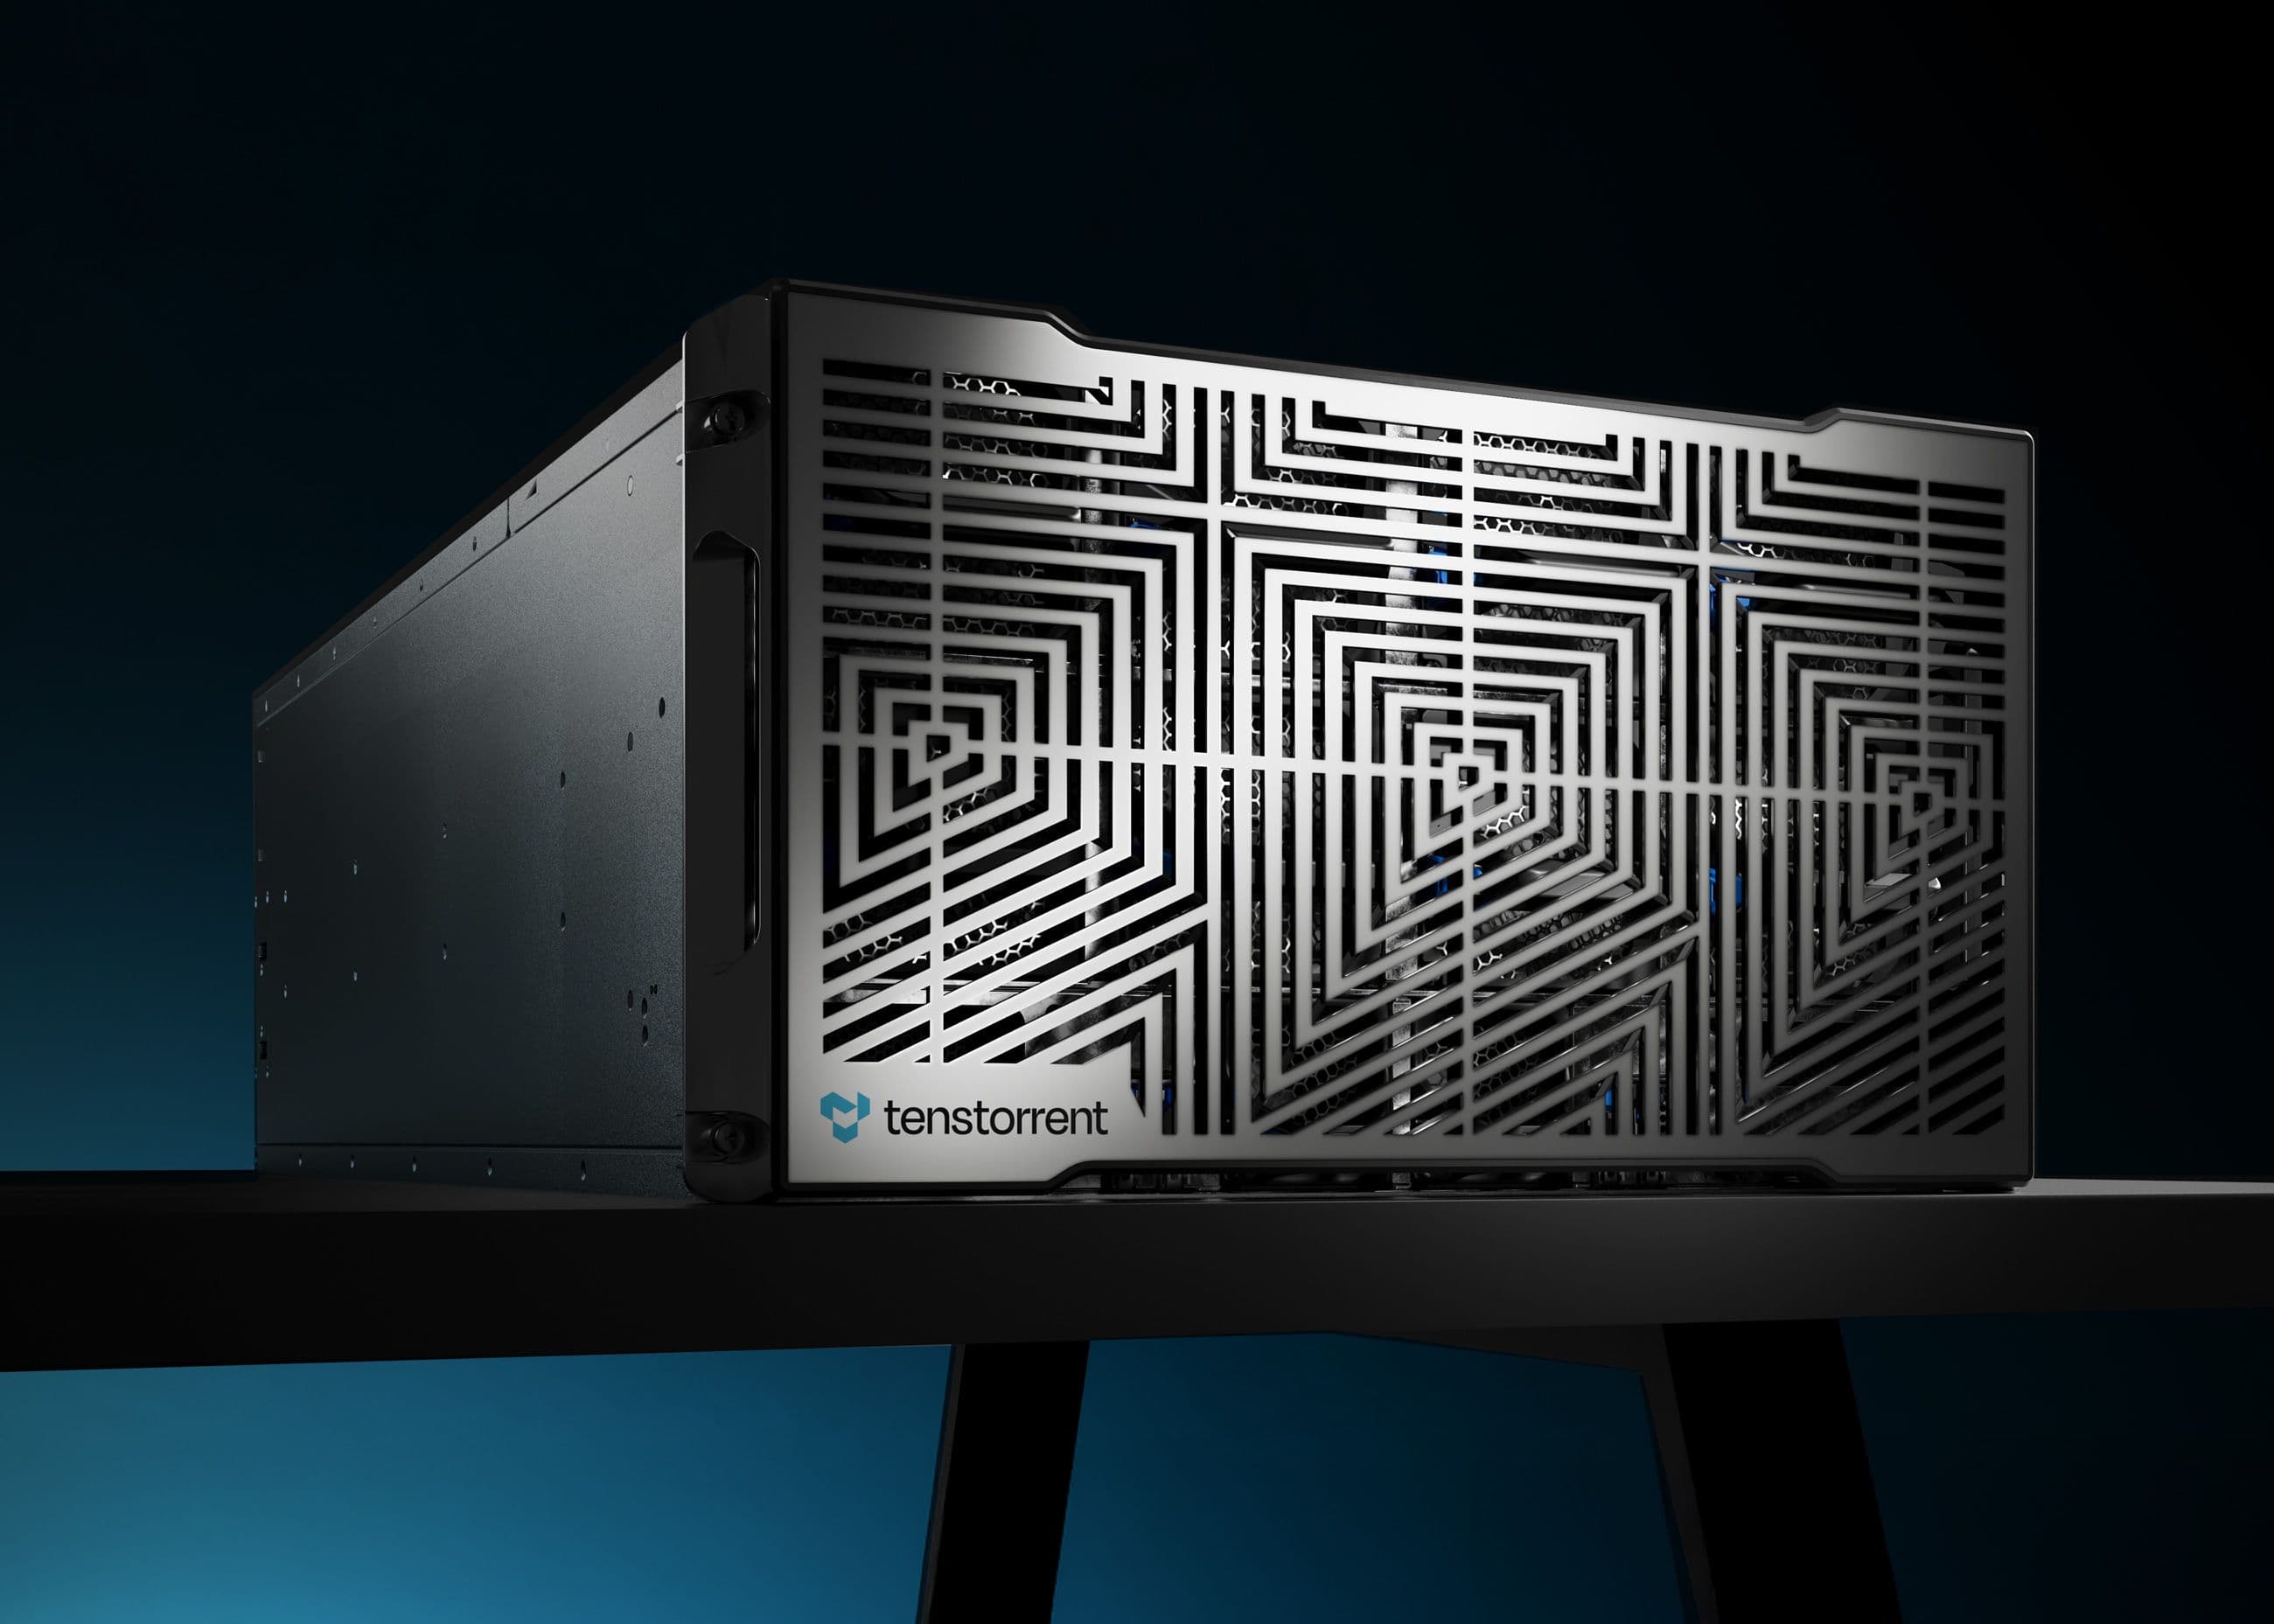
Bilde: Tenstorrent · Kilde
Tenstorrent tilbyr nå MiniMax M3.1 Flash-modellen på sin skyplattform, med betydelige kostnadsreduksjoner og sterk ytelse på agentoppgaver gjennom arkitektoniske innovasjoner og modellkvantisering.
Tenstorrent kunngjorde at de har distribuert MiniMax M3.1 Flash AI-modellen på sin skyplattform, hvor både prefill- og dekodeprosesser kjører på deres egenutviklede Galaxy® superklyngeinfrastruktur. MiniMax slapp samtidig modellens åpne vekter, som gir brukere mulighet til å utnytte denne avanserte AI-en for ulike applikasjoner.
MiniMax M3.1 Flash er designet for produksjonsskala agentoppgaver og oppnår omtrent 70 % lavere driftskostnader sammenlignet med forgjengeren MiniMax M3. Spesifikt reduseres kostnaden per million inndata-token til 0,15 dollar og utdata-token til 0,60 dollar, noe som representerer halvparten av prisen på den forrige modellen. Kostnaden for bufrede inndata-token er enda lavere, med 0,015 dollar per million tokens.
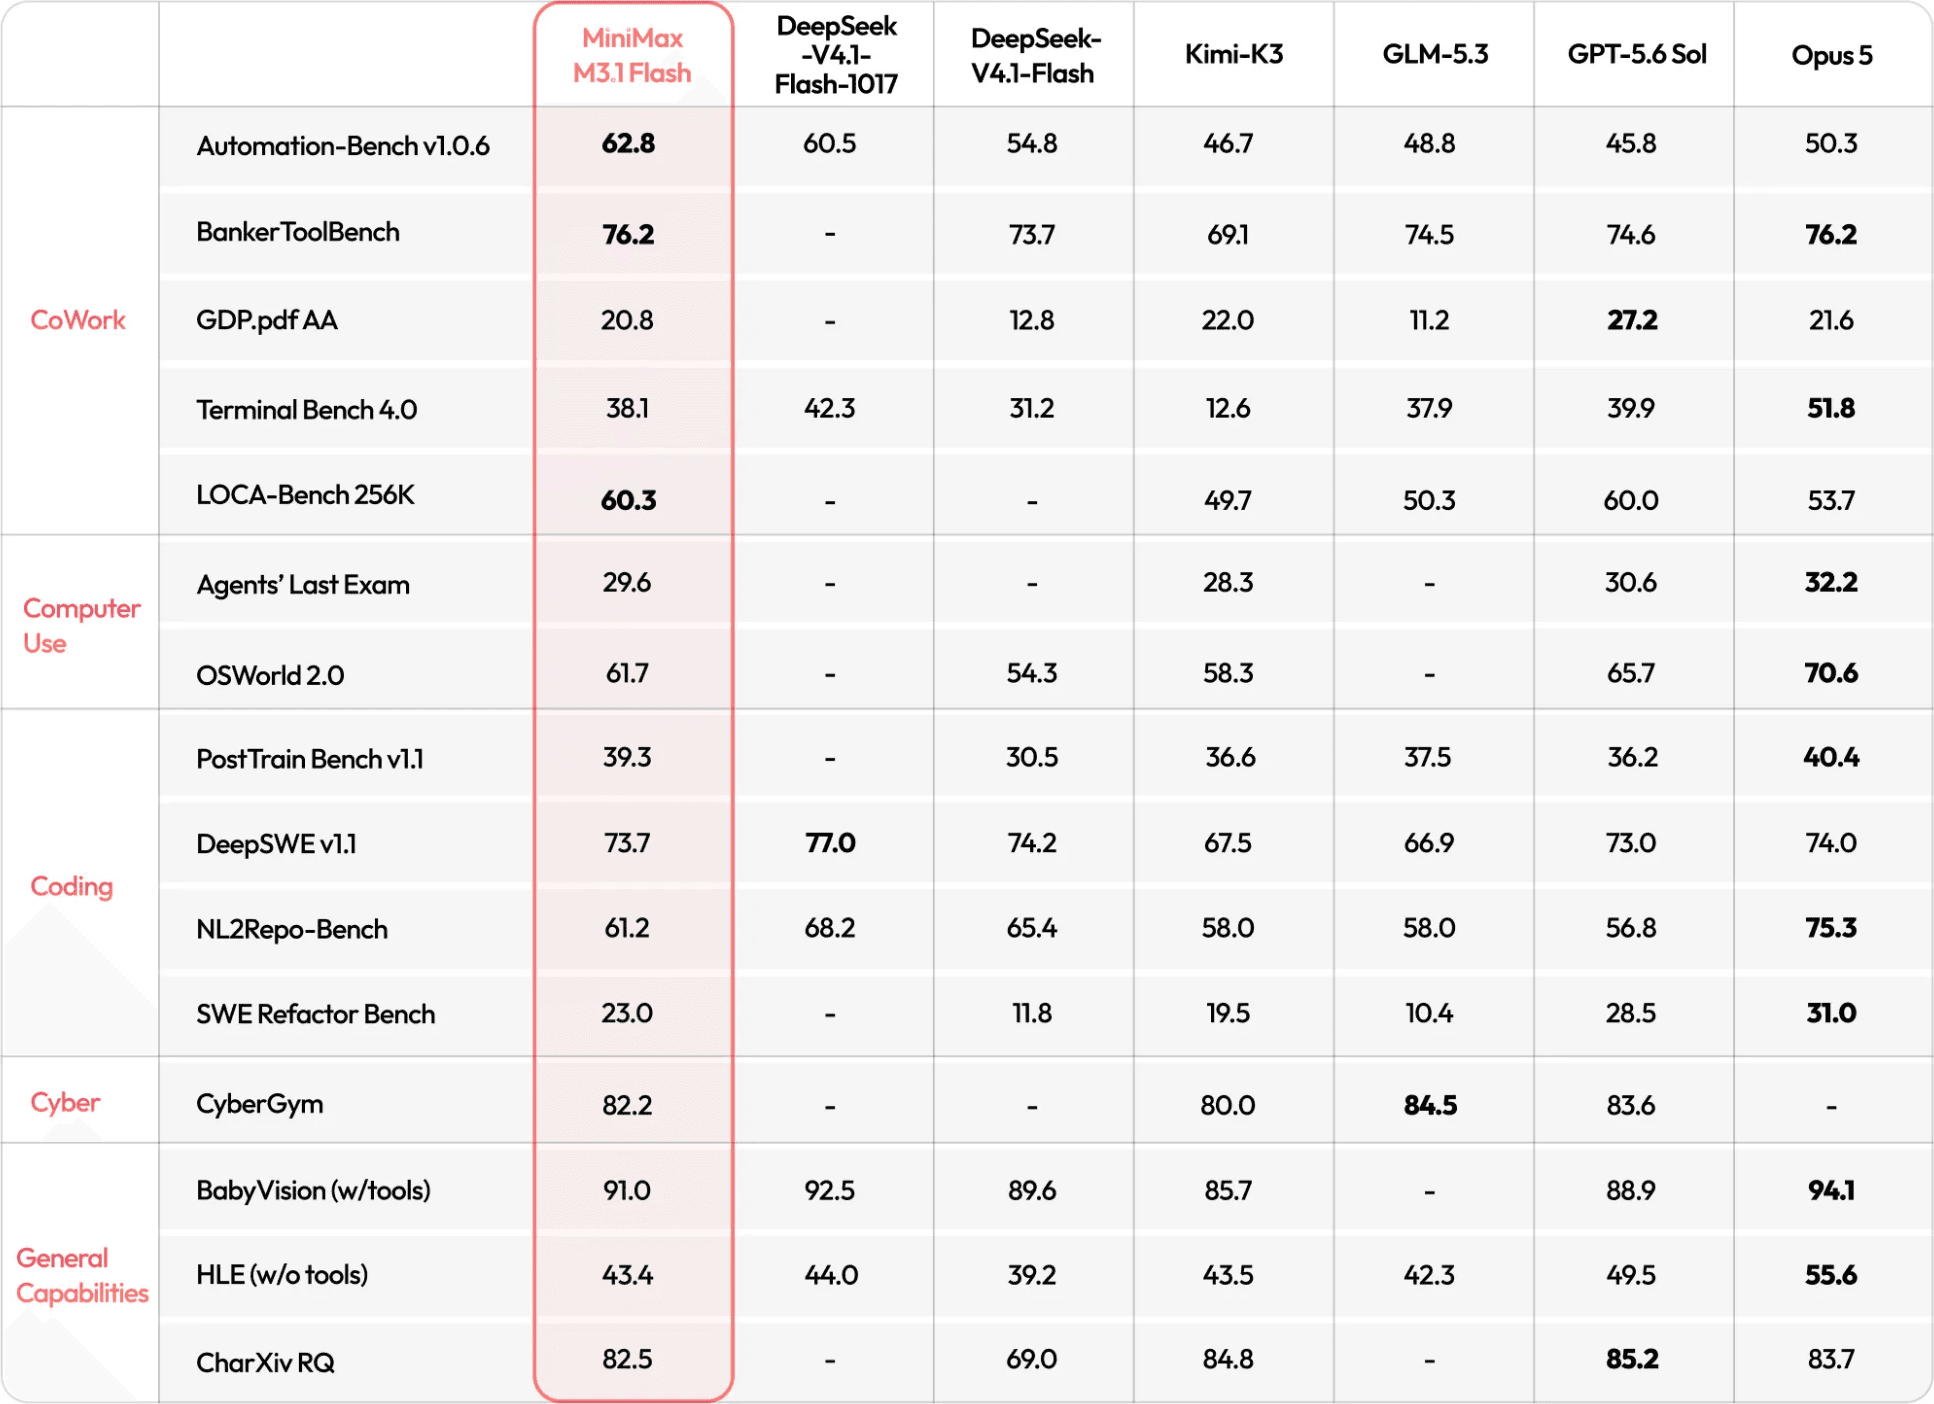
Ytelsestester plasserer MiniMax M3.1 Flash foran alle modeller i MiniMax interne sammenligninger på AutomationBench og LOCA-Bench 256K, og den matcher Claude Opus 5 på BankerToolBench. En tidlig versjon av modellen, kalt "Space Bunny Alpha", har allerede vist skalerbarhet ved å bearbeide over 200 billioner tokens.
Nøkkelen til modellens effektivitet er arkitektoniske forbedringer og kvantiseringsmetoder. Den tradisjonelle globale gruppe-spørringsoppmerksomhetsmekanismen ble erstattet med sparsommelig oppmerksomhet, som begrenser hver token til bare å lese en del av konteksten. Tette multilagsperceptroner (MLPer) beholdes bare i de første tre lagene, noe som reduserer beregningsbelastning og minnetrafikk, spesielt for lange kontekstinnganger.
I tillegg benytter MiniMax aggressiv kvantisering: MLP-vekter, oppmerksomhetsvekter, indeksatoren og delte ekspertkomponenter er kvantisert til MXFP8-presisjon, mens routede ekspertvekter bruker NVFP4. Denne tilnærmingen tillater å opprettholde eller lett forbedre modellens evner sammenlignet med den ukvantiserte M3.
Tenstorrent leverer MiniMax M3.1 Flash på en superklynge bestående av flere Blackhole Galaxy-systemer. Disse er spesialiserte og delt inn i prefill- og dekodefunksjoner, optimalisert for hver sin arbeidsmengde. Prefill håndterer innkommende agentspørsmål over mange brikker med høy båndbredde mellom enhetene, mens dekodesystemer genererer utgangstoken uavhengig og sikrer responsivitet under lange prefill-operasjoner. Kommunikasjon mellom brikker skjer via lav-latens Ethernet-pipelines, og data som vekter og nøkkel-verdi-cacher lagres i enhetens DRAM og SRAM for hurtighet.
En bemerkelsesverdig funksjon er nøkkel-verdi cache-offload, som lagrer gjenbrukte kontekstuelle tilstander i store DRAM- og SSD-pooler (1 TB DRAM og flere terabyte SSD per system), og minimerer redundante beregninger ved gjentatte agentinteraksjoner.
Tenstorrents tuning utnytter SemiAnalysis’s AgentX-kodingsagentspor hentet fra virkelige flerturssessioner og subagentatferd, i stedet for å basere seg på korte chat-benchmarks.
MiniMax M3.1 Flash-modellen er for øyeblikket tilgjengelig via Tenstorrents skyløsning, som lar utviklere eksperimentere i deres Playground-miljø eller integrere direkte med agentrammeverk.
Denne utrullingen eksemplifiserer synergien mellom avansert modellutforming, maskinvareoptimalisering og skyinfrastruktur, med mål om praktiske AI-agentapplikasjoner med redusert kostnad og sterk ytelse.

Kilder og originalrapportering
Les originalkilden ↗
Kommentarer (0)
Ingen kommentarer ennå. Start diskusjonen.
Skriv en kommentar
Kommentarer publiseres etter moderering. Ditt navn og kommentar vil være synlige offentlig. Konto