
Tenstorrent Startet MiniMax M3.1 Flash KI-Modell in der Cloud mit Verbesserter Effizienz
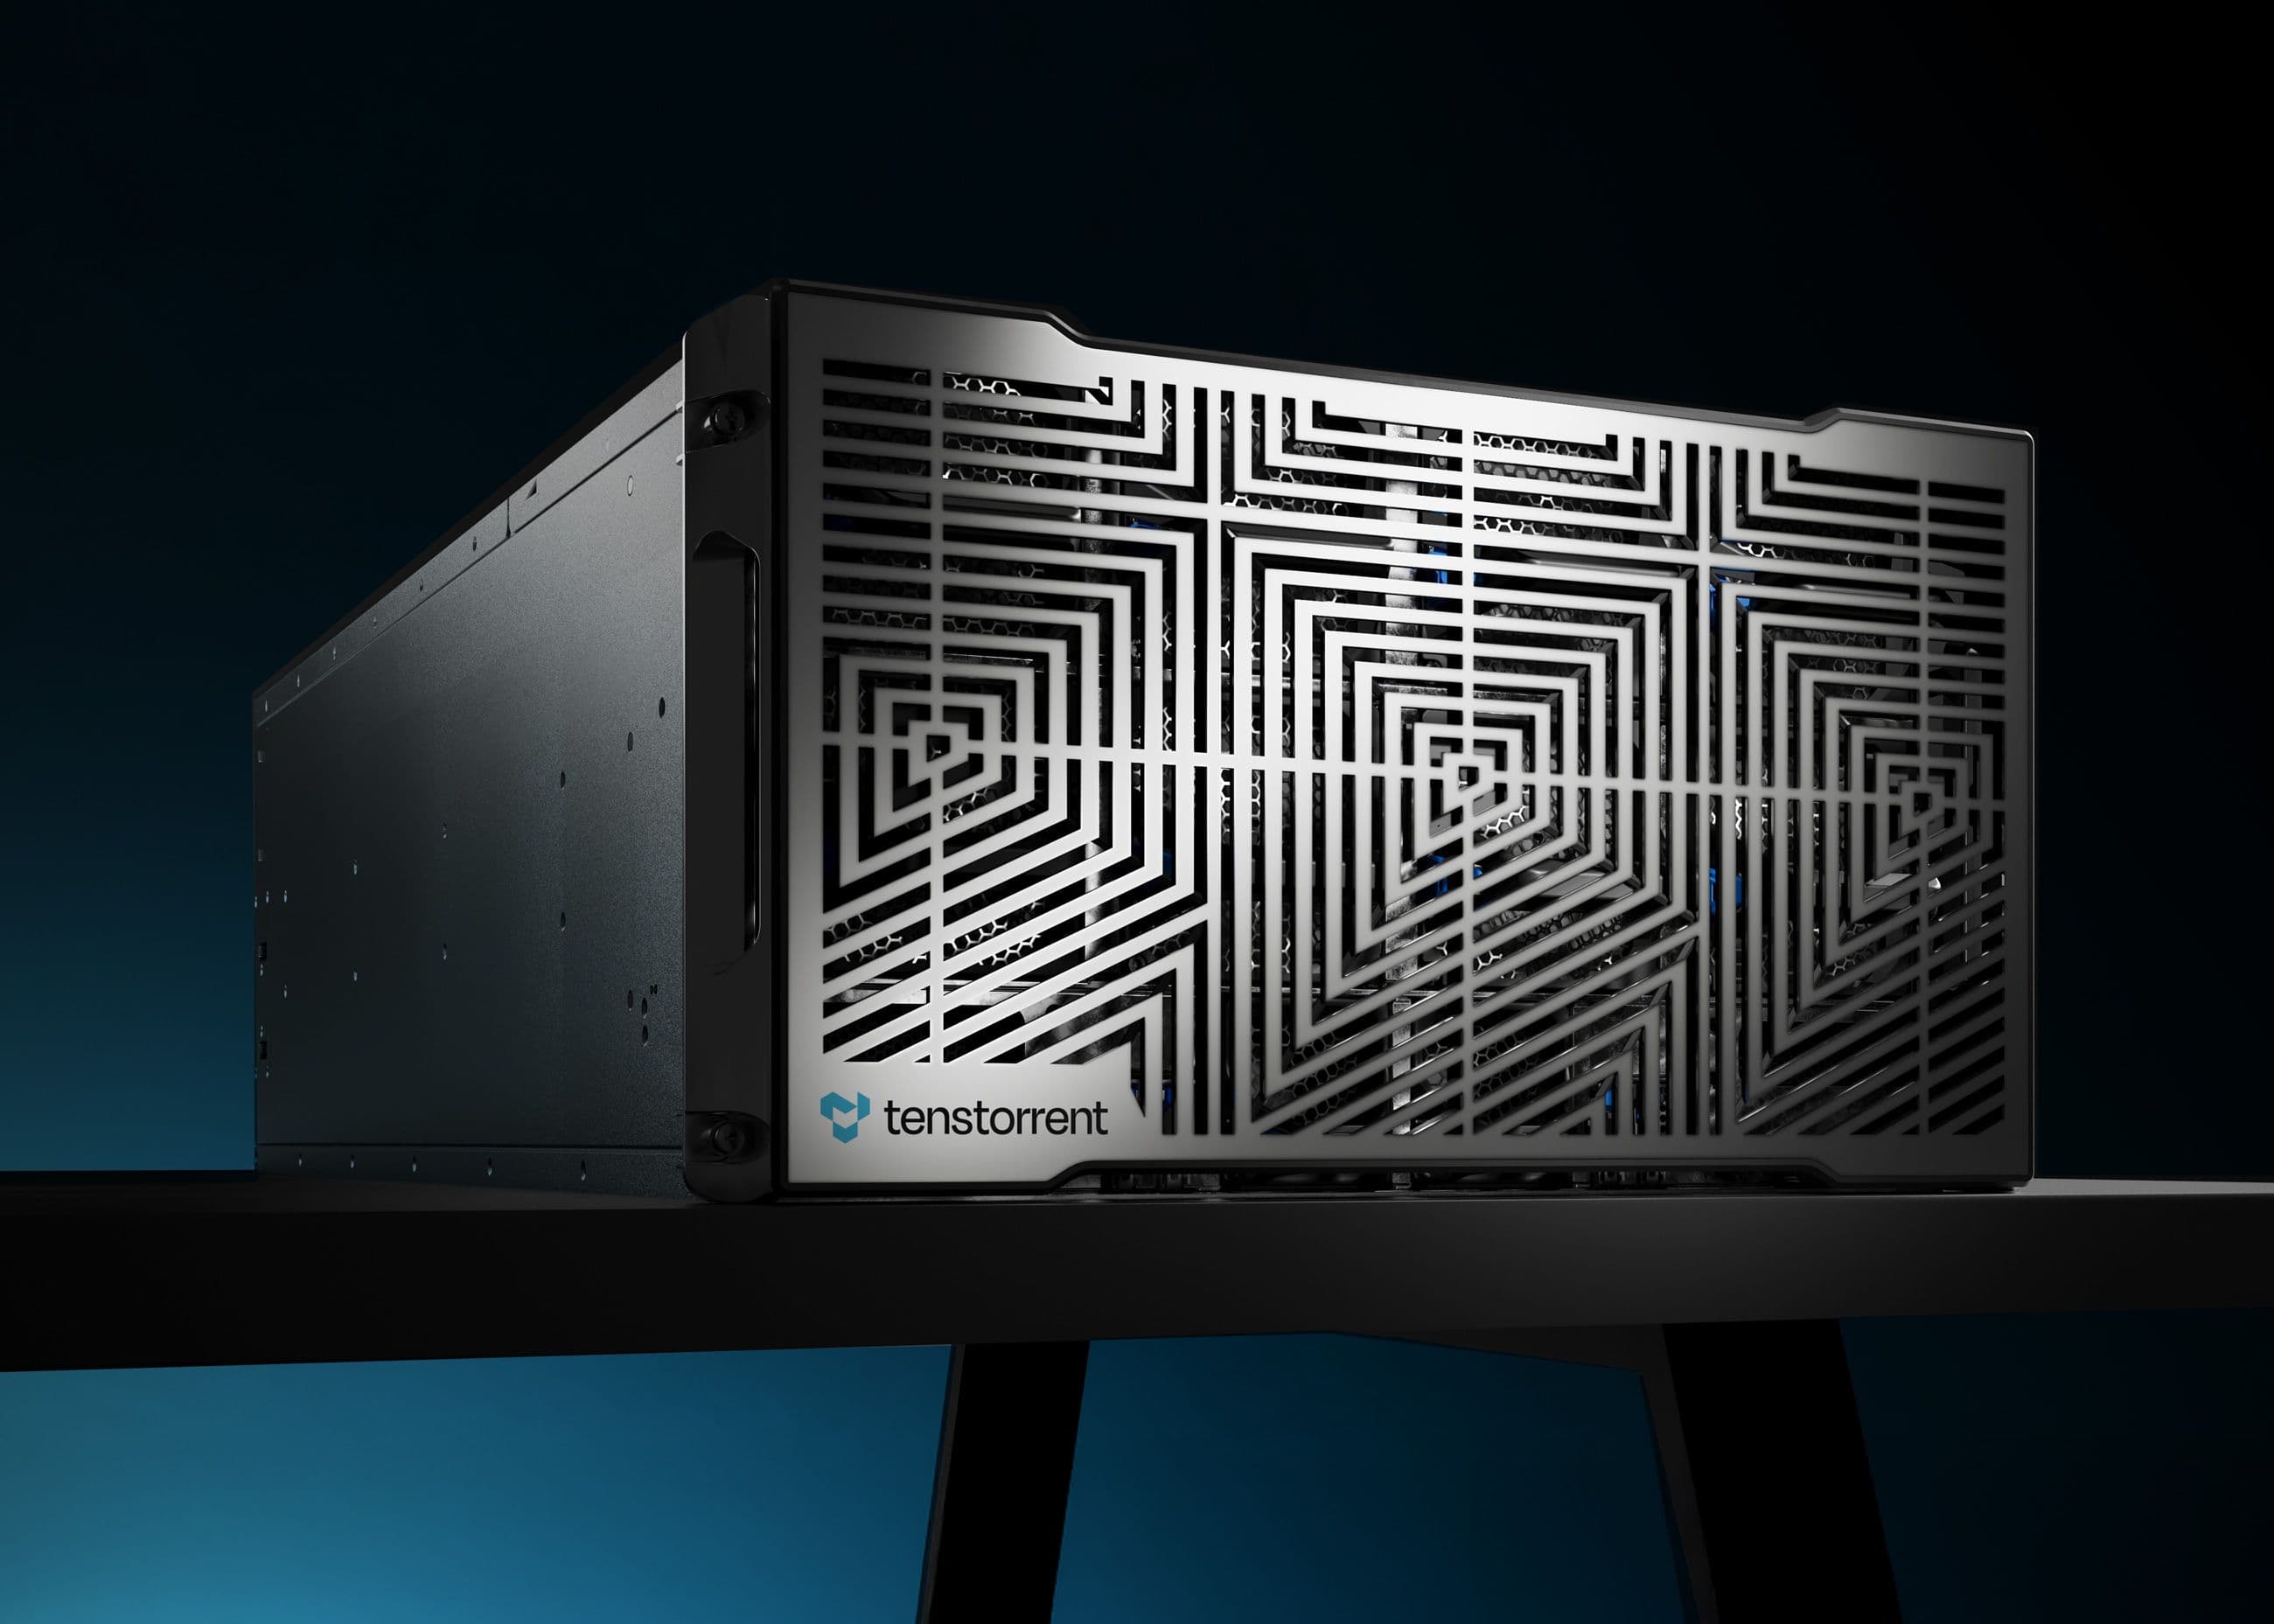
Image: Tenstorrent · Source
Tenstorrent bietet nun das MiniMax M3.1 Flash Modell auf seiner Cloud-Plattform an und ermöglicht erhebliche Kosteneinsparungen sowie starke Leistung bei Agentenaufgaben durch architektonische Innovationen und Modellquantisierung.
Tenstorrent gab bekannt, dass das MiniMax M3.1 Flash KI-Modell auf seiner Cloud-Plattform bereitgestellt wird und sowohl die Prefill- als auch die Decode-Prozesse auf der firmeneigenen Galaxy® Supercluster-Infrastruktur ausführt. MiniMax veröffentlichte gleichzeitig die offenen Gewichte des Modells, wodurch Nutzer diese fortschrittliche KI für verschiedene Anwendungen einsetzen können.
MiniMax M3.1 Flash ist für produktionsskalierte Agentenaufgaben konzipiert und erreicht etwa 70 % geringere Betriebskosten im Vergleich zum Vorgänger MiniMax M3. Konkret werden die Kosten pro Million Eingabe-Tokens auf 0,15 US-Dollar und für Ausgabe-Tokens auf 0,60 US-Dollar gesenkt, was der Hälfte des Preises des vorherigen Modells entspricht. Für zwischengespeicherte Eingabe-Tokens liegen die Kosten sogar noch niedriger bei 0,015 US-Dollar pro Million Tokens.
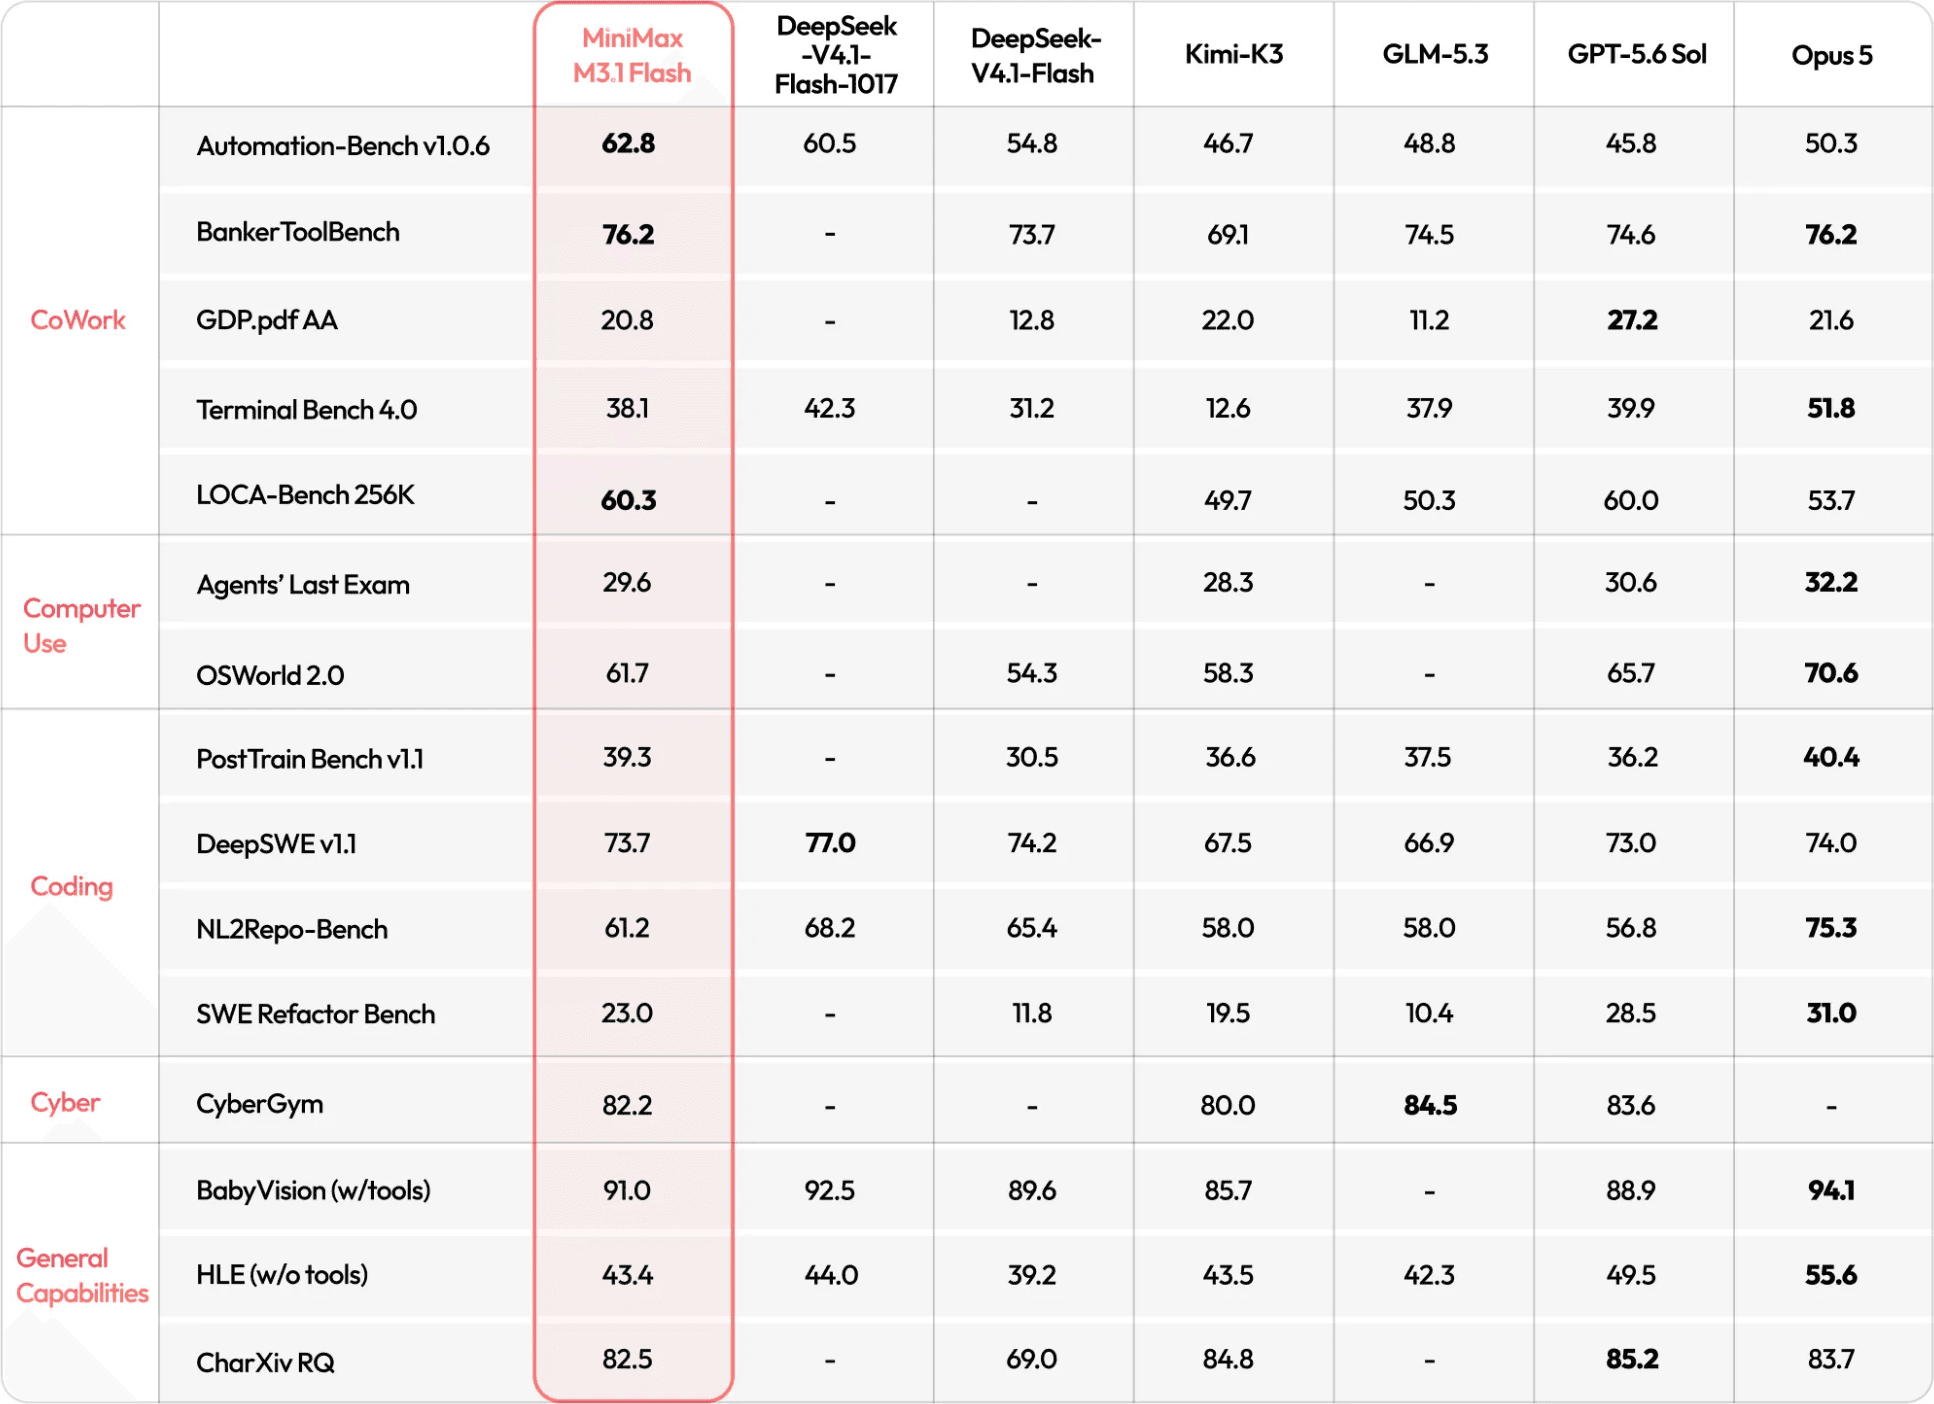
Leistungsbenchmarks positionieren MiniMax M3.1 Flash vor allen Modellen in MiniMaxs internen Vergleichen bei AutomationBench und LOCA-Bench 256K, und es entspricht Claude Opus 5 bei BankerToolBench. Eine frühe Iteration dieses Modells, genannt „Space Bunny Alpha“, zeigte bereits Skalierbarkeit beim Verarbeiten von über 200 Billionen Tokens.
Wesentlich für die Effizienz des Modells sind architektonische Verbesserungen und Quantisierungstechniken. Der traditionelle globale gruppenbasierte Query-Attention-Mechanismus wurde durch spärliche Attention ersetzt, wodurch jeder Token nur einen Teil des Kontexts liest. Dichte Mehrschicht-Perzeptronen (MLPs) werden nur in den ersten drei Schichten beibehalten, was den Rechenaufwand und den Speicherverkehr insbesondere bei langen Kontexten reduziert.
Zusätzlich setzte MiniMax eine aggressive Quantisierung ein: MLP-Gewichte, Attention-Gewichte, der Indexer und gemeinsame Expertenkomponenten wurden auf MXFP8-Präzision quantisiert, während geroutete Expertengewichte NVFP4 verwenden. Dieser Ansatz erlaubt es, die Fähigkeiten des Modells im Vergleich zum nicht quantisierten M3 beizubehalten oder leicht zu verbessern.
Tenstorrent stellt MiniMax M3.1 Flash auf einem Supercluster bereit, der aus mehreren Blackhole Galaxy-Systemen besteht. Diese sind spezialisiert und in Prefill- und Decode-Funktionen unterteilt, um jeweils für ihre Arbeitslast optimiert zu sein. Prefill verarbeitet eingehende Agentenaufforderungen über viele Chips mit hoher Inter-Chip-Bandbreite, während Decode-Systeme Ausgabetokens unabhängig erzeugen und so Reaktionsfähigkeit während langer Prefill-Operationen gewährleisten. Die Kommunikation zwischen den Chips erfolgt über latenzarme Ethernet-Pipelines, und Daten wie Gewichte und Schlüssel-Wert-Caches werden in On-Device DRAM und SRAM für Geschwindigkeit gespeichert.
Eine bemerkenswerte Funktion ist das Key-Value-Cache-Offload, das wiederverwendete Kontextzustände in großen DRAM- und SSD-Pools (1 TB DRAM und mehrere Terabyte SSD pro System) speichert und somit redundante Berechnungen bei wiederholten Agenteninteraktionen minimiert.
Tenstorrents Feintuning nutzt AgentX-Coding-Agent-Spuren von SemiAnalysis, die aus realen Multi-Turn-Sitzungen und Subagentenverhalten stammen, anstatt sich auf kurze Chat-Benchmarks zu stützen.
Das MiniMax M3.1 Flash Modell ist derzeit über die Cloud-Konsole von Tenstorrent zugänglich, sodass Entwickler im Playground-Umfeld experimentieren oder es direkt in Agenten-Frameworks integrieren können.
Diese Bereitstellung demonstriert die Synergie zwischen fortschrittlichem Modelldesign, Hardware-Optimierung und Cloud-Infrastruktur, mit Fokus auf praktische KI-Agenten-Anwendungen bei reduzierten Kosten und starker Leistung.

Quellen und Originalberichte
Read the original source ↗
Kommentare (0)
Noch keine Kommentare.
Kommentar schreiben
Kommentare erscheinen nach Moderation. Name und Kommentar werden öffentlich angezeigt. Konto