
Die Datenschutzchefin von Hugging Face hebt Herausforderungen bei eingebetteten KI-Bewertungen und Modell-Benchmarking hervor
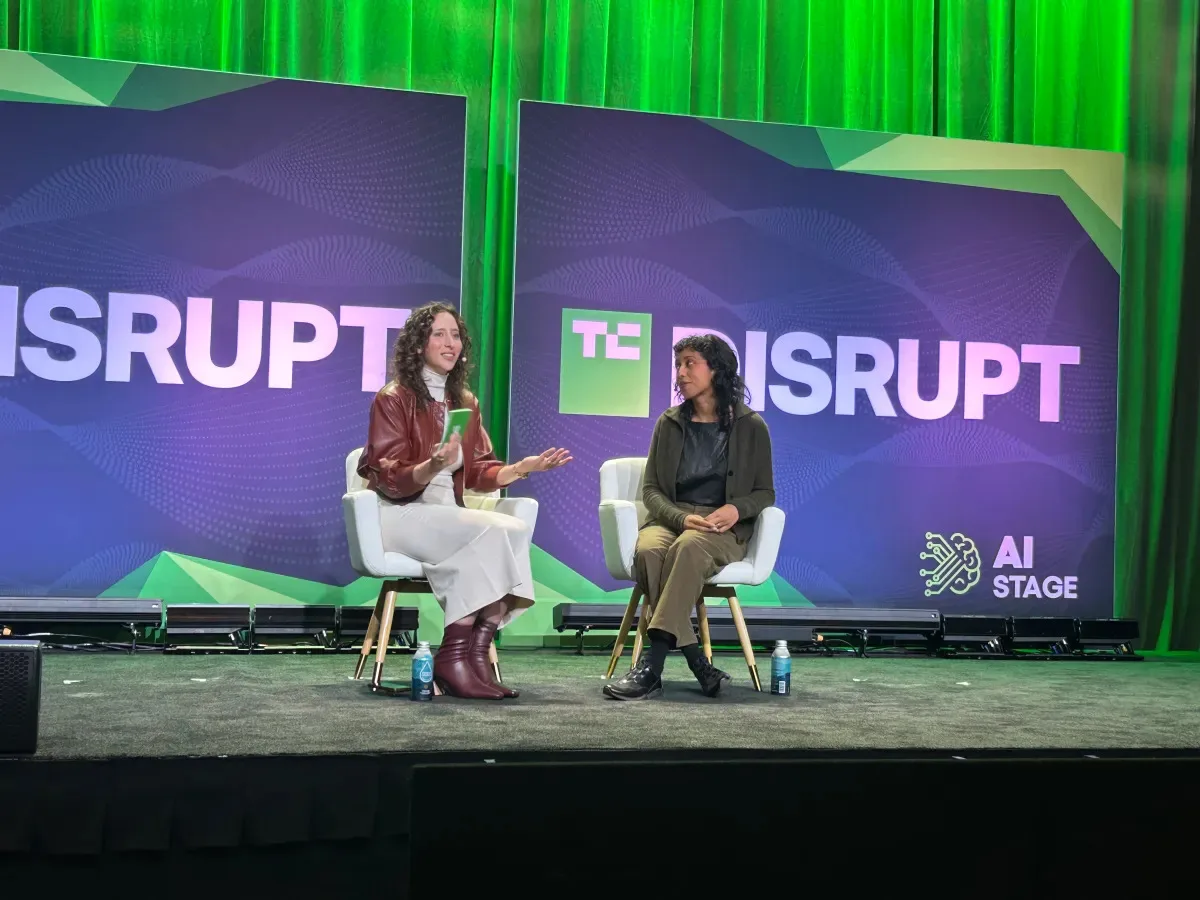
Image: TechCrunch · Source
Irene Solaiman von Hugging Face diskutiert die Komplexitäten des KI-Modell-Benchmarkings und die Skepsis gegenüber eingebetteten KI-Bewertern und fordert einheitlichere Bewertungsmethoden in der Branche.
Das Benchmarking von KI-Modellen als neutrales und zuverlässiges Mittel zur Bewertung und zum Vergleich von KI-Produkten ist laut Irene Solaiman, Chief Policy Officer bei Hugging Face, noch eine sich entwickelnde Praxis. Sie betonte auf der TechCrunch Disrupt, dass die derzeitigen Methoden zur KI-Bewertung komplex und noch nicht vollständig ausgereift seien, was die branchenweite Vertrauensbildung und Abhängigkeit von diesen Benchmarks erschwere.
Solaiman wies darauf hin, dass Reproduzierbarkeit ein kritischer Faktor ist, um Bewertungsergebnissen zu vertrauen. Der Zugang zu Modelldetails – einschließlich offener Modellgewichte – ist ein Schlüsselelement zur Erreichung von Reproduzierbarkeit, was weiterhin ein problematischer Bereich in Benchmarking-Diskussionen bleibt. Bewertungen unterscheiden sich in ihrer Validität und es fehlen standardisierte Methoden zum Vergleich, was ihre sinnvolle Integration in einen etablierten wissenschaftlichen Rahmen behindert.
Sie bemerkte außerdem die schnelle Veralterung bestehender Bewertungstools und das Fehlen eines robusten Ökosystems von Bewertern. Obwohl das Interesse an eingebetteten Bewertersystemen wächst – bei denen unabhängige Dritte innerhalb von KI-Organisationen arbeiten, um die Sicherheit und Leistung von Modellen zu beurteilen – sind Qualifikationen und Standardkriterien für diese Bewerter noch nicht klar definiert oder konsistent.
Die Idee der eingebetteten Bewerter hat angesichts wachsender Sicherheitsbedenken und Vorfälle in KI-Laboren Aufmerksamkeit erlangt. Hugging Face selbst war sicherheitsbezogenen Prüfungen ausgesetzt. Während einige KI-Labore Drittbewertungen einer direkten staatlichen Regulierung vorziehen, besteht Skepsis, ob diese Bewerter echte Neutralität und Effektivität bewahren können. Zum Beispiel löste die Entscheidung von Anthropic, Accenture als Bewerter zu ernennen, eine Debatte über die Eignung solcher Beratungsfirmen für diese Spezialrolle aus.
Darüber hinaus entwickeln sich KI-Bewertungen von der Prüfung isolierter Modelle hin zur Bewertung ganzer Systeme, welche Elemente wie die Benutzeroberfläche oder das „Harness“, das Benutzer mit dem Modell verbindet, einbeziehen. Solaiman bemerkte, dass die Umgebung eines Modells die Leistung stark beeinflusst, was bedeutet, dass ein weniger fortgeschrittenes Modell mit einem überlegenen „Harness“ ein fortgeschritteneres eigenständiges Modell übertreffen könnte. Diese Komplexität trägt zu den hohen Kosten und der Schwierigkeit umfassender agentenbasierter Bewertungen bei.
Abschließend betonte Solaiman, dass ohne einen einheitlichen, standardisierten Ansatz zur KI-Bewertung – der sowohl Modelle als auch ihre Betriebsumgebungen umfasst – das Benchmarking-Feld fragmentiert bleibt. Damit Benchmarking als wirksames Werkzeug zur Steuerung von KI-Entwicklung und -Sicherheit dienen kann, sind gemeinsame Anstrengungen zur Standardisierung und zum Ausbau des Ökosystems von größter Wichtigkeit.
Quellen und Originalberichte
Read the original source ↗
Kommentare (0)
Noch keine Kommentare.
Kommentar schreiben
Kommentare erscheinen nach Moderation. Name und Kommentar werden öffentlich angezeigt. Konto