
Hugging Face'i poliitikajuht tõstab esile sisseehitatud tehisintellekti hindajate ja mudelite võrdluse väljakutseid
Pilt: TechCrunch · Allikas
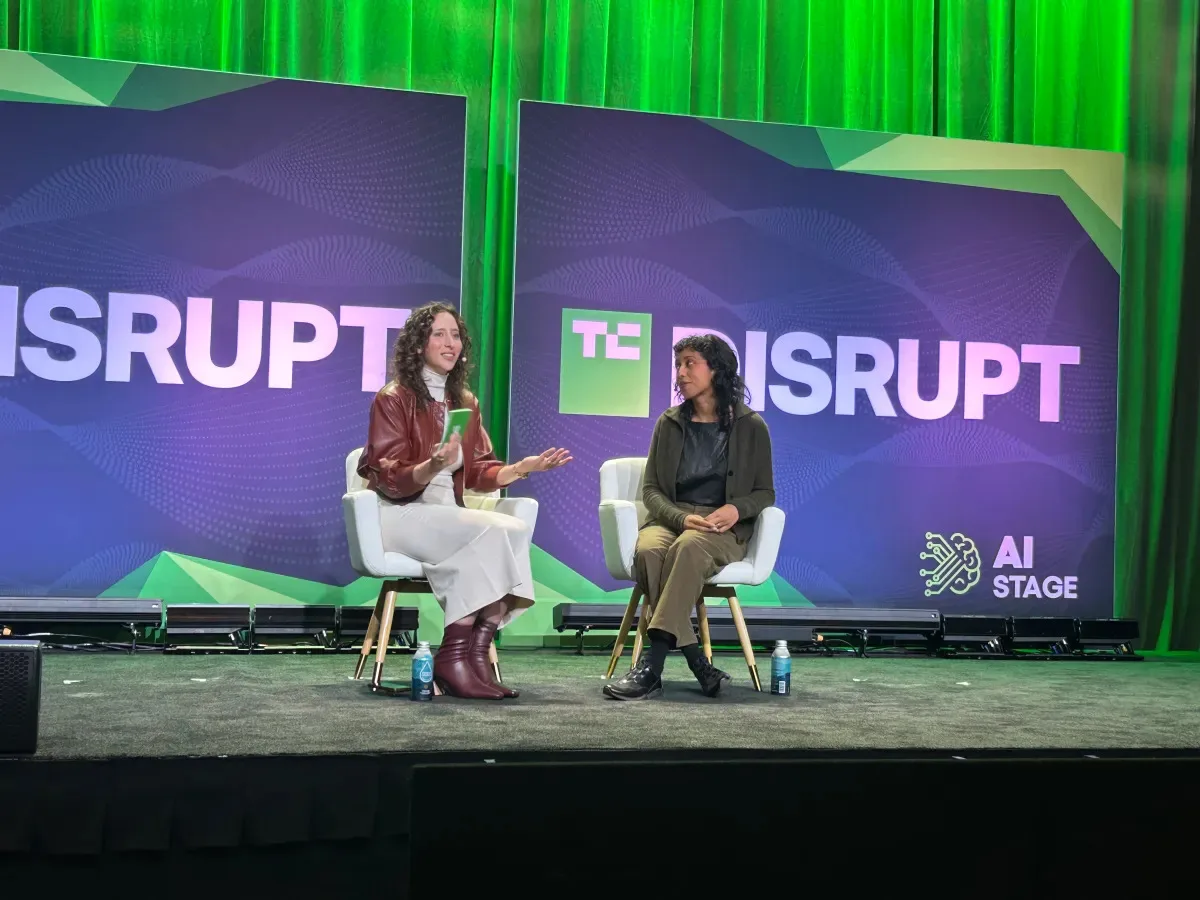
Irene Solaiman Hugging Face'ist arutleb tehisintellekti mudelite võrdlemise keerukuse ning sisseehitatud hindajate skeptilise suhtumise üle ning kutsub tööstust üles kasutama rohkem standardiseeritud hindamismeetodeid.
Tehisintellekti mudelite võrdlemist kui neutraalset ja usaldusväärset vahendit tehisintellekti toodete hindamiseks ja võrdlemiseks võib pidada endiselt arenevaks praktikaks, ütles Irene Solaiman, Hugging Face'i peapoliitikajuht. Esinedes TechCrunch Disruptil rõhutas ta, et praegused tehisintellekti hindamismeetodid on keerulised ja veel mitte täielikult välja arenenud, mistõttu on kogu tööstushanale nende hinnangute usaldamine ja toetumine keeruline.
Solaiman tõi välja, et hindamistulemuste usaldusväärsuse üks oluline aspekt on reprodutseeritavus. Mudeli detailidele ligipääs — sealhulgas avatud mudelikaalude olemasolu — on reprodutseeritavuse saavutamiseks võtmetähtsusega, kuid see valdkond tehisintellekti võrdluses on endiselt problemaatiline. Hindamismeetodid erinevad kehtivuse poolest ning standardiseeritud võrdlusmeetodite puudumine takistab nende sisukat integreerimist teaduslikku raamistikku.
Ta märkis ka olemasolevate hindamisvahendite kiiret vananemist ning hindajate tugeva ökosüsteemi puudumist. Kuigi huvi sisseehitatud hindajate süsteemide vastu kasvab — kus sõltumatud kolmandate osapoolte hindajad töötavad tehisintellekti organisatsioonides mudelite ohutuse ja jõudluse hindamiseks — pole nende hindajate kvalifikatsioon ja standardkriteeriumid veel selgelt määratletud või ühtlustatud.
Sisseehitatud hindajate idee on tähelepanu saanud tõusvate ohutusprobleemide ja intsidentide tõttu tehisintellekti laborites. Ka Hugging Face on kogenud ohutusega seotud tähelepanu. Kuigi mõned tehisintellekti laborid toetavad kolmandate osapoolte hindamist otsese valitsuse regulatsiooni asemel, valitseb ka skeptilisus selle üle, kas sellised hindajad suudavad säilitada tõelist neutraalsust ja efektiivsust. Näiteks tekitas Anthropic otsus määrata evaluatoriks Accenture debati selle üle, kas konsultatsioonifirmad sobivad selliseks spetsialiseeritud rolliks.
Lisaks arenevad tehisintellekti hindamised mudelite eraldiseisvast testimisest kogu süsteemi hindamise suunas, mis hõlmab ka kasutajaliidest või mudeliga ühendusvahendit. Solaiman märkis, et mudeli lähtekeskkond mõjutab jõudlust oluliselt, mis tähendab, et madalama taseme mudel võib koos kvaliteetsema ühendusvahendiga ületada võimsamat iseseisvat mudelit. See keerukus suurendab agentidepõhiste hindamiste kõrgeid kulusid ja raskusi.
Kokkuvõtteks rõhutas Solaiman, et ilma ühtse ja standardiseeritud lähenemiseta tehisintellekti hindamisele — hõlmates nii mudeleid kui ka nende operatiivset keskkonda — jääb võrdlusvaldkond killustatuks. Selleks, et võrdlus saaks olla tõhus tööriist tehisintellekti arengu ja ohutuse juhtimisel, on vajalikud koostöised jõupingutused standardiseerimise ja ökosüsteemi arendamise suunas.
Allikad ja originaaluudised
Loe originaali allikat ↗
Kommentaarid (0)
Kommentaare veel pole. Alusta arutelu.
Kirjuta kommentaar
Kommentaarid avaldatakse pärast modereerimist. Sinu nimi ja kommentaar on avalikult nähtavad. Konto