
Hugging Facen politiikkajohtaja korostaa haasteita upotetussa tekoälyn arvioinnissa ja mallien vertailussa
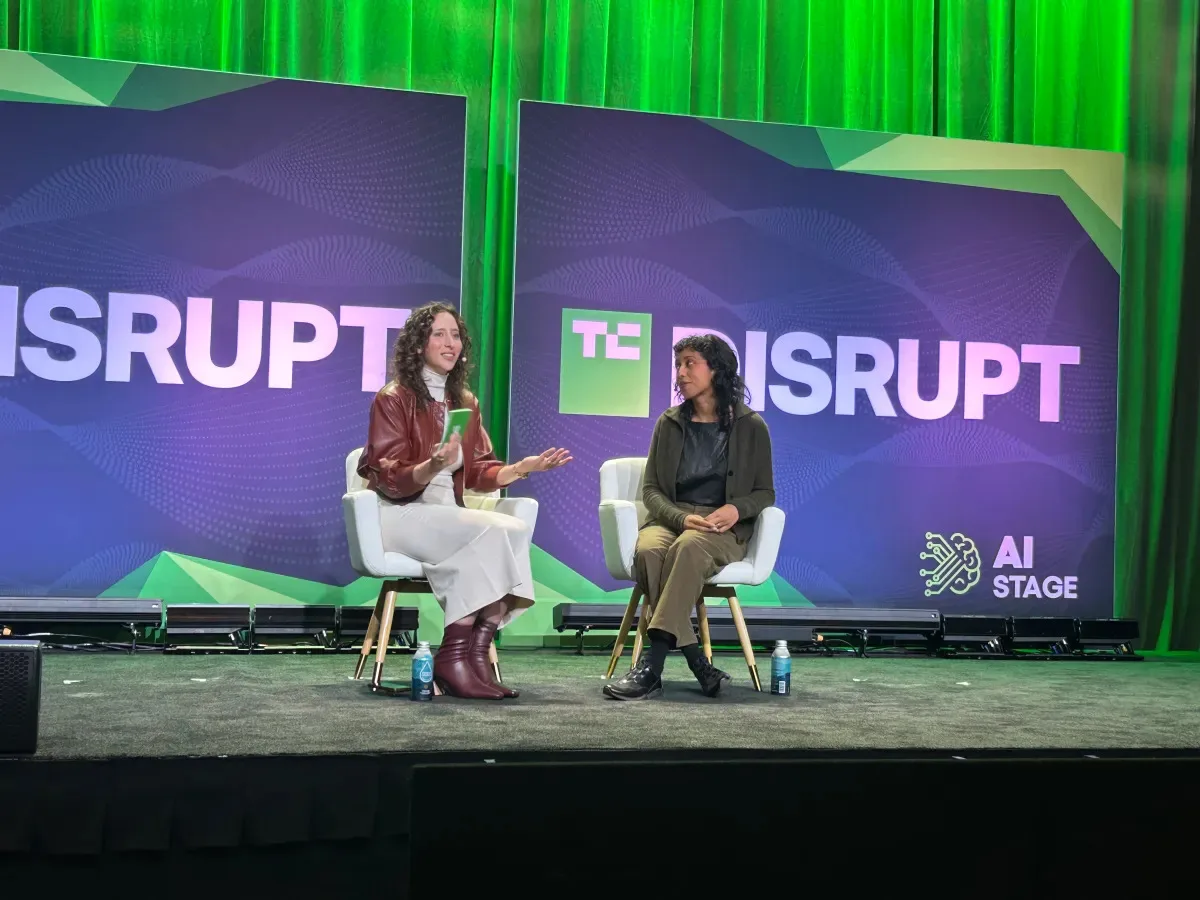
Kuva: TechCrunch · Lähde
Irene Solaiman Hugging Facesta käsittelee tekoälymallien vertailun monimutkaisuutta ja skeptisyyttä upotettujen tekoälyarvioijien ympärillä, ja kehottaa teollisuutta kohti yhtenäisempiä arviointimenetelmiä.
Hugging Facen poliittinen johtaja Irene Solaiman mukaan tekoälymallien vertailu neutraalina ja luotettavana keinona arvioida ja verrata tekoälytuotteita on yhä kehittyvä käytäntö. Hän korosti TechCrunch Disrupt -tapahtumassa, että nykyiset tekoälyn arviointimenetelmät ovat monimutkaisia ja vielä epäkypsiä, mikä vaikeuttaa toimialan laajuista luottamusta ja riippuvuutta näihin vertailutuloksiin.
Solaiman nosti esiin, että arviointitulosten toistettavuus on luottamuksen kannalta kriittinen tekijä. Mallin yksityiskohtiin – mukaan lukien avoimet mallipainot – pääsy on keskeistä toistettavuuden saavuttamiseksi, mikä on edelleen haastava kysymys vertailukeskusteluissa. Arvioinnit vaihtelevat pätevyydeltään, eikä yhteisiä menetelmiä niiden keskinäiseen vertailuun ole, mikä estää niiden merkityksellisen integroinnin vakiintuneeseen tieteelliseen viitekehykseen.
Hän myös kommentoi nykyisten arviointityökalujen nopeaa vanhentumista ja arvioijien vankan ekosysteemin puutetta. Vaikka kiinnostus upotettuihin arviointijärjestelmiin kasvaa – joissa riippumattomat kolmannen osapuolen havainnoijat toimivat tekoälyorganisaatioiden sisällä mallien turvallisuuden ja suorituskyvyn arvioimiseksi – näiden arvioijien pätevyydet ja standardoidut kriteerit eivät vielä ole selkeitä tai yhdenmukaisia.
Upotettujen arvioijien idea on noussut esiin tekoälyn turvallisuushuolien ja laboratoriokohtausten lisääntyessä. Myös Hugging Faceta on tarkasteltu turvallisuuskysymysten vuoksi. Vaikka jotkut tekoälylaboratoriot suosivat kolmannen osapuolen arviointeja suoran valtion sääntelyn sijaan, skeptisyyttä on siitä, voivatko arvioijat säilyttää todellisen puolueettomuuden ja tehokkuuden. Esimerkiksi Anthropicin päätös nimittää Accenture arvioijaksi herätti keskustelua siitä, ovatko konsultointiyritykset sopivia tähän erikoistuneeseen rooliin.
Lisäksi tekoälyn arvioinneissa ollaan siirtymässä erillisten mallien testaamisesta kokonaisjärjestelmien arviointiin, jotka sisältävät esimerkiksi käyttöliittymän tai liitännän, joka yhdistää käyttäjän malliin. Solaiman totesi, että mallin ympäristö vaikuttaa merkittävästi suorituskykyyn, joten vähemmän kehittynyt malli yhdistettynä parempaan liitäntään voi suoriutua paremmin kuin kehittyneempi itsenäinen malli. Tämä monimutkaisuus lisää kattavien agenttipohjaisten arviointien kustannuksia ja vaikeutta.
Lopuksi Solaiman painotti, että ilman yhtenäistä, standardoitua lähestymistapaa tekoälyn arviointiin – joka kattaa sekä mallit että niiden toimintaympäristöt – vertailuala pysyy hajanaisena. Jotta vertailusta voisi tulla tehokas työkalu tekoälyn kehityksen ja turvallisuuden ohjaamiseen, tarvitaan yhteistyötä standardoinnin ja ekosysteemin vahvistamiseksi.
Lähteet ja alkuperäiset raportit
Lue alkuperäinen lähde ↗
Kommentit (0)
Ei vielä kommentteja. Aloita keskustelu.
Kirjoita kommentti
Kommentit julkaistaan moderoinnin jälkeen. Nimesi ja kommenttisi näkyvät julkisesti. Tili