
Глава отдела политики Hugging Face о сложностях встроенных оценщиков ИИ и сравнительном анализе моделей
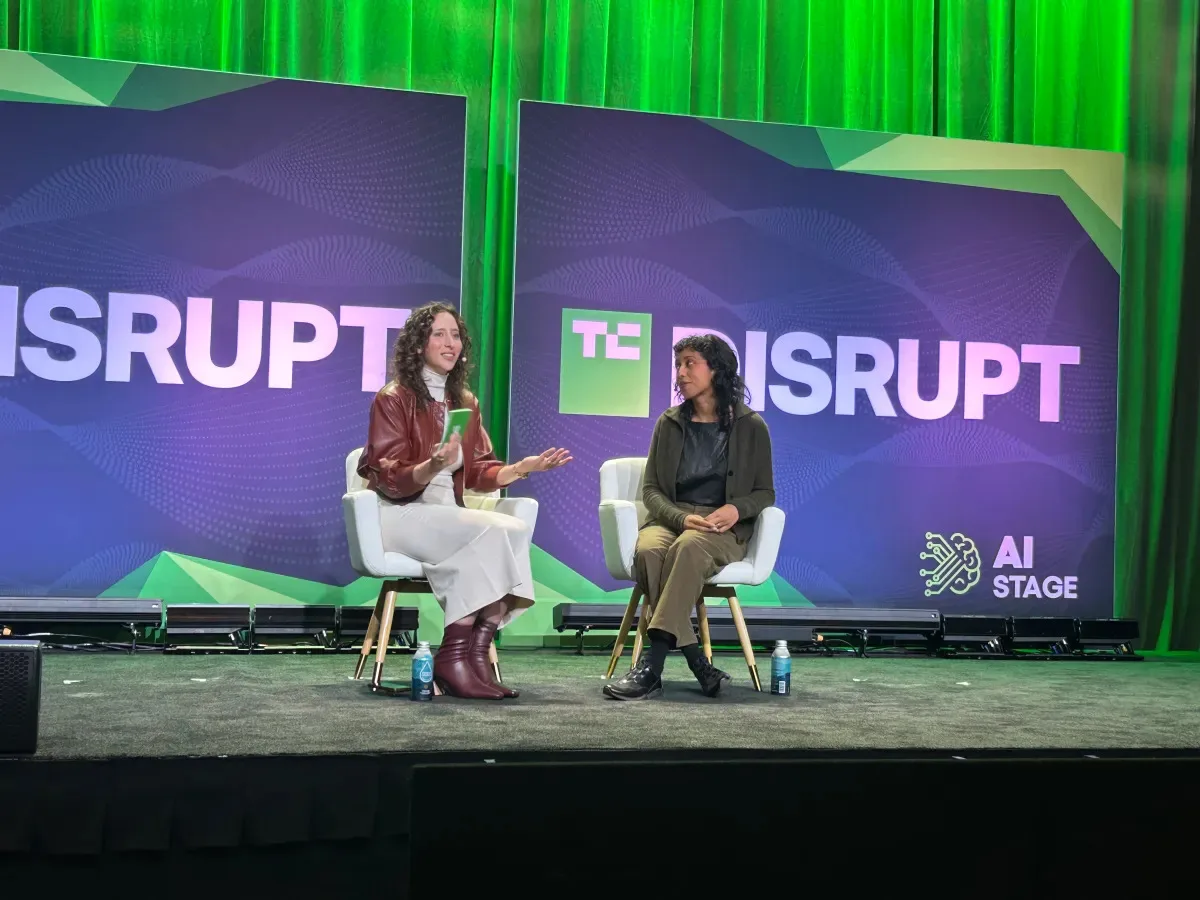
Image: TechCrunch · Source
Ирен Солаиман из Hugging Face обсуждает сложности сравнительного анализа моделей ИИ и скептицизм в отношении встроенных оценщиков ИИ, призывая к более стандартизированным методам оценки в отрасли.
Сравнительный анализ моделей ИИ как нейтральный и надёжный способ оценки и сравнения продуктов ИИ всё ещё находится в стадии развития, отмечает Ирен Солаиман, главный специалист по политике в Hugging Face. Выступая на TechCrunch Disrupt, она подчеркнула, что текущие методы оценки ИИ сложны и ещё не полностью зрелы, что затрудняет формирование отраслевого доверия и опоры на данные бенчмарки.
Солаиман указала, что воспроизводимость является критическим фактором доверия к результатам оценки. Доступ к деталям модели — включая открытые веса модели — является ключевым элементом для достижения воспроизводимости, что остаётся проблемной областью в обсуждениях сравнительного анализа. Методы оценки различаются по валидности и лишены стандартизированных подходов для взаимного сравнения, что препятствует их значимой интеграции в устоявшуюся научную рамку.
Она также отметила быструю устарелость существующих инструментов оценки и отсутствие развитой экосистемы оценщиков. Хотя растёт интерес к системам встроенных оценщиков — где независимые наблюдатели от третьих сторон работают внутри организаций ИИ для оценки безопасности и производительности моделей — квалификации и стандартные критерии для таких оценщиков пока не чётко определены и не согласованы.
Идея встроенных оценщиков привлекла внимание на фоне растущих опасений по безопасности и инцидентов в AI-лабораториях. Сам Hugging Face сталкивался с проверками, связанными с безопасностью. Хотя некоторые AI-лаборатории предпочитают оценку от сторонних организаций вместо прямого государственного регулирования, существует скептицизм относительно способности этих оценщиков сохранять истинную нейтральность и эффективность. Например, выбор Anthropic назначить оценщиком Accenture вызвал дебаты о пригодности консалтинговых фирм для такой специализированной роли.
Более того, оценки ИИ развиваются от тестирования изолированных моделей к оценке целых систем, включающих такие элементы, как пользовательский интерфейс или оболочка, соединяющая пользователей с моделью. Солаиман отметила, что окружение модели существенно влияет на эффективность, то есть менее продвинутая модель в сочетании с лучшей оболочкой может превзойти более продвинутую автономную модель. Эта сложность способствует высоким затратам и трудностям проведения комплексных оценок с использованием агентов.
В заключение Солаиман подчеркнула, что без единого, стандартизированного подхода к оценке ИИ — охватывающего как модели, так и их рабочие среды — область сравнительного анализа остаётся фрагментированной. Чтобы сравнительный анализ служил эффективным инструментом для руководства развитием и безопасностью ИИ, крайне важны совместные усилия по стандартизации и развитию экосистемы.
Источники и первоисточники
Read the original source ↗
Комментарии (0)
Комментариев пока нет. Начните обсуждение.
Написать комментарий
Комментарии публикуются после модерации. Ваше имя и комментарий будут видны всем. Аккаунт