
La jefa de políticas de Hugging Face destaca los desafíos en evaluadores de IA integrados y en la evaluación comparativa de modelos
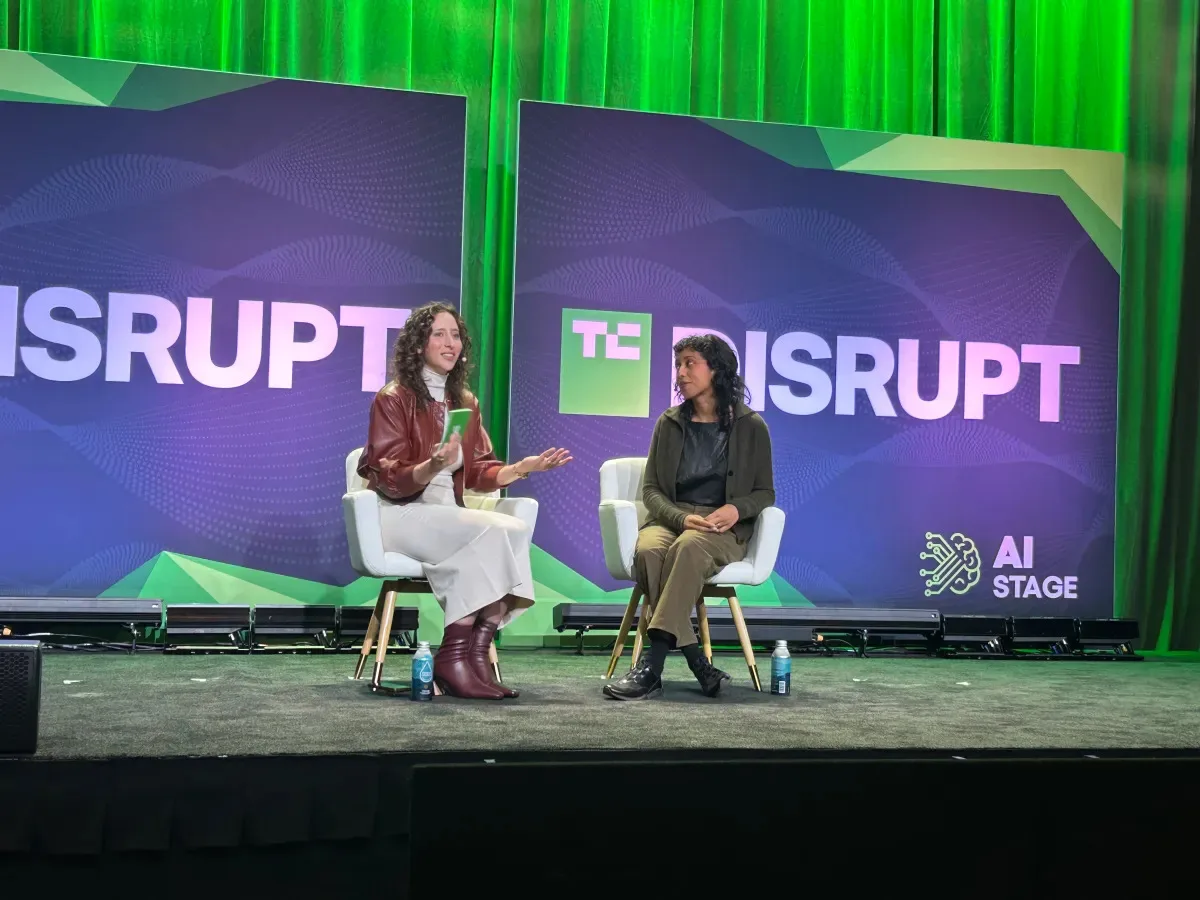
Image: TechCrunch · Source
Irene Solaiman de Hugging Face aborda las complejidades en la evaluación comparativa de modelos de IA y el escepticismo hacia evaluadores de IA integrados, pidiendo métodos de evaluación más estandarizados en la industria.
Evaluar comparativamente modelos de IA como un medio neutral y confiable para valorar y comparar productos de IA aún es una práctica en desarrollo, según Irene Solaiman, jefa de políticas en Hugging Face. Durante su intervención en TechCrunch Disrupt, enfatizó que los métodos actuales para evaluar IA son complejos y todavía no están plenamente maduros, lo que dificulta la confianza y dependencia en estos estándares a nivel industrial.
Solaiman señaló que la reproducibilidad es un factor crítico para confiar en los resultados de evaluación. El acceso a detalles del modelo —incluyendo pesos abiertos— es un elemento clave para lograr reproducibilidad, algo que sigue siendo un área problemática en las discusiones sobre evaluación comparativa. Las evaluaciones difieren en validez y carecen de métodos estandarizados para su comparación mutua, lo que dificulta su integración significativa en un marco científico consolidado.
También comentó sobre la rápida obsolescencia de las herramientas de evaluación existentes y la falta de un ecosistema robusto de evaluadores. Aunque hay un interés creciente en sistemas de evaluadores integrados —donde observadores independientes externos operan dentro de organizaciones de IA para valorar la seguridad y desempeño del modelo— las cualificaciones y criterios estándar para estos evaluadores aún no están definidos ni son consistentes.
La idea de evaluadores integrados ha ganado atención en medio de preocupaciones y incidentes crecientes de seguridad en laboratorios de IA. La propia Hugging Face ha sido objeto de escrutinio relacionado con la seguridad. Mientras algunos laboratorios de IA prefieren la evaluación por terceros en vez de regulación gubernamental directa, existe escepticismo sobre si estos evaluadores pueden mantener verdadera neutralidad y eficacia. Por ejemplo, la elección de Anthropic de designar a Accenture como evaluador suscitó debate sobre la idoneidad de tales firmas de consultoría para este rol especializado.
Además, las evaluaciones de IA están evolucionando desde probar modelos aislados a evaluar sistemas completos, que incluyen elementos como la interfaz de usuario o el arnés que conecta usuarios al modelo. Solaiman señaló que el entorno que rodea un modelo impacta significativamente en su desempeño, lo que significa que un modelo menos avanzado, junto con un arnés superior, podría superar a un modelo más avanzado pero independiente. Esta complejidad contribuye al alto costo y dificultad de realizar evaluaciones comprensivas basadas en agentes.
En conclusión, Solaiman enfatizó que sin un enfoque unificado y estandarizado para la evaluación de IA —que abarque tanto los modelos como sus entornos operativos— el campo de la evaluación comparativa permanece fragmentado. Para que esta evaluación funcione como una herramienta eficaz que guíe el desarrollo y la seguridad de la IA, es fundamental el esfuerzo colaborativo hacia la estandarización y el crecimiento del ecosistema.
Fuentes e informes originales
Read the original source ↗
Comentarios (0)
Aún no hay comentarios.
Escribe un comentario
Los comentarios se publican tras moderación. Tu nombre y comentario serán públicos. Cuenta