
Hugging Faces policydirektör lyfter fram utmaningar med inbäddade AI-utvärderare och modelljämförelser
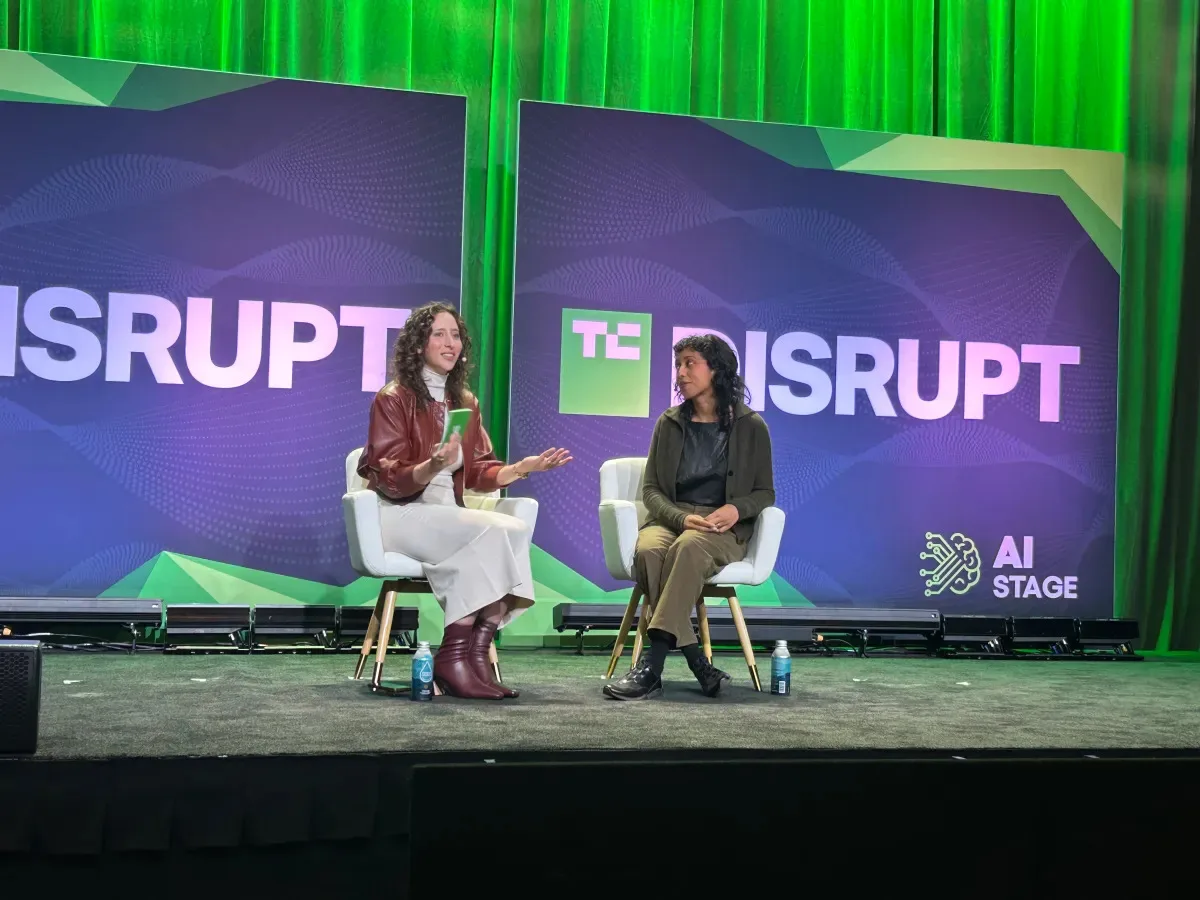
Bild: TechCrunch · Källa
Irene Solaiman från Hugging Face diskuterar komplexiteten i AI-modelljämförelser och skepsis kring inbäddade AI-utvärderare, och efterlyser mer standardiserade metoder för utvärdering inom hela branschen.
Benchmarking av AI-modeller som ett neutralt och pålitligt sätt att bedöma och jämföra AI-produkter är fortfarande en utvecklande praktik, enligt Irene Solaiman, Chief Policy Officer på Hugging Face. Vid TechCrunch Disrupt betonade hon att de nuvarande metoderna för AI-utvärdering är komplexa och ännu inte fullt mogna, vilket gör industrins förtroende och beroende av dessa benchmarks utmanande.
Solaiman påpekade att reproducerbarhet är en kritisk faktor för att lita på utvärderingsresultat. Tillgång till modellinformation—inklusive öppna modellvikter—är en nyckelkomponent för att uppnå reproducerbarhet, vilket fortfarande är ett problem inom benchmarkingdiskussionerna. Utvärderingar skiljer sig i giltighet och saknar standardiserade metoder för jämförelse sinsemellan, vilket försvårar en meningsfull integration i en etablerad vetenskaplig ram.
Hon nämnde också att de befintliga utvärderingsverktygen snabbt blir inaktuella och att det finns en brist på ett robust ekosystem av utvärderare. Trots ett växande intresse för inbäddade utvärderarsystem—där oberoende tredje parter agerar inom AI-organisationer för att bedöma modellers säkerhet och prestanda—är kvalifikationerna och de standardiserade kriterierna för dessa utvärderare ännu inte tydligt definierade eller konsekventa.
Idén med inbäddade utvärderare har fått ökad uppmärksamhet i takt med stigande säkerhetsbekymmer och incidenter inom AI-lab. Hugging Face har själv utsatts för säkerhetsrelaterad granskning. Medan vissa AI-lab föredrar tredjepartsutvärdering framför direkt reglering från staten, finns det skepsis kring huruvida dessa utvärderare kan bibehålla verklig neutralitet och effektivitet. Till exempel väckte Anthropics val att utse Accenture som utvärderare debatt om lämpligheten hos sådana konsultföretag för denna specialiserade roll.
Dessutom utvecklas AI-utvärderingar från att testa isolerade modeller till att bedöma hela system, som inkluderar komponenter som användargränssnittet eller kopplingar som binder användarna till modellen. Solaiman noterade att modellens omgivande miljö har en stor inverkan på prestandan, vilket innebär att en mindre avancerad modell med en överlägsen koppling kan prestera bättre än en mer avancerad fristående modell. Denna komplexitet bidrar till de höga kostnaderna och svårigheterna med att genomföra omfattande agentbaserade utvärderingar.
Avslutningsvis betonade Solaiman att utan ett enhetligt, standardiserat tillvägagångssätt för AI-utvärdering—som omfattar både modeller och deras operativa miljöer—kommer benchmarkingfältet förbli splittrat. För att benchmarking ska fungera som ett effektivt verktyg för att styra AI-utveckling och säkerhet är samarbetsinsatser för standardisering och ekosystemtillväxt avgörande.
Källor och ursprunglig rapportering
Läs den ursprungliga källan ↗
Kommentarer (0)
Inga kommentarer ännu. Börja diskussionen.
Skriv en kommentar
Kommentarer publiceras efter granskning. Ditt namn och kommentar syns offentligt. Konto