
Hugging Face politikas vadītāja izceļ izaicinājumus iebūvēto AI novērtētāju un modeļu salīdzināšanas jomā
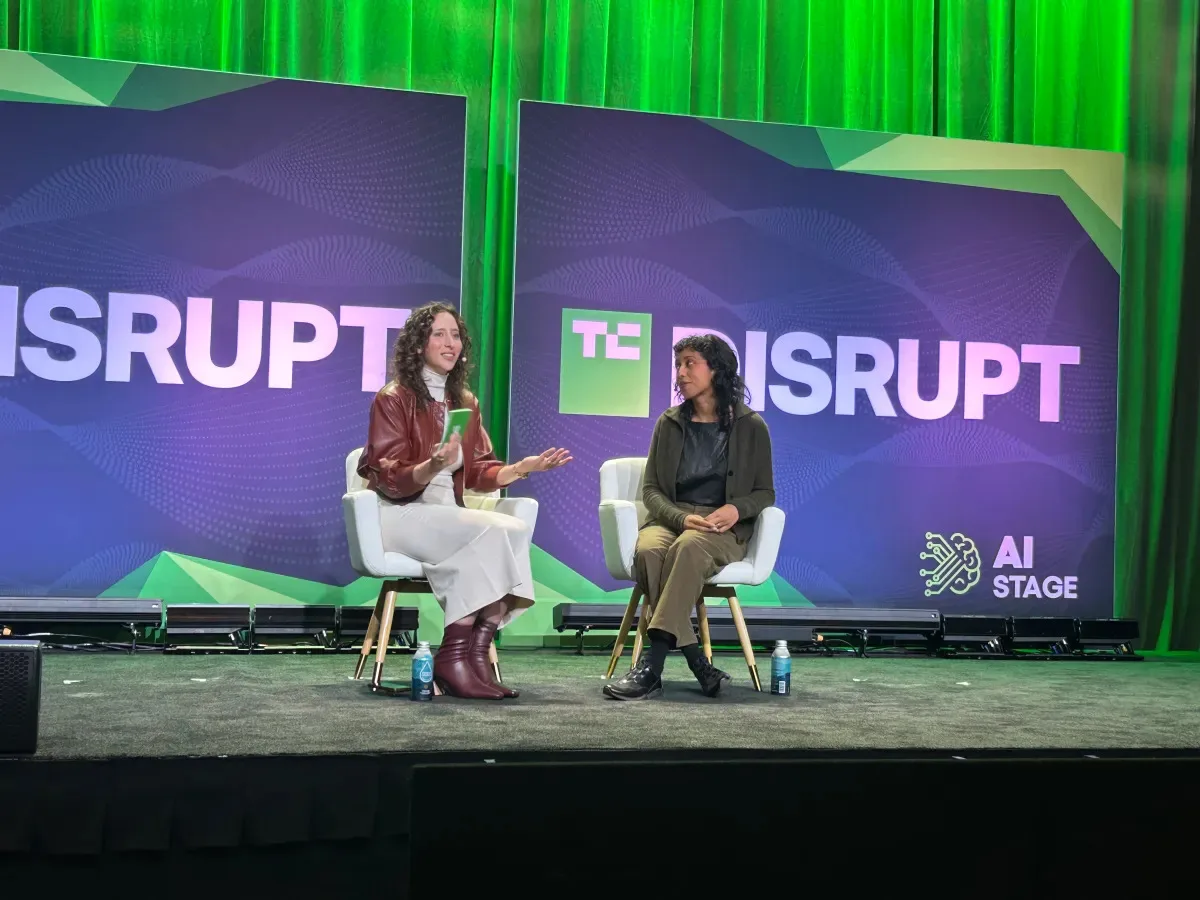
Attēls: TechCrunch · Avots
Hugging Face pārstāve Irene Solaiman apspriež AI modeļu salīdzināšanas sarežģījumus un skepsi pret iebūvētajiem AI novērtētājiem, aicinot nozares līmenī ieviest vairāk standartizētu novērtēšanas metožu.
AI modeļu salīdzināšana kā neitrāls un uzticams līdzeklis AI produktu novērtēšanai un salīdzināšanai joprojām ir attīstības stadijā, norāda Irene Solaiman, Hugging Face galvenā politikas vadītāja. Uzstājoties TechCrunch Disrupt konferencē, viņa uzsvēra, ka pašreizējās AI novērtēšanas metodes ir sarežģītas un vēl nav pilnībā nobriedušas, kas apgrūtina nozares plašu uzticēšanos un atbalstu šiem salīdzinājumiem.
Solaiman norādīja, ka reproducējamība ir būtisks faktors uzticībai novērtējuma rezultātiem. Pieeja modeļu detaļām — tostarp atklātiem modeļu svaru datiem — ir galvenais elements reproducējamības nodrošināšanā, kas joprojām ir problemātiska tēma salīdzināšanas diskusijās. Novērtējumi atšķiras pēc derīguma, un trūkst standartizētu metožu to savstarpējai salīdzināšanai, kas kavē to jēgpilnu integrēšanu zinātniskās sistēmās.
Viņa arī norādīja uz esošo novērtēšanas rīku ātru novecošanos un robustas novērtētāju ekosistēmas trūkumu. Lai gan pieaug interese par iebūvēto novērtētāju sistēmām — kur neatkarīgi trešo pušu novērotāji darbojas AI organizācijās, lai novērtētu modeļu drošību un veiktspēju — šo novērtētāju kvalifikācijas un standarta kritēriji vēl nav skaidri definēti vai konsekventi.
Iebūvēto novērtētāju ideja ir ieguvusi uzmanību pieaugošo drošības bažu un incidentu dēļ AI laboratorijās. Pašai Hugging Face ir bijusi drošības vērtēšanas uzmanība. Kaut arī daudzas AI laboratorijas dod priekšroku trešo pušu novērtējumam pār tiešu valsts regulējumu, pastāv skepsis par to, vai šie novērtētāji spēj saglabāt patiesu neitralitāti un efektivitāti. Piemēram, Anthropic izvēle kā novērtētāju iecelt Accenture izraisīja diskusijas par tādu konsultāciju uzņēmumu piemērotību šādai specializētai lomai.
Turklāt AI novērtējumi attīstās no izolētu modeļu testēšanas uz visu sistēmu novērtēšanu, kas ietver arī tādas sastāvdaļas kā lietotāja interfeiss vai savienojums, kas savieno lietotājus ar modeli. Solaiman norādīja, ka modeļa apkārtējā vide būtiski ietekmē veiktspēju, kas nozīmē, ka vienkāršāks modelis kopā ar augstvērtīgāku savienojumu var pārspēt progresīvāku atsevišķu modeli. Šī sarežģītība palielina augstās izmaksas un grūtības veikt visaptverošu aģentu balstītu novērtējumu.
Noslēgumā Solaiman uzsvēra, ka bez vienotas, standartizētas pieejas AI novērtēšanai — kas aptver gan modeļus, gan to darbības vidi — salīdzināšanas joma paliek fragmentēta. Lai salīdzināšana kalpotu kā efektīvs instruments AI attīstības un drošības vadībā, nepieciešama sadarbības virzīta standartizācija un ekosistēmas attīstība.
Avoti un oriģinālziņas
Lasīt oriģinālo avotu ↗
Komentāri (0)
Komentāru vēl nav. Sāciet diskusiju.
Rakstīt komentāru
Komentāri tiek publicēti pēc moderēšanas. Jūsu vārds un komentārs būs redzami publiski. Konts