
Hugging Faces policyansvarlige fremhever utfordringer med innebygde AI-evaluatorer og modellbenchmarking
Bilde: TechCrunch · Kilde
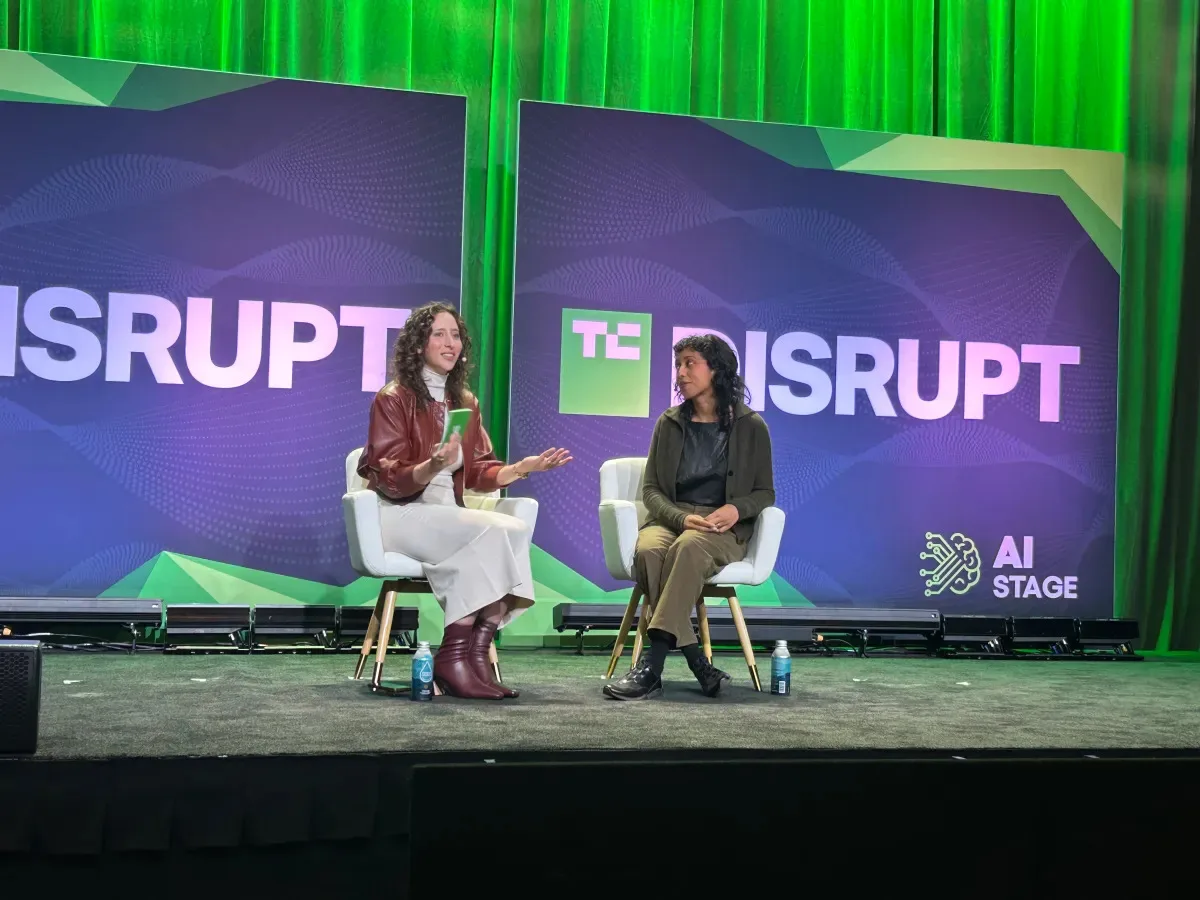
Irene Solaiman fra Hugging Face diskuterer kompleksiteten i AI-modellbenchmarking og skepsis rundt innebygde AI-evaluatorer, og etterlyser mer standardiserte evalueringsmetoder på tvers av industrien.
Å benchmarking av AI-modeller som et nøytralt og pålitelig middel for å vurdere og sammenligne AI-produkter er fortsatt en under utvikling praksis, ifølge Irene Solaiman, Chief Policy Officer i Hugging Face. Under TechCrunch Disrupt understreket hun at dagens metoder for AI-evaluering er komplekse og ennå ikke fullt modne, noe som gjør det vanskelig å oppnå tillit og avhengighet til disse benchmarkene i bransjen.
Solaiman påpekte at reproduserbarhet er en kritisk faktor for å stole på evalueringsresultater. Tilgang til modelldetaljer—inkludert åpne modellvekter—er et sentralt element for å oppnå reproduserbarhet, noe som fortsatt er et problemområde i benchmarkingdiskusjoner. Evalueringer varierer i gyldighet og mangler standardiserte metoder for sammenligning, noe som hindrer meningsfull integrering i en etablert vitenskapelig ramme.
Hun bemerket også den raske foreldelsen av eksisterende evalueringsverktøy og mangelen på et robust økosystem av evaluatorer. Selv om det er økende interesse for innebygde evaluatorsystemer—hvor uavhengige tredjepartsobservatører opererer innen AI-organisasjoner for å bedømme modellsikkerhet og ytelse—er kvalifikasjonene og standardkriteriene for disse evaluatorene ennå ikke klart definert eller konsistente.
Ideen om innebygde evaluatorer har fått oppmerksomhet i takt med økende sikkerhetsbekymringer og hendelser i AI-laboratorier. Hugging Face har selv opplevd sikkerhetsrelatert granskning. Mens noen AI-laboratorier foretrekker tredjepartsevaluering fremfor direkte statlig regulering, finnes det skepsis til om disse evaluatorene kan opprettholde ekte nøytralitet og effektivitet. For eksempel skapte Anthropics valg om å utnevne Accenture som evaluator debatt om egnetheten til slike konsulentselskaper for denne spesialiserte rollen.
I tillegg utvikler AI-evalueringer seg fra testing av isolerte modeller til å vurdere hele systemer, inkludert elementer som brukergrensesnitt eller koblinger som knytter brukere til modellen. Solaiman bemerket at modellens omgivende miljø har stor betydning for ytelsen, noe som betyr at en mindre avansert modell med en overlegen kobling kan prestere bedre enn en mer avansert frittstående modell. Denne kompleksiteten bidrar til de høye kostnadene og vanskelighetene med å utføre omfattende agentbaserte evalueringer.
Avslutningsvis fremhevet Solaiman at uten en samlet, standardisert tilnærming til AI-evaluering—som inkluderer både modeller og deres operative miljøer—vil benchmarkingfeltet forbli fragmentert. For at benchmarking skal tjene som et effektivt verktøy for å styre AI-utvikling og sikkerhet, er samarbeid om standardisering og økosystemutvikling avgjørende.
Kilder og originalrapportering
Les originalkilden ↗
Kommentarer (0)
Ingen kommentarer ennå. Start diskusjonen.
Skriv en kommentar
Kommentarer publiseres etter moderering. Ditt navn og kommentar vil være synlige offentlig. Konto