
Irene Solaiman z Hugging Face o wyzwaniach w ocenie wbudowanej AI i benchmarkingu modeli
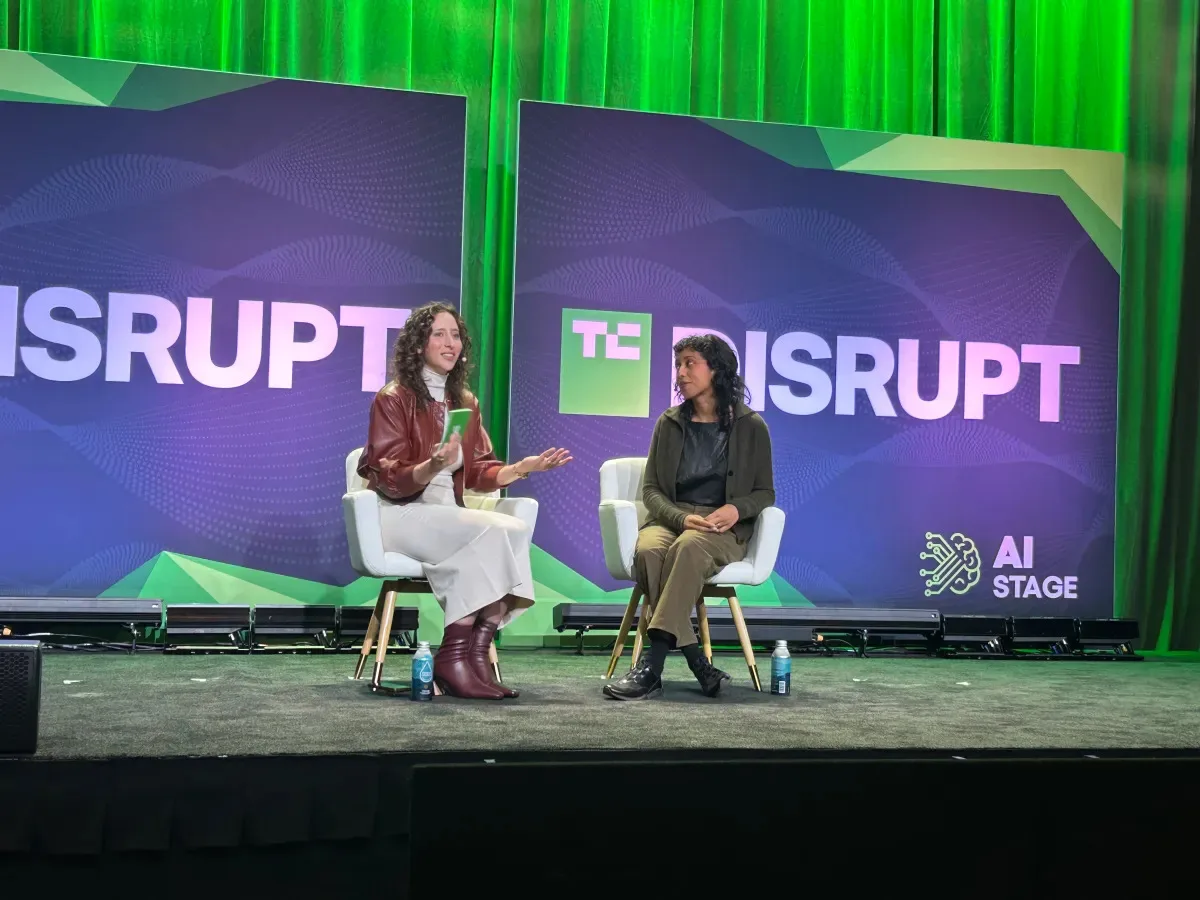
Image: TechCrunch · Source
Irene Solaiman z Hugging Face omawia złożoność benchmarkingu modeli AI oraz sceptycyzm wobec wbudowanych ewaluatorów AI, apelując o bardziej ustandaryzowane metody oceny w całej branży.
Benchmarking modeli AI jako neutralny i wiarygodny sposób oceny oraz porównywania produktów AI jest nadal praktyką w fazie rozwoju, według Irene Solaiman, Chief Policy Officer w Hugging Face. Podczas wystąpienia na TechCrunch Disrupt podkreśliła, że obecne metody oceny AI są skomplikowane i jeszcze nie w pełni dojrzałe, co utrudnia budowanie branżowego zaufania i polegania na tych benchmarkach.
Solaiman wskazała, że odtwarzalność jest kluczowym czynnikiem w zaufaniu do wyników oceny. Dostęp do szczegółów modelu — w tym otwarte wagi modelu — jest istotnym elementem osiągnięcia odtwarzalności, co pozostaje problematycznym obszarem w dyskusjach benchmarkingowych. Oceny różnią się ważnością i brakuje ustandaryzowanych metod do ich wzajemnego porównywania, co utrudnia ich znaczącą integrację w ustalonym naukowym kontekście.
Zwróciła także uwagę na szybką starzenie się istniejących narzędzi oceny oraz brak solidnego ekosystemu ewaluatorów. Chociaż rośnie zainteresowanie systemami ewaluatorów wbudowanych — gdzie niezależni obserwatorzy trzecich stron działają wewnątrz organizacji AI w celu oceny bezpieczeństwa i wydajności modelu — kwalifikacje i standardowe kryteria dla tych ewaluatorów nie są jeszcze jasno zdefiniowane ani spójne.
Idea wbudowanych ewaluatorów zyskała na znaczeniu w obliczu rosnących obaw o bezpieczeństwo i incydentów w laboratoriach AI. Sama firma Hugging Face doświadczyła kontroli związanych z bezpieczeństwem. Podczas gdy niektóre laboratoria AI wolą ewaluację przez podmioty zewnętrzne zamiast bezpośredniej regulacji rządowej, istnieje sceptycyzm co do tego, czy ci ewaluatorzy mogą zachować prawdziwą neutralność i skuteczność. Na przykład wybór firmy Accenture przez Anthropic na ewaluatora wzbudził debatę na temat odpowiedniości firm konsultingowych do tej specjalistycznej roli.
Co więcej, ewaluacje AI ewoluują od testowania pojedynczych modeli do oceniania całych systemów, które obejmują elementy takie jak interfejs użytkownika czy opakowanie łączące użytkowników z modelem. Solaiman zauważyła, że otoczenie modelu znacząco wpływa na jego wydajność, co oznacza, że mniej zaawansowany model w parze z lepszym opakowaniem może przewyższyć bardziej zaawansowany model pojedynczy. Ta złożoność przyczynia się do wysokich kosztów i trudności w przeprowadzaniu kompleksowych ocen opartych na agentach.
Podsumowując, Solaiman podkreśliła, że bez jednolitego, ustandaryzowanego podejścia do oceny AI — obejmującego zarówno modele, jak i ich środowiska operacyjne — dziedzina benchmarkingu pozostaje fragmentaryczna. Aby benchmarking był skutecznym narzędziem wspierającym rozwój i bezpieczeństwo AI, kluczowa jest współpraca na rzecz standaryzacji i rozwoju ekosystemu.
Źródła i oryginalne doniesienia
Read the original source ↗
Komentarze (0)
Nie ma jeszcze komentarzy.
Napisz komentarz
Komentarze publikujemy po moderacji. Nazwa i komentarz będą publiczne. Konto