
Tenstorrent Lanza el Modelo de IA MiniMax M3.1 Flash en la Nube con Eficiencia Mejorada
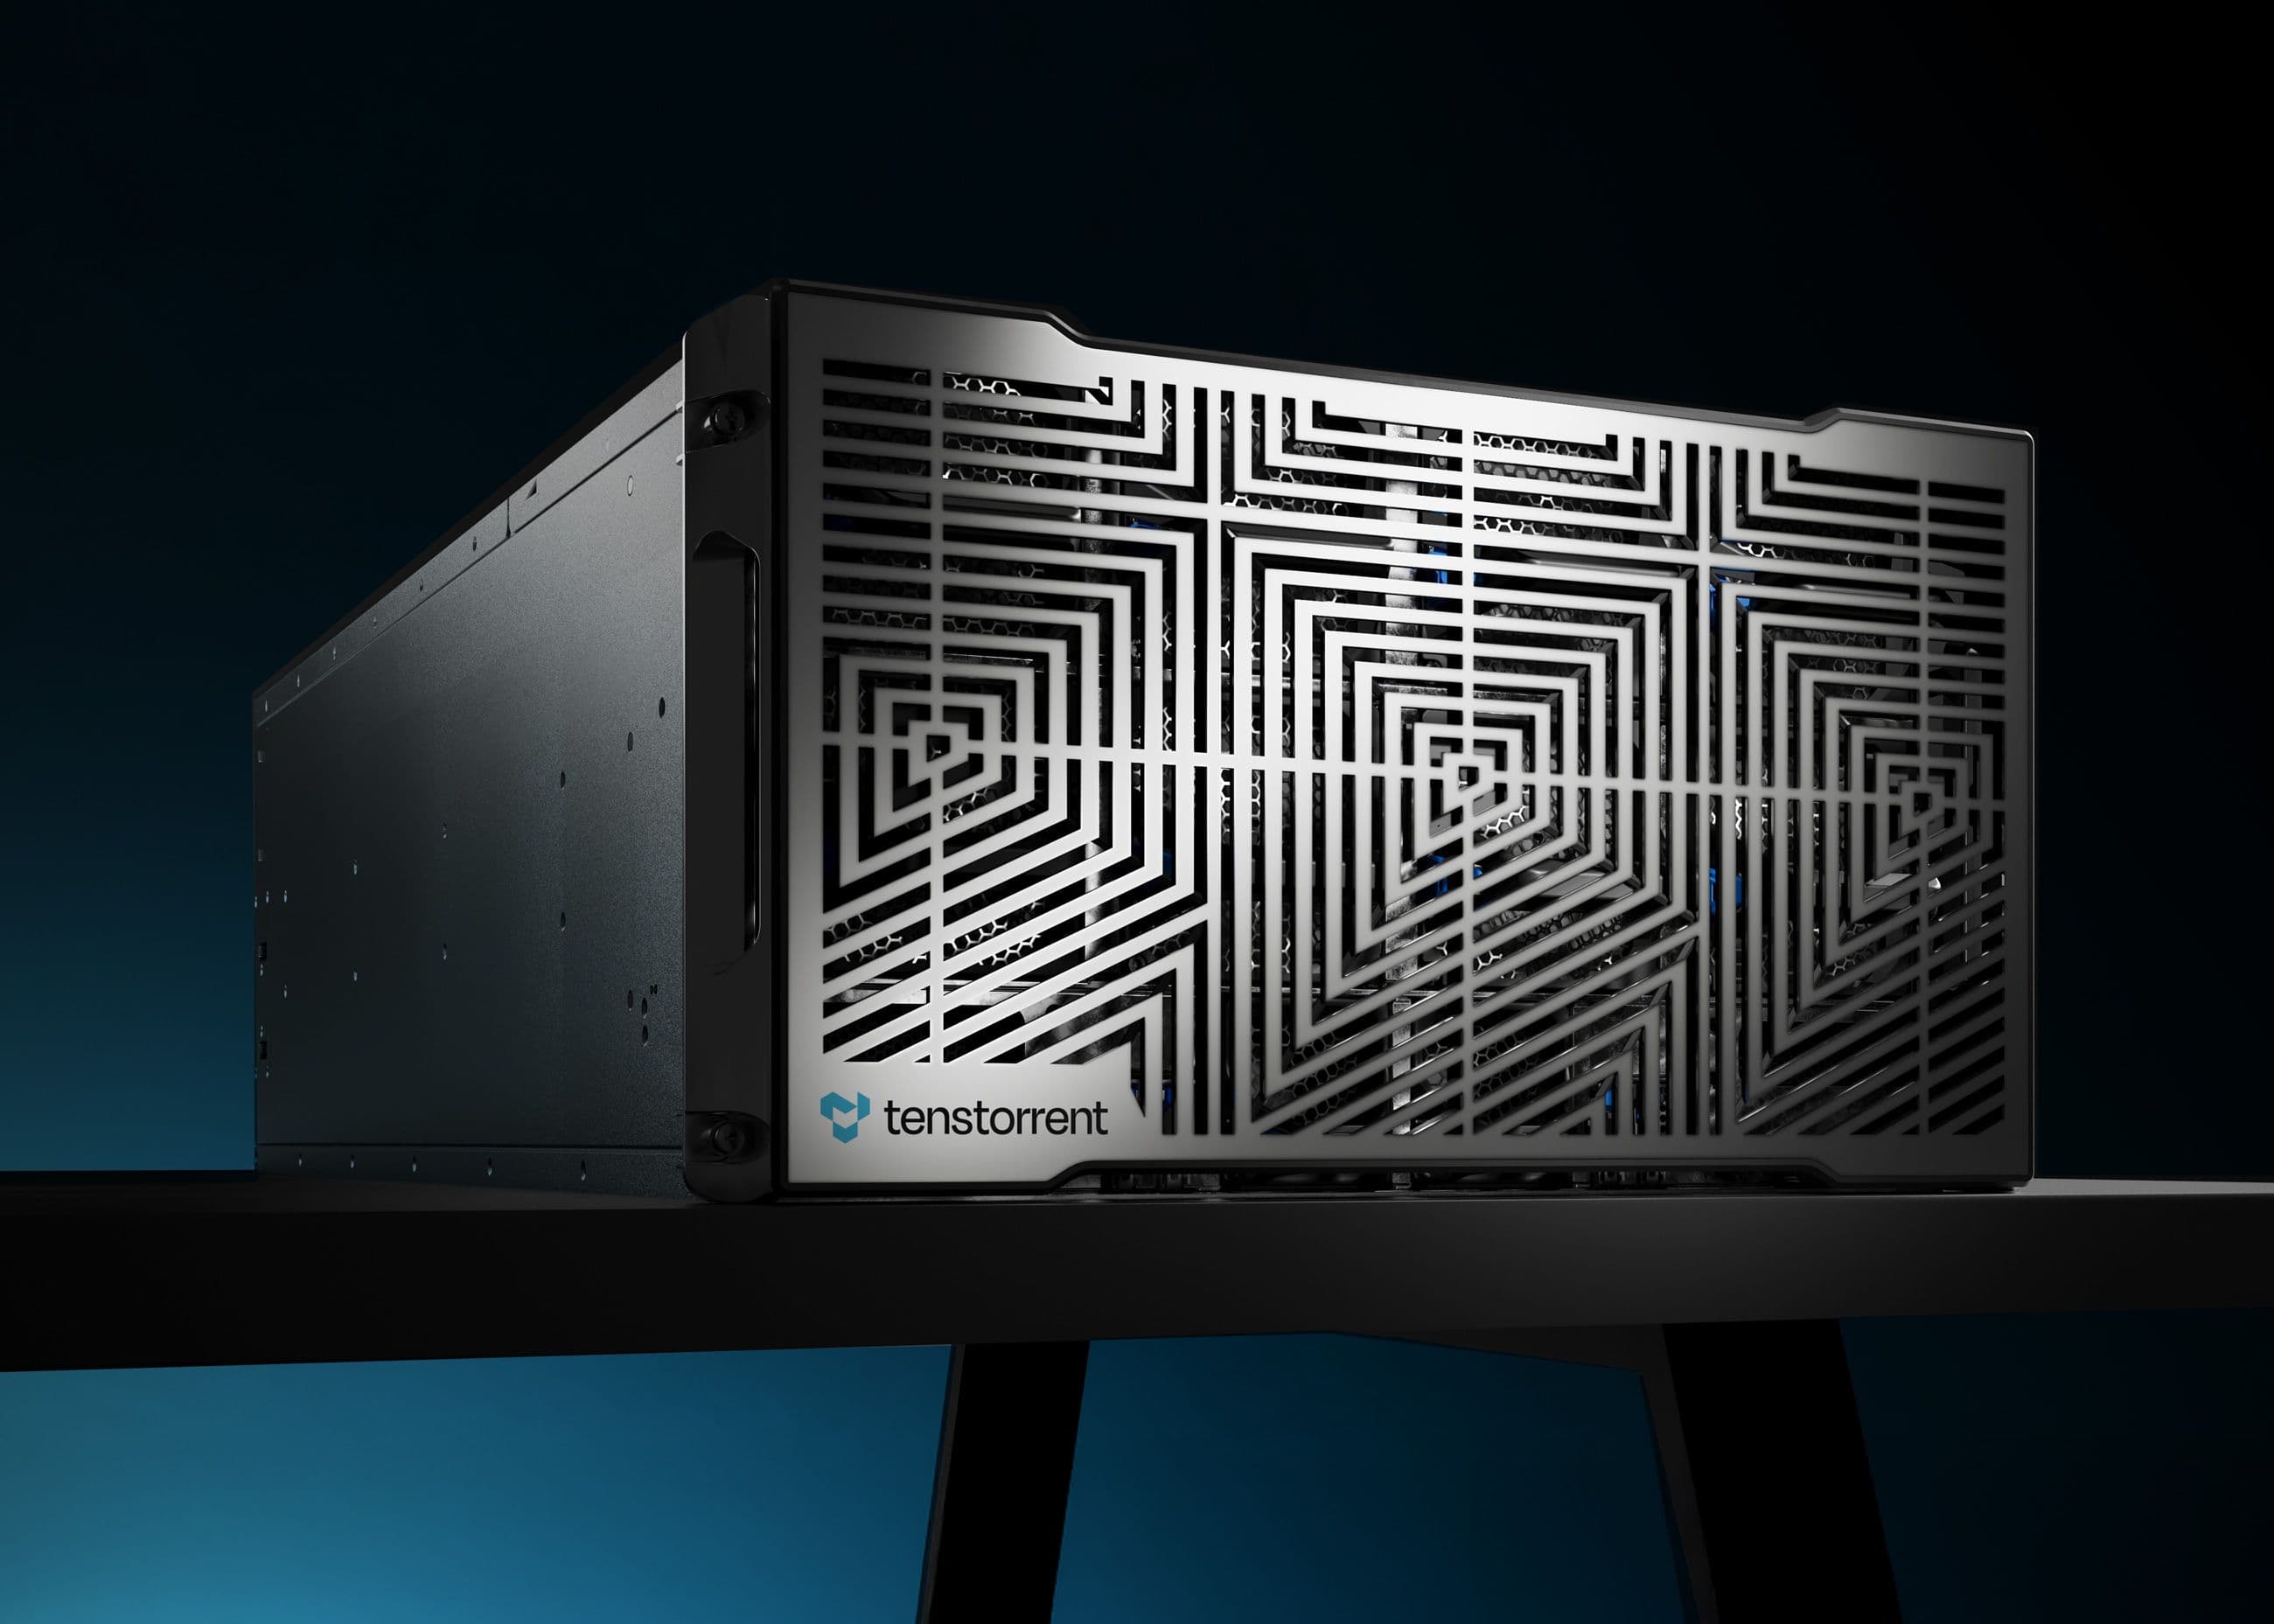
Image: Tenstorrent · Source
Tenstorrent ahora ofrece el modelo MiniMax M3.1 Flash en su plataforma en la nube, proporcionando reducciones significativas de costos y un sólido rendimiento en tareas de agentes mediante innovaciones arquitectónicas y cuantización del modelo.
Tenstorrent anunció que ha desplegado el modelo de IA MiniMax M3.1 Flash en su plataforma en la nube, ejecutando tanto los procesos de prellenado como de decodificación en su infraestructura propietaria Galaxy® supercluster. MiniMax lanzó simultáneamente los pesos abiertos del modelo, permitiendo a los usuarios aprovechar esta avanzada IA para diversas aplicaciones.
MiniMax M3.1 Flash está diseñado para tareas de agente a escala de producción, alcanzando aproximadamente un 70 % menos de costos operativos en comparación con su predecesor, MiniMax M3. Específicamente, reduce el costo por millón de tokens de entrada a $0.15 y de tokens de salida a $0.60, representando la mitad del precio del modelo anterior. Los costos de tokens de entrada en caché son aún menores, a $0.015 por millón de tokens.
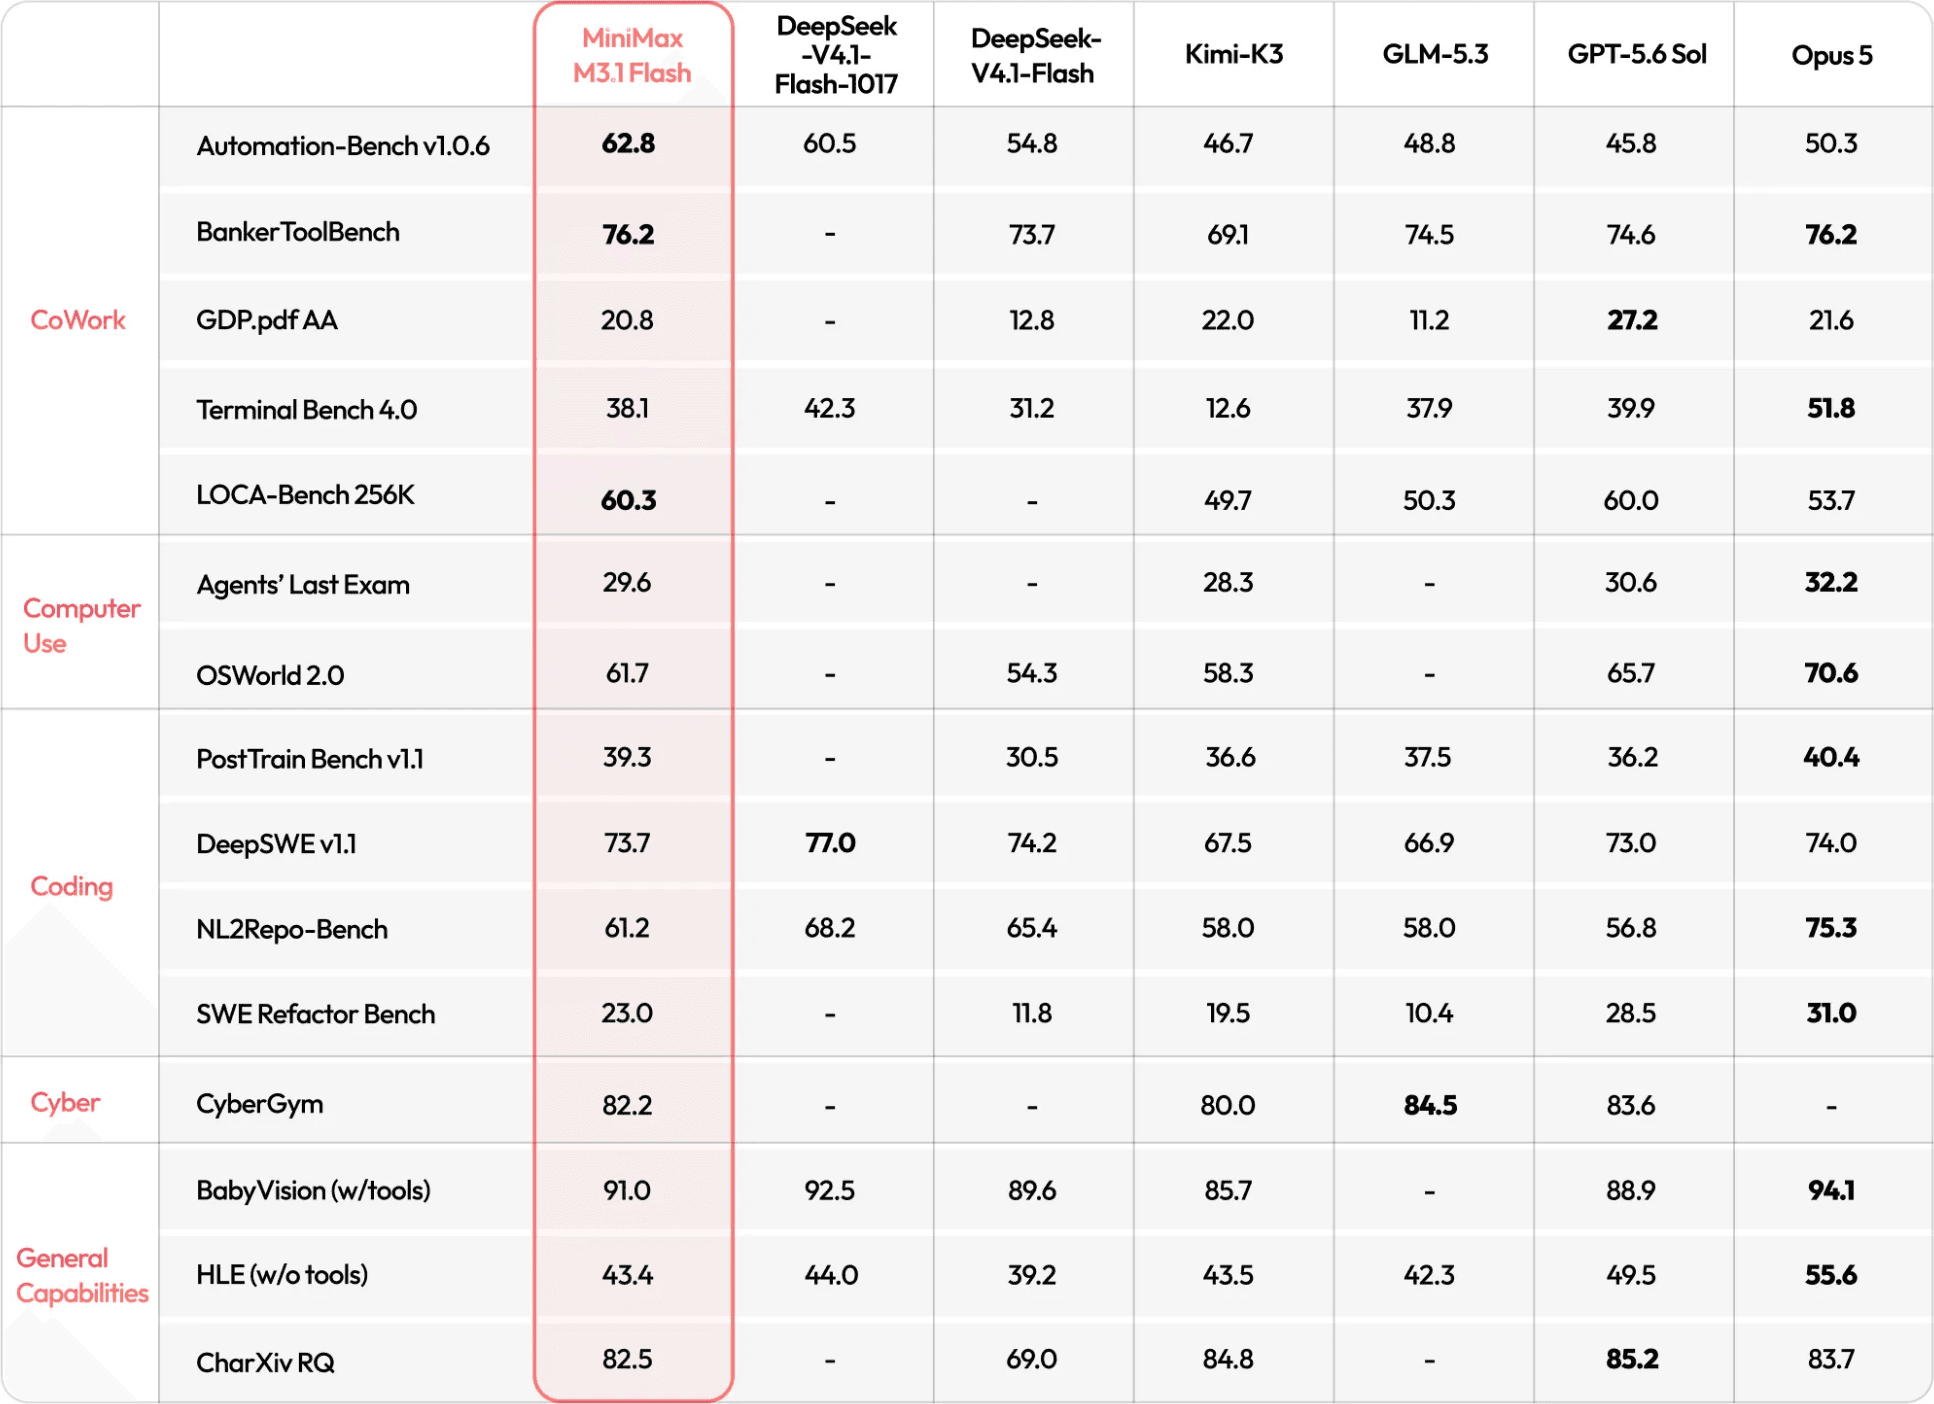
Los benchmarks de rendimiento posicionan a MiniMax M3.1 Flash por delante de todos los modelos en las comparaciones internas de MiniMax en AutomationBench y LOCA-Bench 256K, y iguala a Claude Opus 5 en BankerToolBench. Una versión temprana de este modelo, denominada “Space Bunny Alpha,” ya demostró escalabilidad procesando más de 200 billones de tokens.
Clave para la eficiencia del modelo son las mejoras arquitectónicas y técnicas de cuantización. El mecanismo tradicional de atención global por grupos de consulta fue reemplazado por atención dispersa, limitando cada token a leer solo una parte del contexto. Los perceptrones multicapa (MLP) densos se mantienen solo en las primeras tres capas, reduciendo la carga computacional y el tráfico de memoria, especialmente para entradas contextuales largas.
Además, MiniMax empleó una cuantización agresiva: los pesos MLP, los pesos de atención, el indexador y los componentes expertos compartidos se cuantizaron a precisión MXFP8, mientras que los pesos de expertos enroutados usan NVFP4. Este enfoque permite mantener o mejorar ligeramente las capacidades del modelo respecto al M3 no cuantizado.
Tenstorrent ofrece MiniMax M3.1 Flash en un supercluster compuesto por múltiples sistemas Blackhole Galaxy. Estos se especializan y dividen en funciones de prellenado y decodificación, optimizando cada uno para su carga de trabajo. Prefill maneja los prompts entrantes de agentes a través de muchos chips con alta ancho de banda interdispositivo, mientras que los sistemas de decodificación generan tokens de salida de forma independiente, asegurando capacidad de respuesta durante operaciones largas de prellenado. La comunicación entre chips utiliza canales Ethernet de baja latencia, y datos como pesos y cachés clave-valor se almacenan en DRAM y SRAM en el dispositivo para velocidad.
Una característica notable es la descarga del caché clave-valor, que almacena estados contextuales reutilizados en grandes conjuntos de DRAM y SSD (1 TB de DRAM y varios terabytes de SSD por sistema), minimizando el cálculo redundante en interacciones repetidas con agentes.
El ajuste de Tenstorrent aprovecha trazas AgentX de SemiAnalysis, derivadas de sesiones reales multi-turno con subagentes, en lugar de depender de benchmarks breves de chat.
El modelo MiniMax M3.1 Flash está disponible actualmente mediante la consola en la nube de Tenstorrent, permitiendo a los desarrolladores experimentar en su entorno Playground o integrarlo directamente con marcos de agentes.
Este despliegue ejemplifica la sinergia entre diseño avanzado de modelos, optimización de hardware e infraestructura en la nube, orientado a aplicaciones prácticas de agentes de IA con costos reducidos y alto rendimiento.

Fuentes e informes originales
Read the original source ↗
Comentarios (0)
Aún no hay comentarios.
Escribe un comentario
Los comentarios se publican tras moderación. Tu nombre y comentario serán públicos. Cuenta