
Tenstorrent запускает MiniMax M3.1 Flash — AI-модель в облаке с повышенной эффективностью
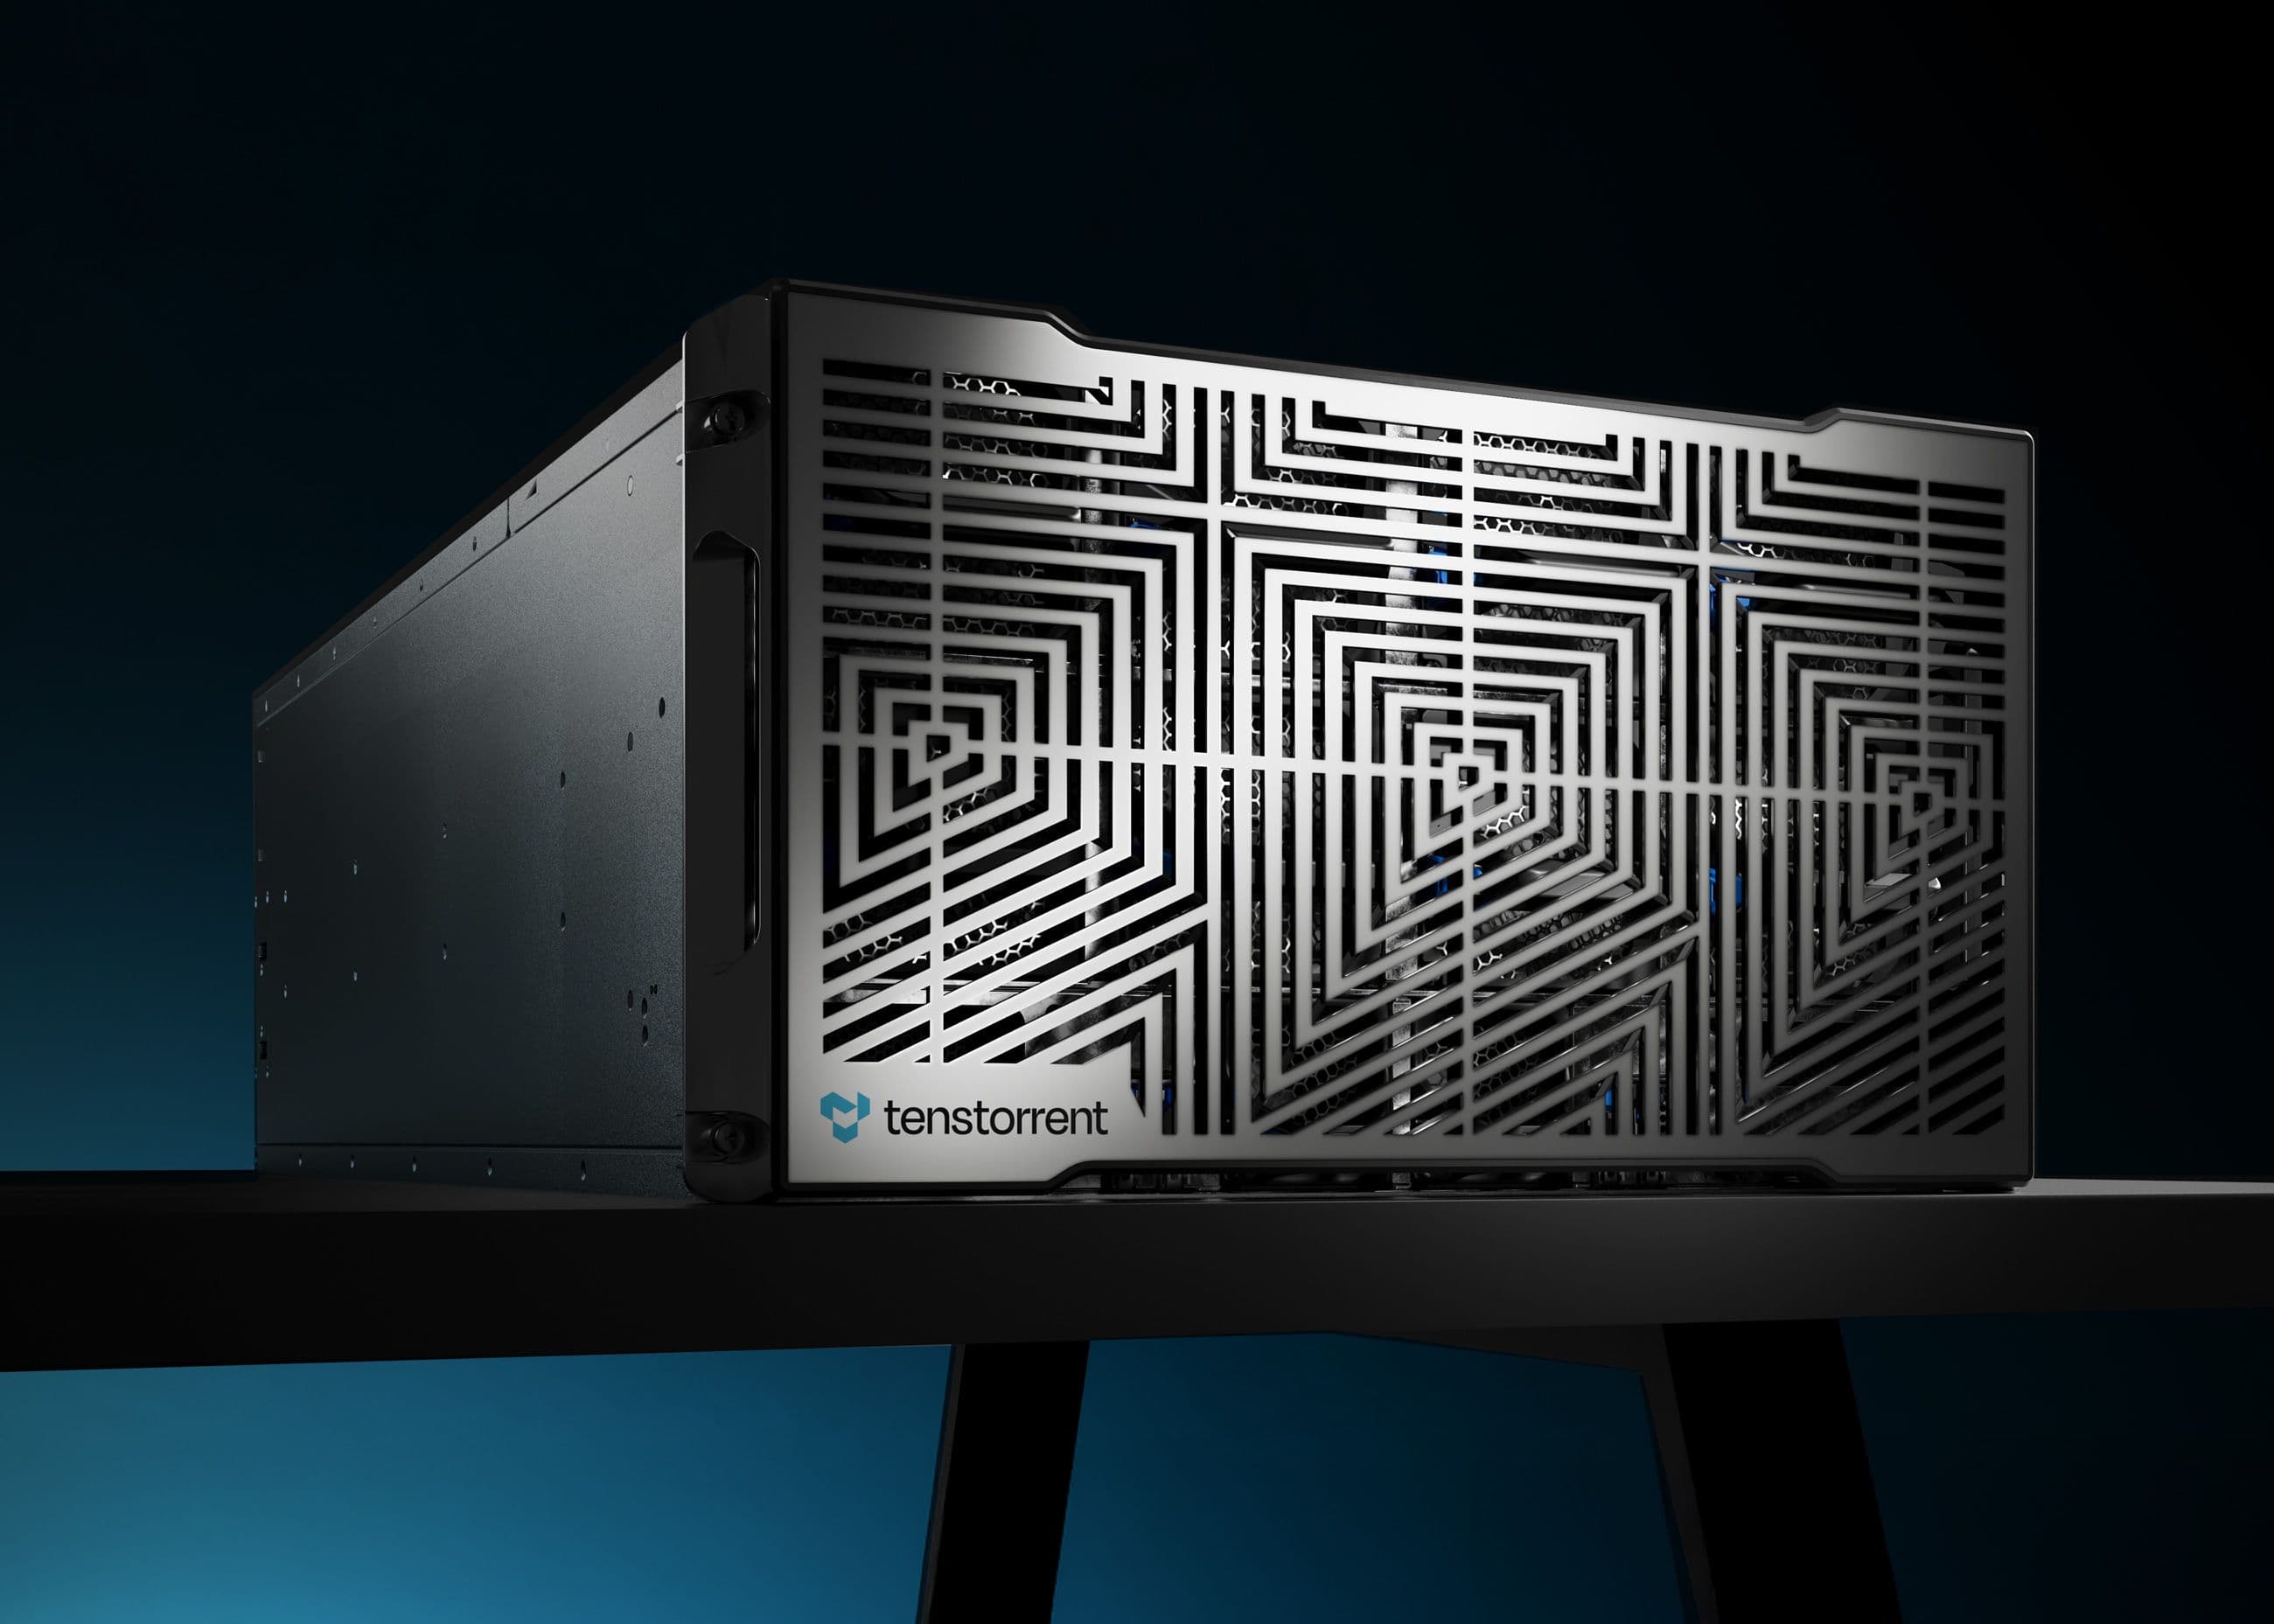
Image: Tenstorrent · Source
Tenstorrent теперь предлагает модель MiniMax M3.1 Flash на своей облачной платформе, обеспечивая значительное снижение затрат и высокую производительность в задачах агентов благодаря архитектурным инновациям и квантованию модели.
Tenstorrent объявил о развертывании модели искусственного интеллекта MiniMax M3.1 Flash на своей облачной платформе, выполняя процессы prefill и decode на собственной инфраструктуре суперкустера Galaxy®. Одновременно MiniMax выпустил открытые веса модели, позволяя пользователям использовать этот продвинутый AI для различных приложений.
MiniMax M3.1 Flash разработана для агентских задач промышленного масштаба, достигая примерно на 70% меньших операционных затрат по сравнению с предшественником, MiniMax M3. В частности, стоимость на миллион входных токенов снижена до 0,15 доллара, а выходных токенов — до 0,60 доллара, что вдвое дешевле предыдущей модели. Стоимость токенов из кеша входных данных еще ниже — 0,015 доллара за миллион.
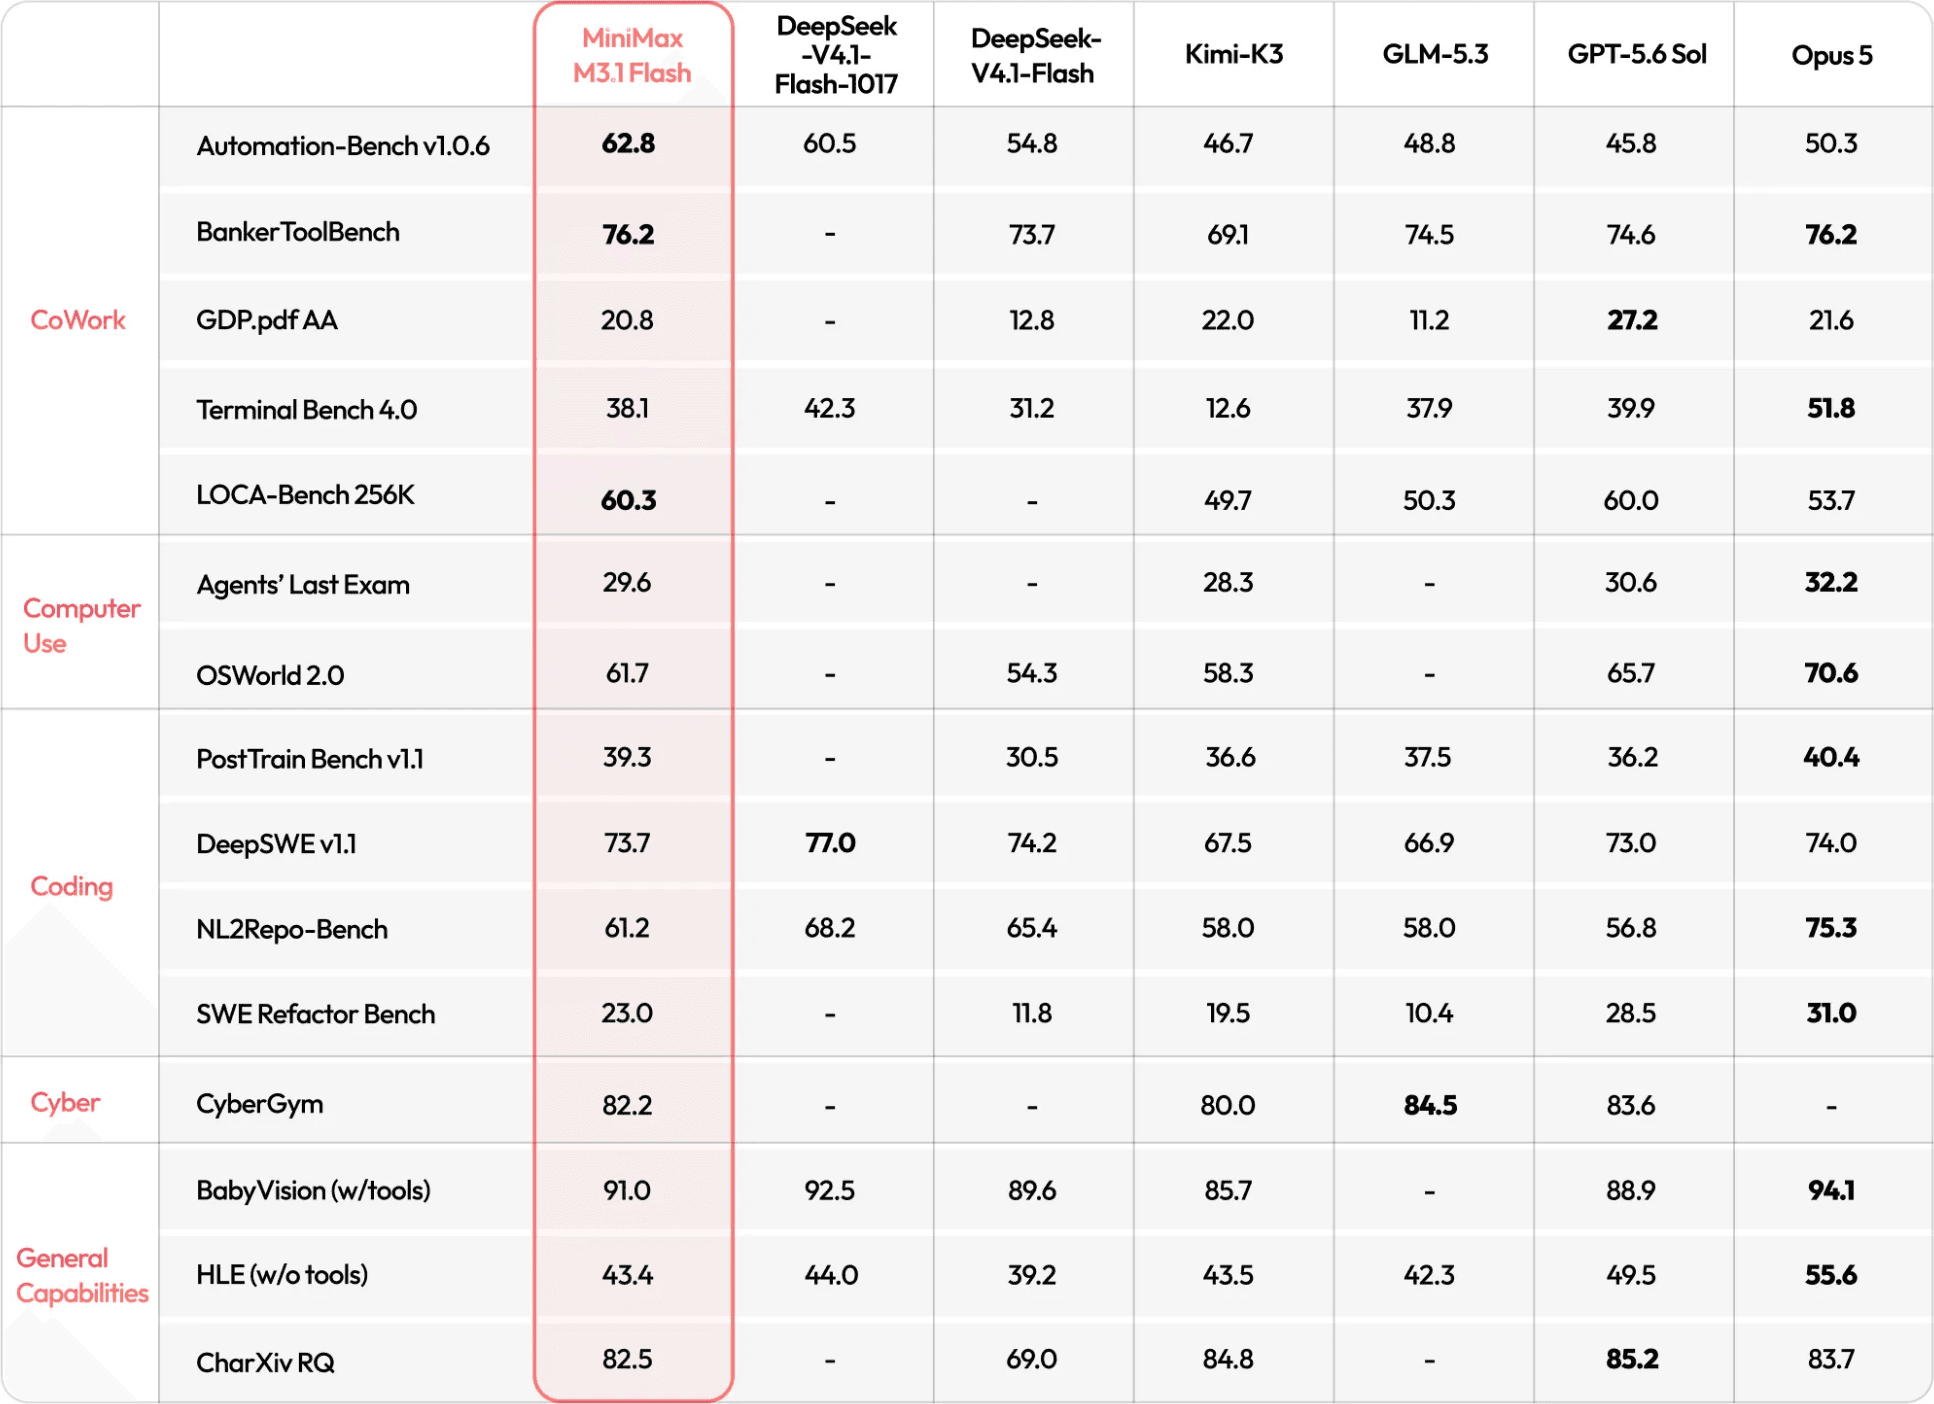
Тесты производительности ставят MiniMax M3.1 Flash выше всех моделей во внутренних сравнениях MiniMax на AutomationBench и LOCA-Bench 256K, а также на уровне Claude Opus 5 на BankerToolBench. Ранняя версия этой модели под названием «Space Bunny Alpha» уже продемонстрировала масштабируемость, обработав более 200 триллионов токенов.
Ключом к эффективности модели стали архитектурные улучшения и техники квантования. Традиционный глобальный механизм grouped-query attention заменён разреженным вниманием (sparse attention), ограничивающим каждый токен в чтении только части контекста. Плотные многослойные перцептроны (MLPs) сохранены только в первых трёх слоях, снижая вычислительную нагрузку и движение памяти, особенно для длинных контекстных вводов.
Кроме того, MiniMax применил агрессивное квантование: веса MLP, веса attention, индексатор и общие компоненты экспертов заквантованы до точности MXFP8, а веса маршрутизируемых экспертов используют NVFP4. Такой подход позволяет сохранить или немного улучшить возможности модели по сравнению с неквантованным M3.
Tenstorrent обслуживает MiniMax M3.1 Flash на суперкустере, состоящем из нескольких систем Blackhole Galaxy. Они специализированы и разделены на функции prefill и decode, оптимизированные под свои нагрузки. Prefill обрабатывает входящие запросы агентов на множестве чипов с высокой межустройственной пропускной способностью, а decode-системы генерируют выходные токены независимо, обеспечивая отзывчивость во время длительных операций prefill. Связь между чипами осуществляется по низколатентным Ethernet-линиям, а данные, такие как веса и кеш ключ-значение, хранятся в встроенных DRAM и SRAM для скорости.
Особенностью является offload кеша ключ-значение, который хранит повторно используемые контекстные состояния в больших пулах DRAM и SSD (1 ТБ DRAM и несколько терабайт SSD на систему), минимизируя избыточные вычисления при повторяющихся взаимодействиях агентов.
Тюнинг Tenstorrent использует трассировки кодирования агентов AgentX от SemiAnalysis, основанные на реальных многоходовых сессиях и поведении субагентов, а не на коротких чат-бенчмарках.
Модель MiniMax M3.1 Flash доступна через облачную консоль Tenstorrent, позволяя разработчикам экспериментировать в среде Playground или интегрироваться напрямую с агентскими фреймворками.
Это развертывание демонстрирует синергию передового проектирования моделей, оптимизации аппаратного обеспечения и облачной инфраструктуры, направленную на практические приложения AI-агентов с уменьшенными затратами и высокой производительностью.

Источники и первоисточники
Read the original source ↗
Комментарии (0)
Комментариев пока нет. Начните обсуждение.
Написать комментарий
Комментарии публикуются после модерации. Ваше имя и комментарий будут видны всем. Аккаунт