
Tenstorrent uruchamia MiniMax M3.1 Flash — model AI na chmurze z ulepszoną efektywnością
Image: Tenstorrent · Source
Tenstorrent uruchomił model MiniMax M3.1 Flash na swojej platformie chmurowej, oferując znaczne obniżenie kosztów i wysoką wydajność w zadaniach agentów dzięki innowacjom architektonicznym i kwantyzacji modelu.
Tenstorrent ogłosił wdrożenie modelu AI MiniMax M3.1 Flash na swojej platformie chmurowej, realizując zarówno procesy prefill, jak i decode na swojej autorskiej infrastrukturze superklastra Galaxy®. Jednocześnie MiniMax udostępnił otwarte wagi modelu, umożliwiając użytkownikom zastosowanie tej zaawansowanej sztucznej inteligencji w różnych aplikacjach.
MiniMax M3.1 Flash jest zaprojektowany do zadań agentów na skalę produkcyjną, osiągając około 70% niższe koszty operacyjne w porównaniu do swojego poprzednika, MiniMax M3. W szczególności redukuje koszt na milion tokenów wejściowych do 0,15 USD i tokenów wyjściowych do 0,60 USD, co stanowi połowę ceny poprzedniego modelu. Koszty tokenów wejściowych z pamięci podręcznej są jeszcze niższe, wynosząc 0,015 USD za milion tokenów.
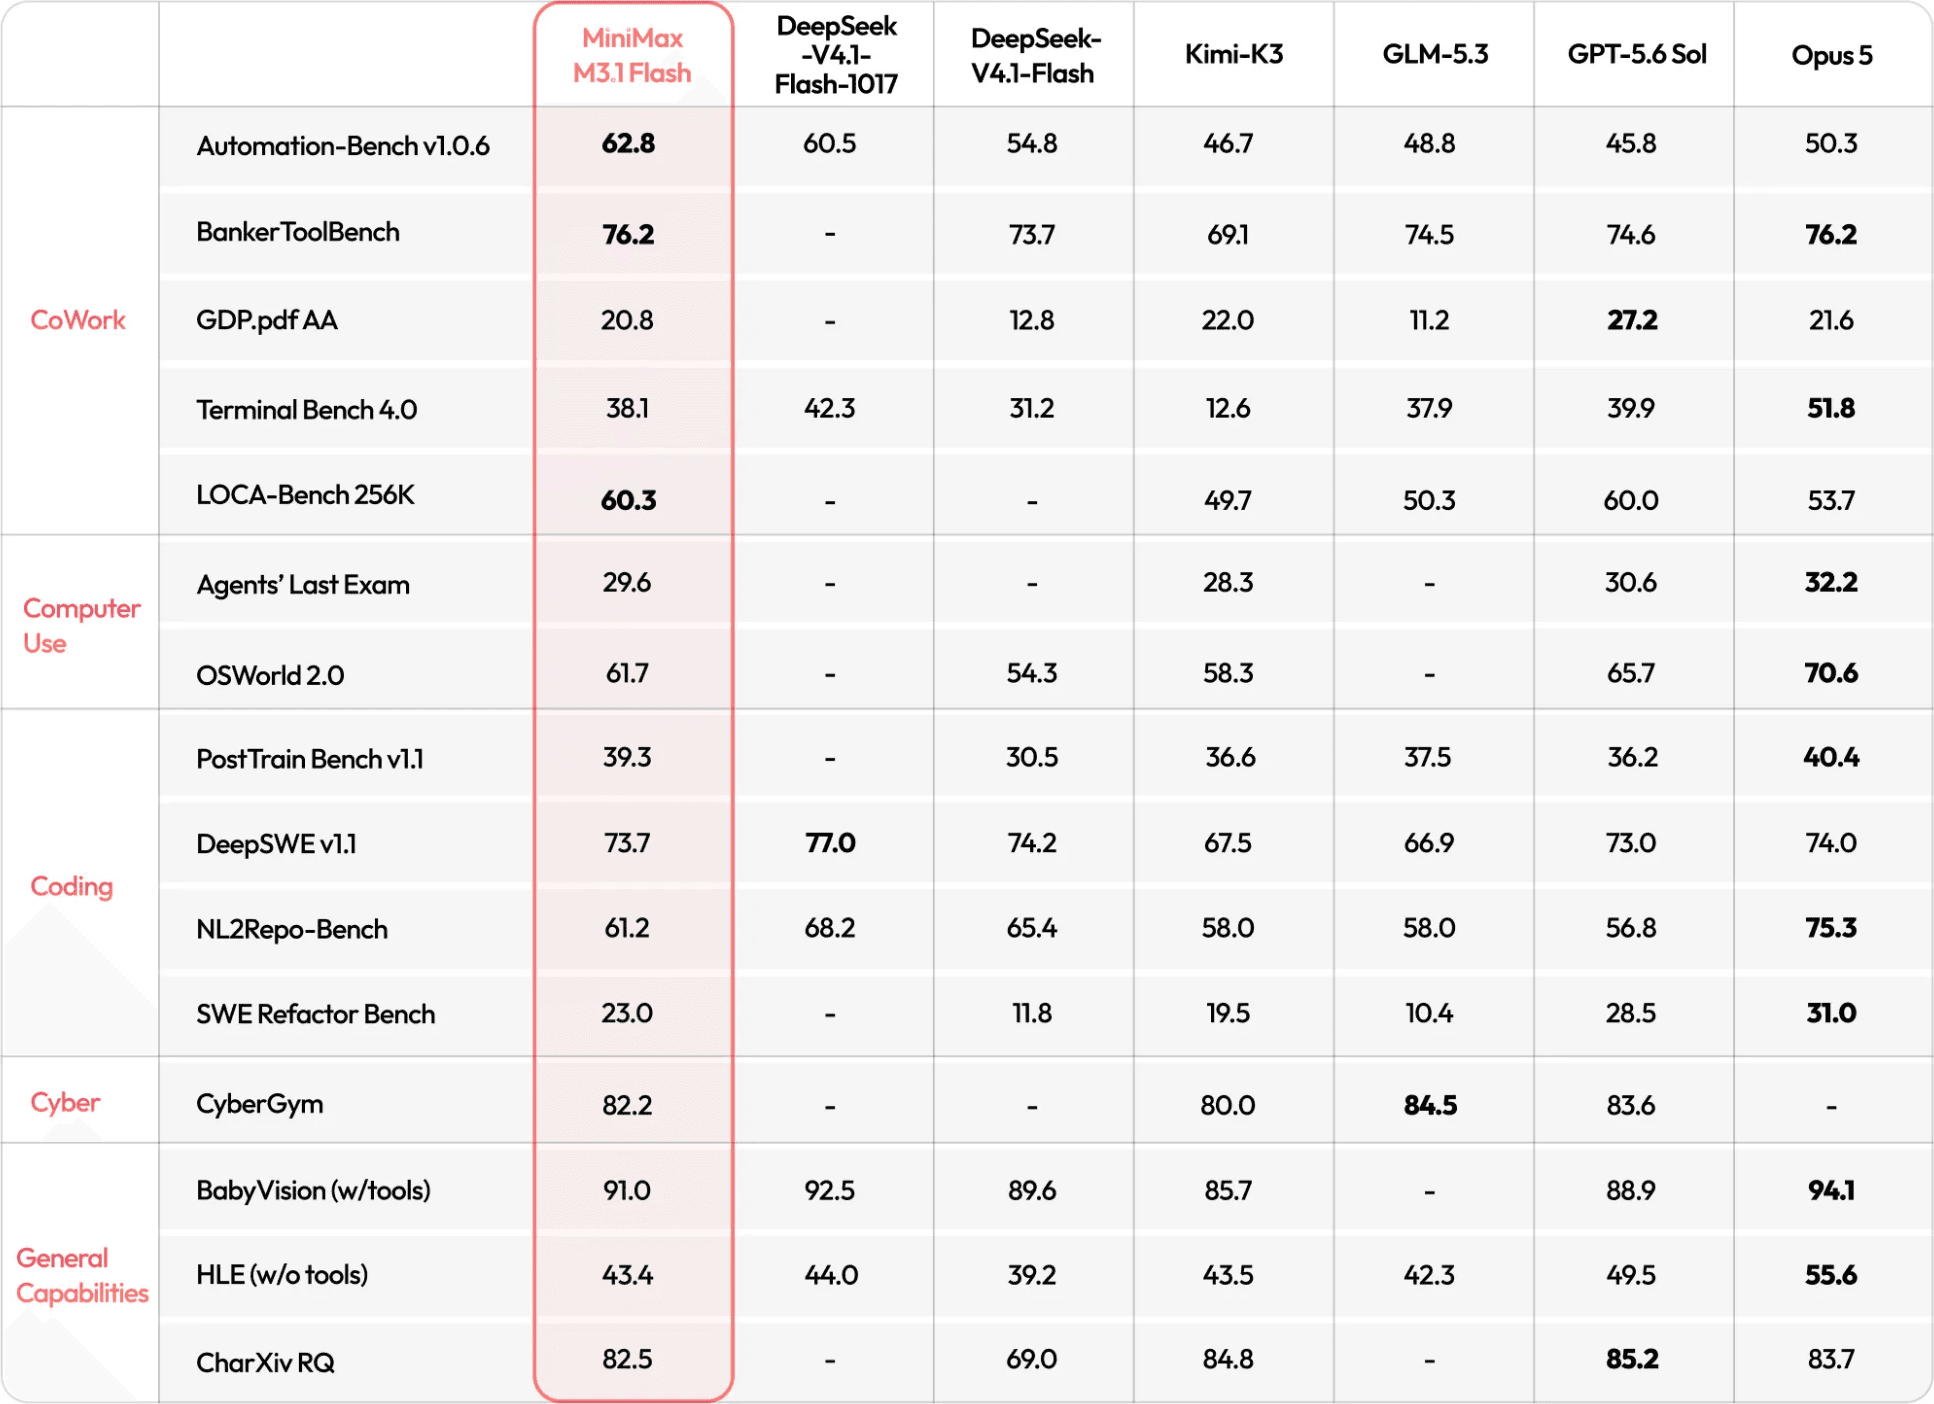
Testy wydajności plasują MiniMax M3.1 Flash przed wszystkimi modelami w wewnętrznych porównaniach MiniMax na AutomationBench i LOCA-Bench 256K, a także na równi z modelem Claude Opus 5 na BankerToolBench. Wczesna wersja tego modelu, nazwana „Space Bunny Alpha”, już wykazała skalowalność, przetwarzając ponad 200 bilionów tokenów.
Kluczem do efektywności modelu są ulepszenia architektoniczne oraz techniki kwantyzacji. Tradycyjny globalny mechanizm attention z grupowaniem zapytań został zastąpiony przez sparse attention, ograniczający każdy token do odczytu tylko części kontekstu. Gęste wielowarstwowe perceptrony (MLP) zachowano tylko w pierwszych trzech warstwach, zmniejszając obciążenie obliczeniowe i ruch pamięciowy, szczególnie dla długich wejść kontekstowych.
Dodatkowo MiniMax zastosował agresywną kwantyzację: wagi MLP, wagi attention, indexer oraz komponenty wspólne ekspertów zostały zakwantyzowane do precyzji MXFP8, natomiast wagi ekspertów trasowanych używają NVFP4. To podejście pozwala zachować lub nieco poprawić możliwości modelu w porównaniu do niekwantyzowanego M3.
Tenstorrent udostępnia MiniMax M3.1 Flash na superklastrze złożonym z wielu systemów Blackhole Galaxy, podzielonych na funkcje prefill i decode, zoptymalizowanych pod kątem swoich zadań. Prefill obsługuje przychodzące zapytania agentów na wielu chipach z wysoką przepustowością między urządzeniami, a systemy decode generują tokeny wyjściowe niezależnie, zapewniając responsywność podczas długich operacji prefill. Komunikacja między chipami odbywa się za pomocą niskolatencyjnych łączy Ethernet, a dane takie jak wagi i cache kluczy-wartości są przechowywane w pamięciach DRAM i SRAM na urządzeniach dla szybkości.
Wyróżniającą cechą jest offload cache kluczy-wartości, który przechowuje ponownie używane stany kontekstowe w dużych pulach pamięci DRAM i SSD (1 TB DRAM i kilka terabajtów SSD na system), minimalizując redundancyjne obliczenia podczas powtarzających się interakcji agenta.
Dopasowanie Tenstorrent wykorzystuje ślady kodowania agentów AgentX SemiAnalysis, pochodzące z rzeczywistych sesji wielokrotnych tur i zachowań subagentów, zamiast opierać się na krótkich benchmarkach czatowych.
Model MiniMax M3.1 Flash jest obecnie dostępny przez konsolę chmurową Tenstorrent, umożliwiając deweloperom eksperymentowanie w środowisku Playground lub integrację bezpośrednio z frameworkami agentów.
To wdrożenie stanowi przykład synergii zaawansowanego projektowania modelu, optymalizacji sprzętowej i infrastruktury chmurowej, ukierunkowanej na praktyczne zastosowania agentów AI z obniżonymi kosztami i wysoką wydajnością.

Źródła i oryginalne doniesienia
Read the original source ↗
Komentarze (0)
Nie ma jeszcze komentarzy.
Napisz komentarz
Komentarze publikujemy po moderacji. Nazwa i komentarz będą publiczne. Konto