
Tenstorrent lanserar MiniMax M3.1 Flash AI-modell i molnet med förbättrad effektivitet
Bild: Tenstorrent · Källa
Tenstorrent erbjuder nu MiniMax M3.1 Flash-modellen på sin molnplattform, med betydande kostnadsreduktioner och stark prestanda i agentuppgifter genom arkitektoniska innovationer och modellkvantisering.
Tenstorrent meddelade att man har distribuerat MiniMax M3.1 Flash AI-modellen på sin molnplattform, där både förfyllning och avkodningsprocesser körs på dess egenutvecklade Galaxy® superklusterinfrastruktur. MiniMax släppte samtidigt modellens öppna vikter, vilket gör det möjligt för användare att utnyttja denna avancerade AI för olika applikationer.
MiniMax M3.1 Flash är utformad för produktionsskaliga agentuppgifter och uppnår cirka 70 % lägre driftskostnader jämfört med föregångaren MiniMax M3. Specifikt sänks kostnaden per miljon ingångstoken till 0,15 dollar och utgångstoken till 0,60 dollar, vilket motsvarar hälften av priset för den tidigare modellen. Kostnaden för cachade ingångstoken är ännu lägre, 0,015 dollar per miljon token.
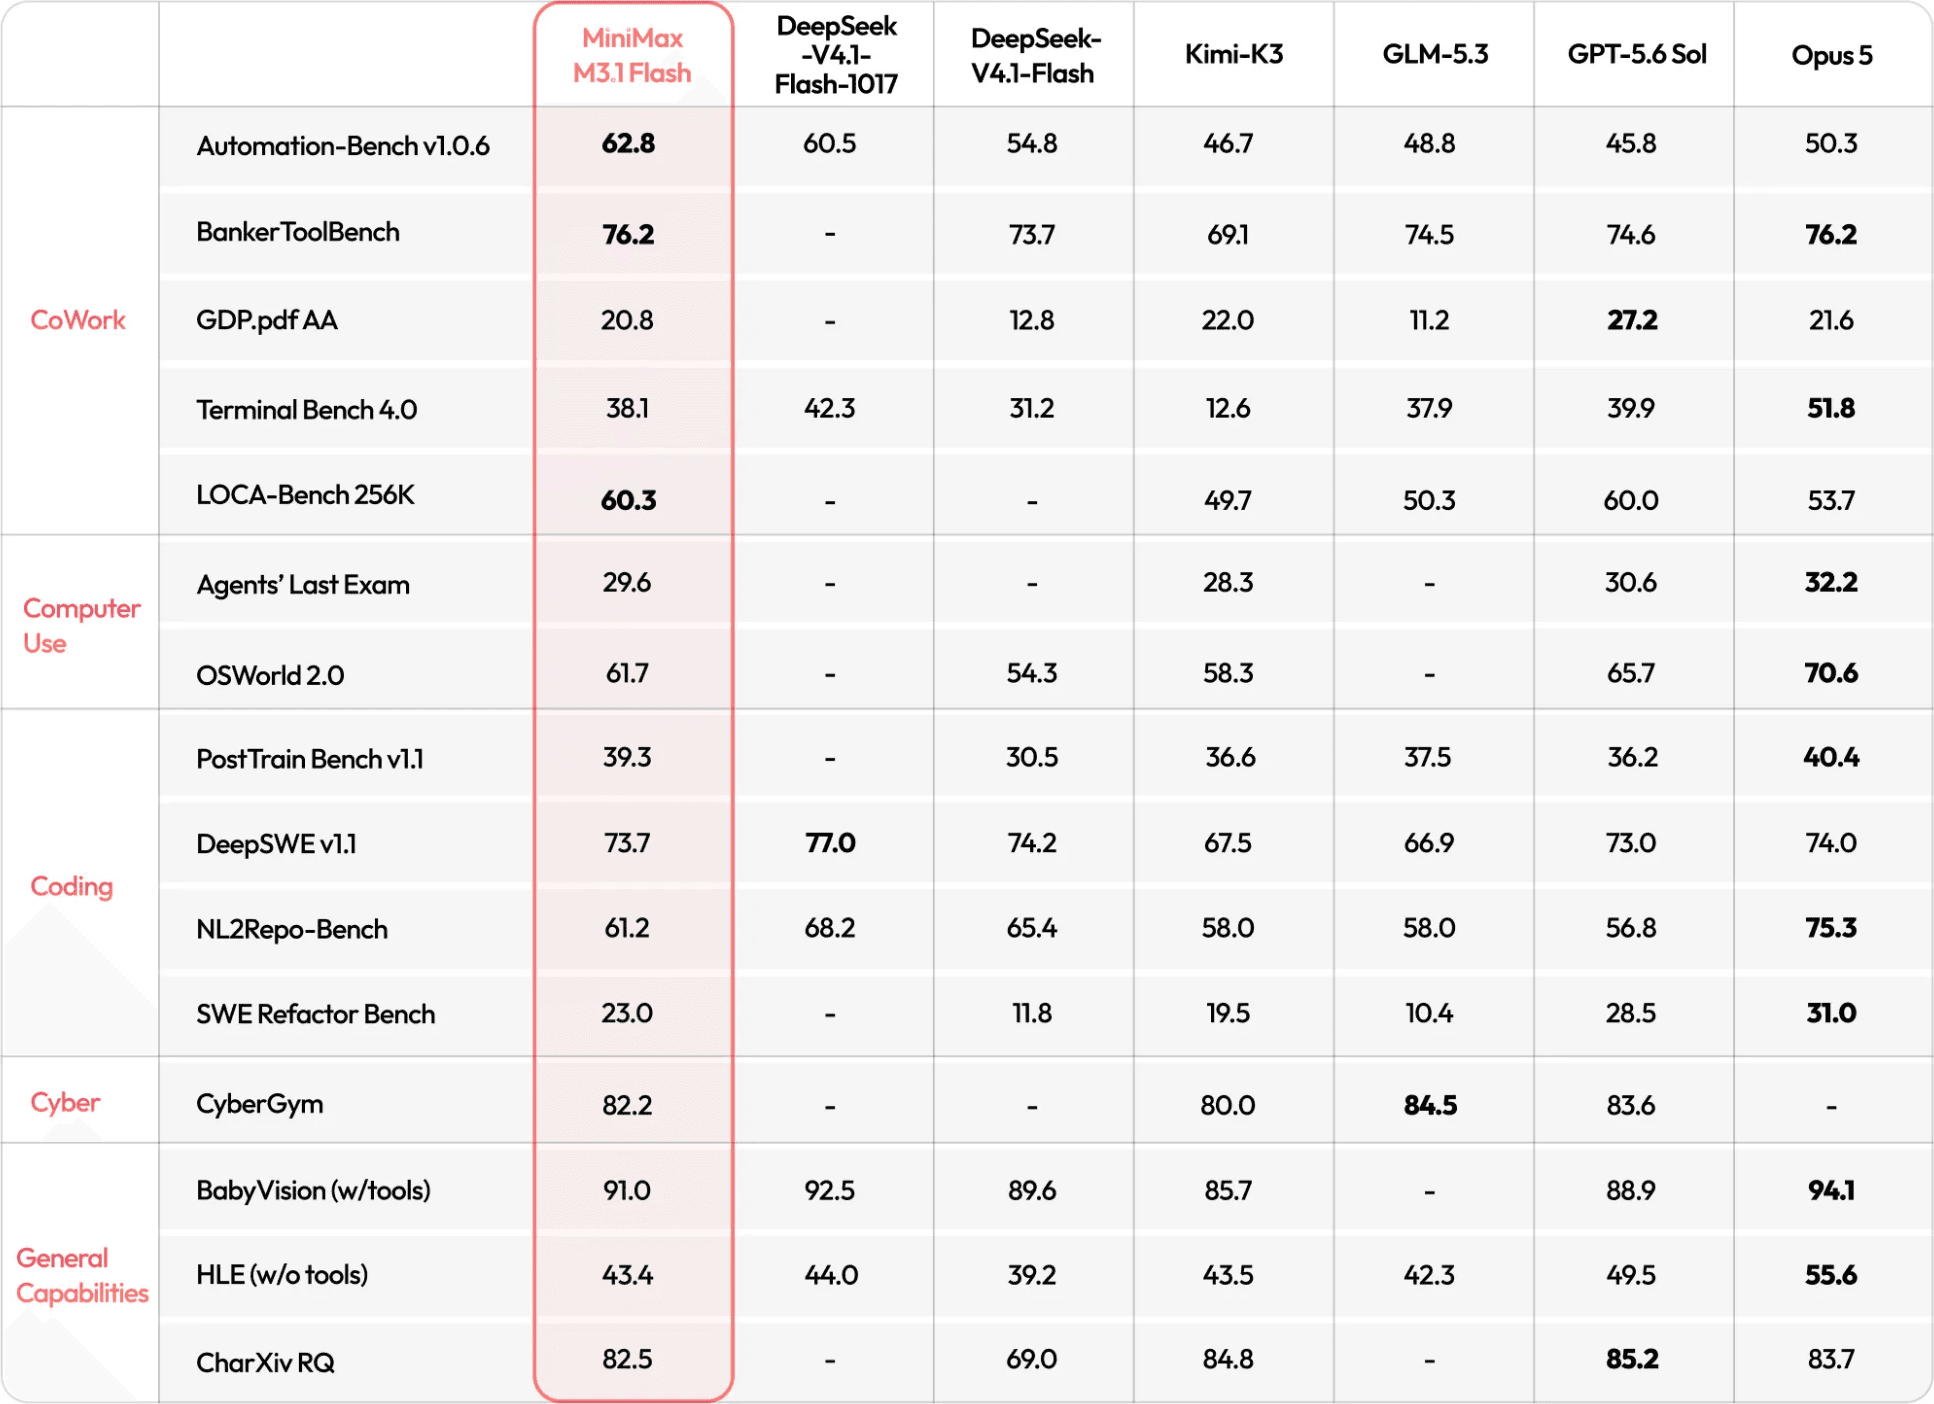
Prestandatest placerar MiniMax M3.1 Flash före alla modeller i MiniMax interna jämförelser på AutomationBench och LOCA-Bench 256K, och den matchar Claude Opus 5 på BankerToolBench. En tidig version av modellen, kallad ”Space Bunny Alpha”, har redan visat skalbarhet genom att bearbeta över 200 biljoner token.
Nytt för modellens effektivitet är arkitektoniska förbättringar och kvantiseringstekniker. Den traditionella globala grupperade query-uppmärksamhetsmekanismen ersattes med gles uppmärksamhet, där varje token bara läser en del av kontexten. Täta multilagerperceptroner (MLP) behålls endast i de första tre lagren, vilket minskar beräkningsbelastning och minnestrafik, speciellt för långa kontextinmatningar.
Dessutom använder MiniMax aggressiv kvantisering: MLP-vikter, uppmärksamhetsvikter, indexerare och delade expertkomponenter kvantiseras till MXFP8-precision, medan routed expert-vikter använder NVFP4. Denna metod möjliggör bibehållen eller något förbättrad modellkapacitet jämfört med den okvantiserade M3.
Tenstorrent serverar MiniMax M3.1 Flash på ett superkluster som består av flera Blackhole Galaxy-system. Dessa är specialiserade och uppdelade i funktionerna för förfyllnad och avkodning, optimerade för sina respektive arbetsbelastningar. Förfyllnaden hanterar inkommande agent-promptar över många chips med hög bandbredd mellan enheter, medan avkodningssystem genererar utgångstoken oberoende och säkerställer snabb respons under långa förfyllnadsoperationer. Kommunikation mellan chips sker via låglatens Ethernet-pipelining, och data som vikter och key-value-cache lagras i enhetens DRAM och SRAM för snabbhet.
En anmärkningsvärd funktion är offloading av key-value-cache, som lagrar återanvända kontextuella tillstånd i stora DRAM- och SSD-pooler (1 TB DRAM och flera terabyte SSD per system), vilket minimerar onödig omberäkning vid upprepade agentinteraktioner.
Tenstorrents finjustering använder SemiAnalysis's AgentX kodningsagentspår framtagna från verkliga flerturssessioner och subagentbeteenden, istället för att förlita sig på korta chattbenchmarks.
MiniMax M3.1 Flash-modellen är för närvarande tillgänglig via Tenstorrents molnkonsol, vilket gör det möjligt för utvecklare att experimentera i deras Playground-miljö eller integrera direkt med agentramverk.
Denna distribution exemplifierar samspelet mellan avancerad modellutformning, hårdvaruoptimering och molninfrastruktur, med fokus på praktiska AI-agentapplikationer som erbjuder lägre kostnader och stark prestanda.

Källor och ursprunglig rapportering
Läs den ursprungliga källan ↗
Kommentarer (0)
Inga kommentarer ännu. Börja diskussionen.
Skriv en kommentar
Kommentarer publiceras efter granskning. Ditt namn och kommentar syns offentligt. Konto