
NVIDIA Avanza en la Eficiencia de Memoria para IA con un Enfoque de Codiseño de Pilas Completas
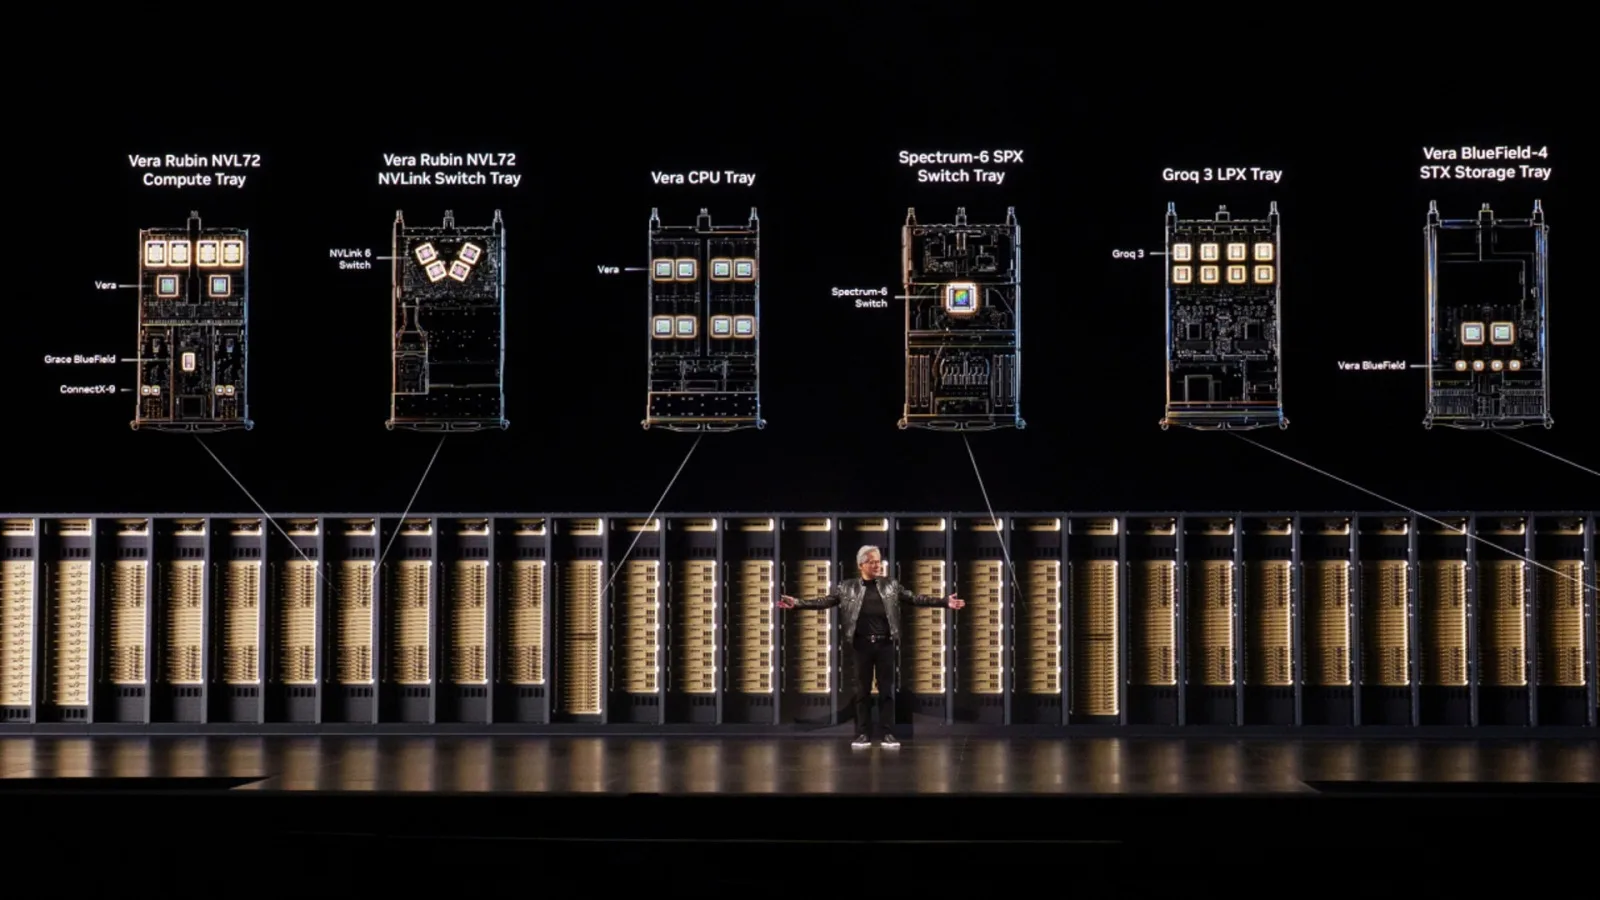
Image: NVIDIA · Source
NVIDIA aborda el creciente demanda de memoria GPU en IA mediante codiseño de pila completa, optimizando el uso de memoria en hardware y software para aumentar el rendimiento y eficiencia a pesar de la limitada capacidad de memoria de alto ancho de banda.
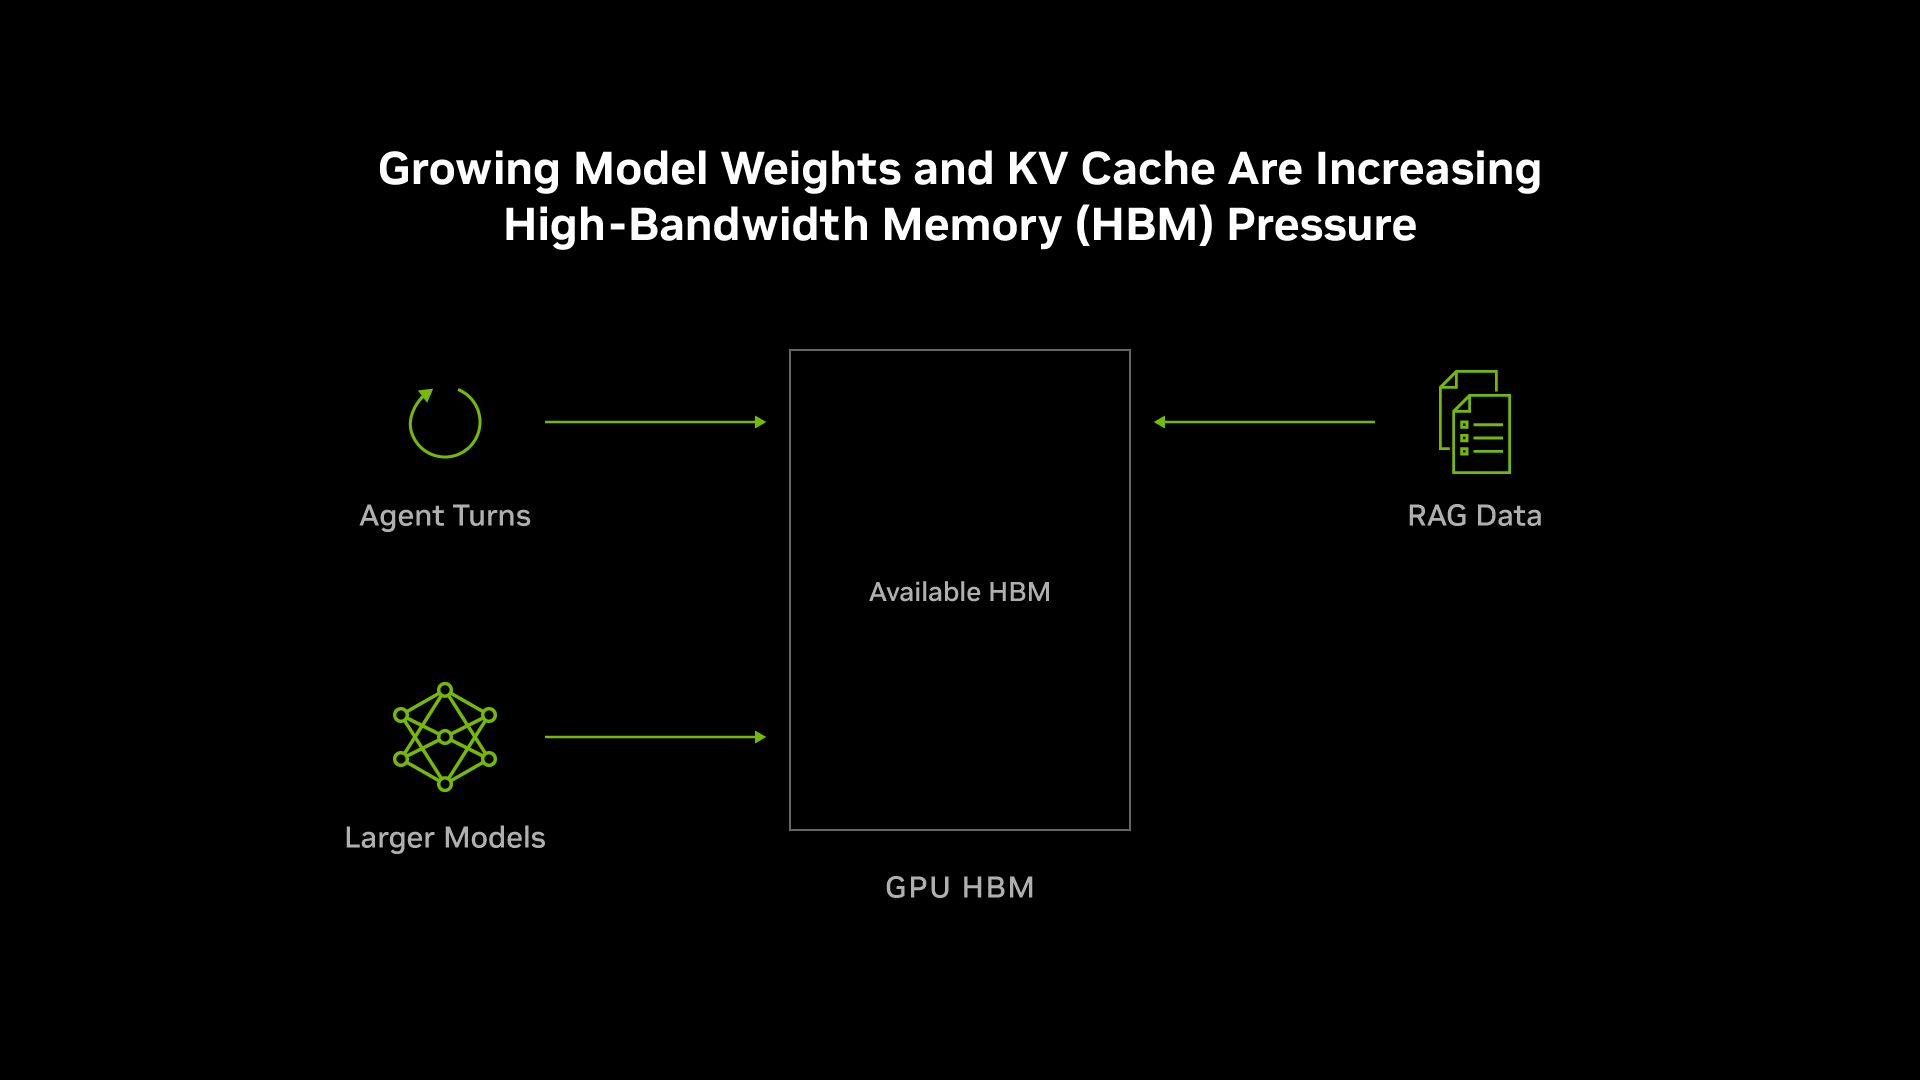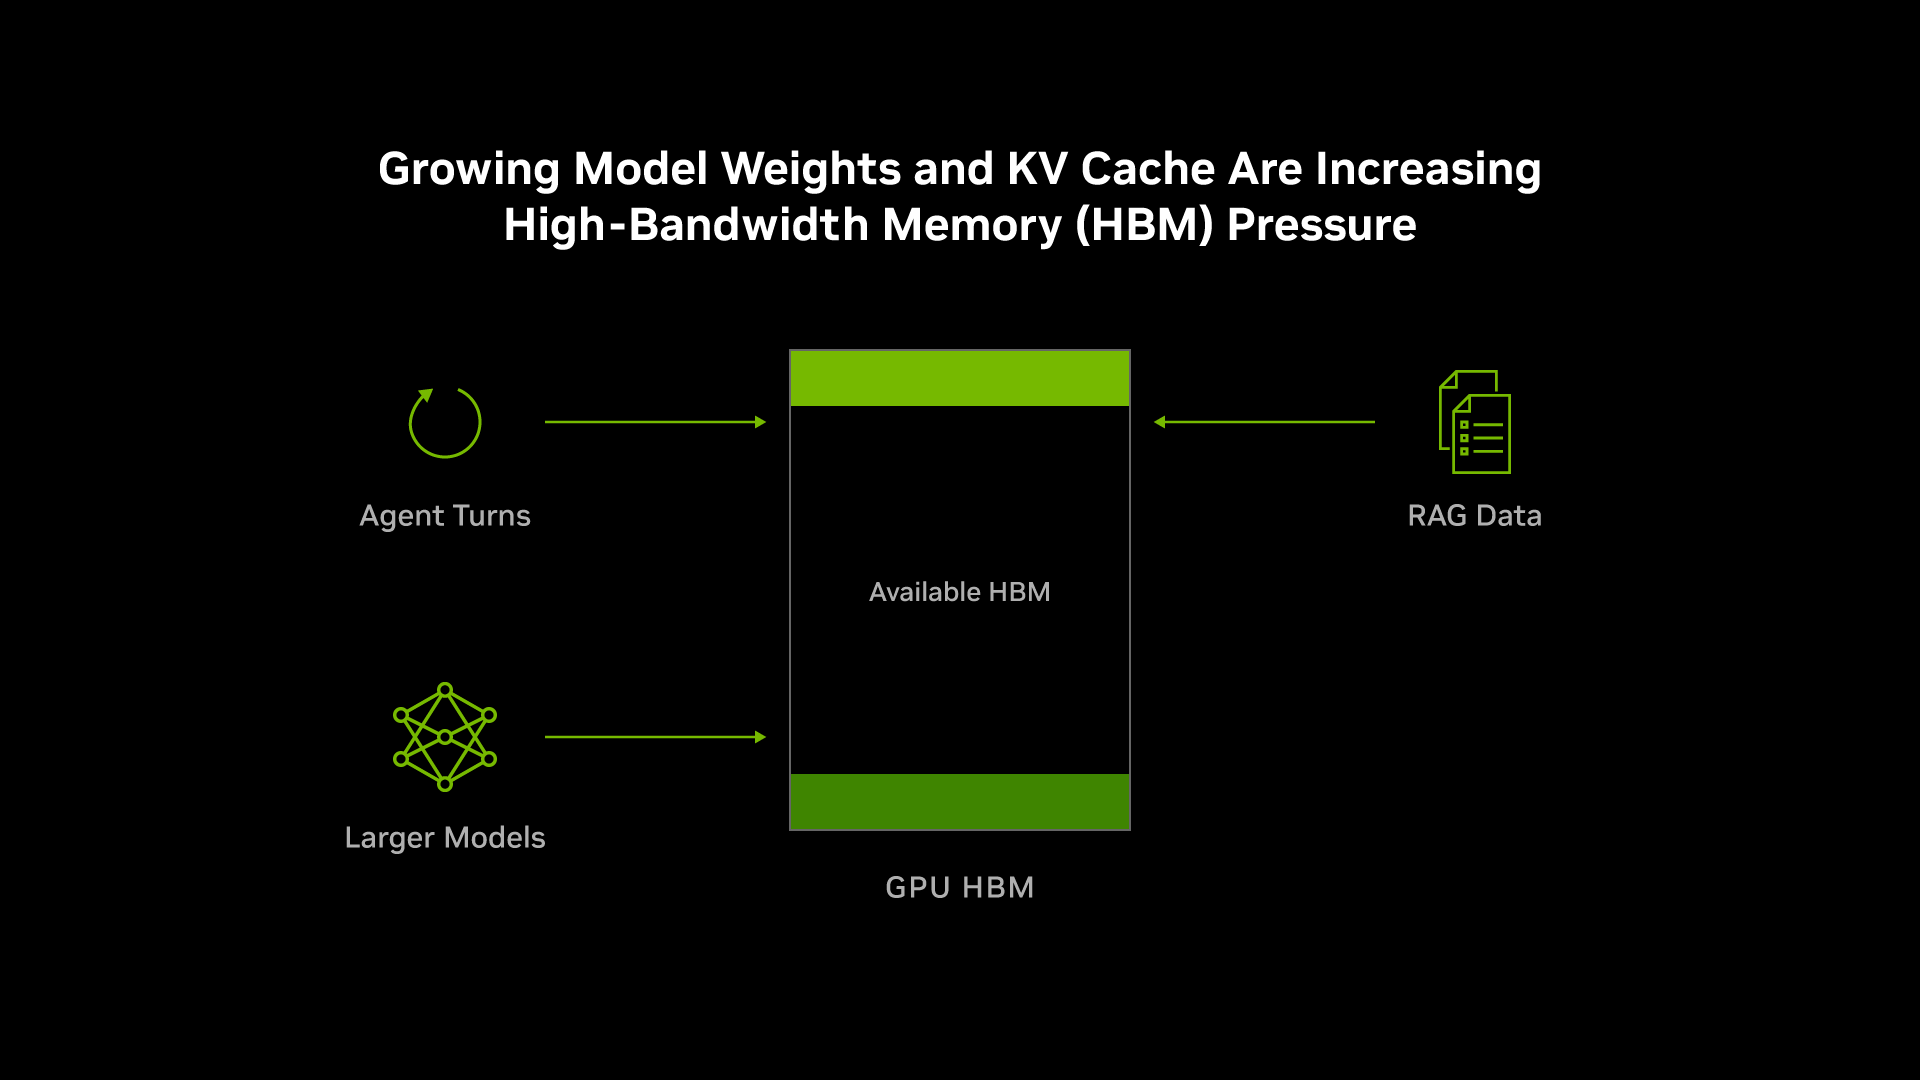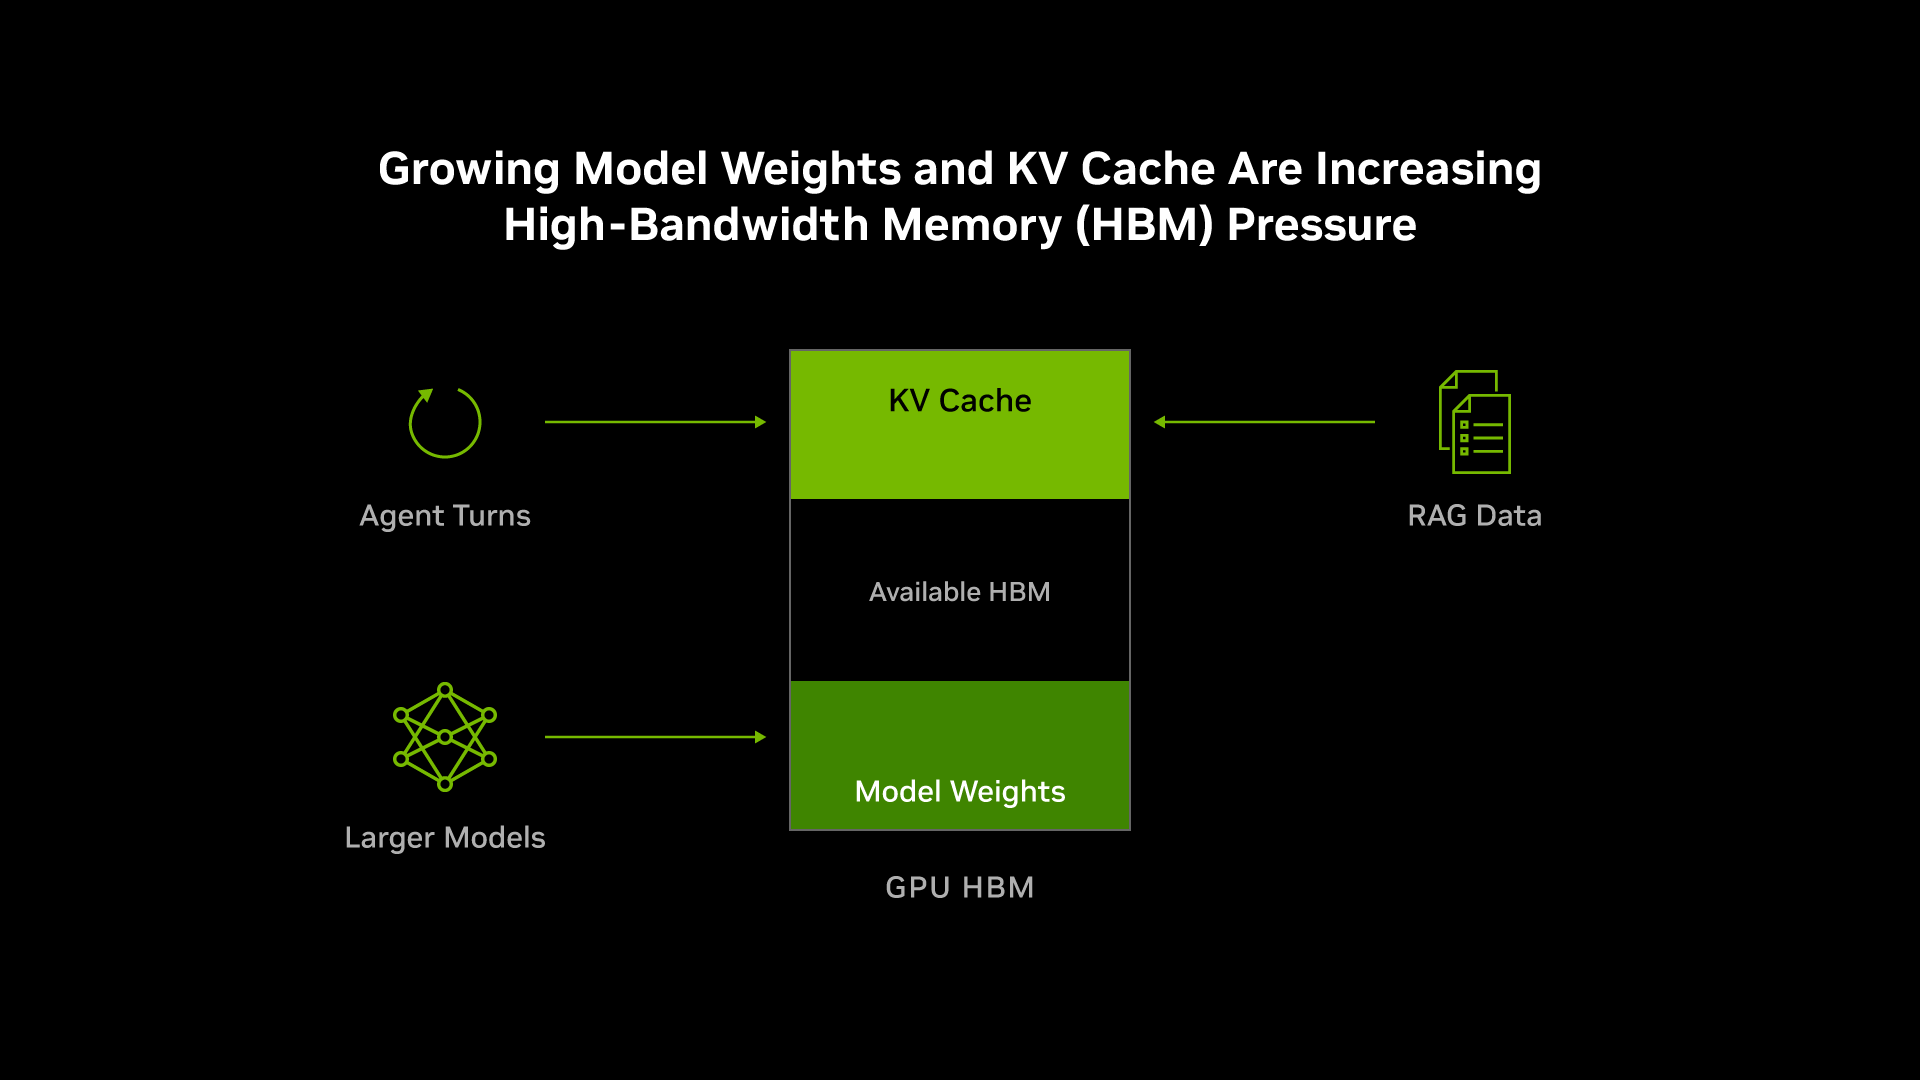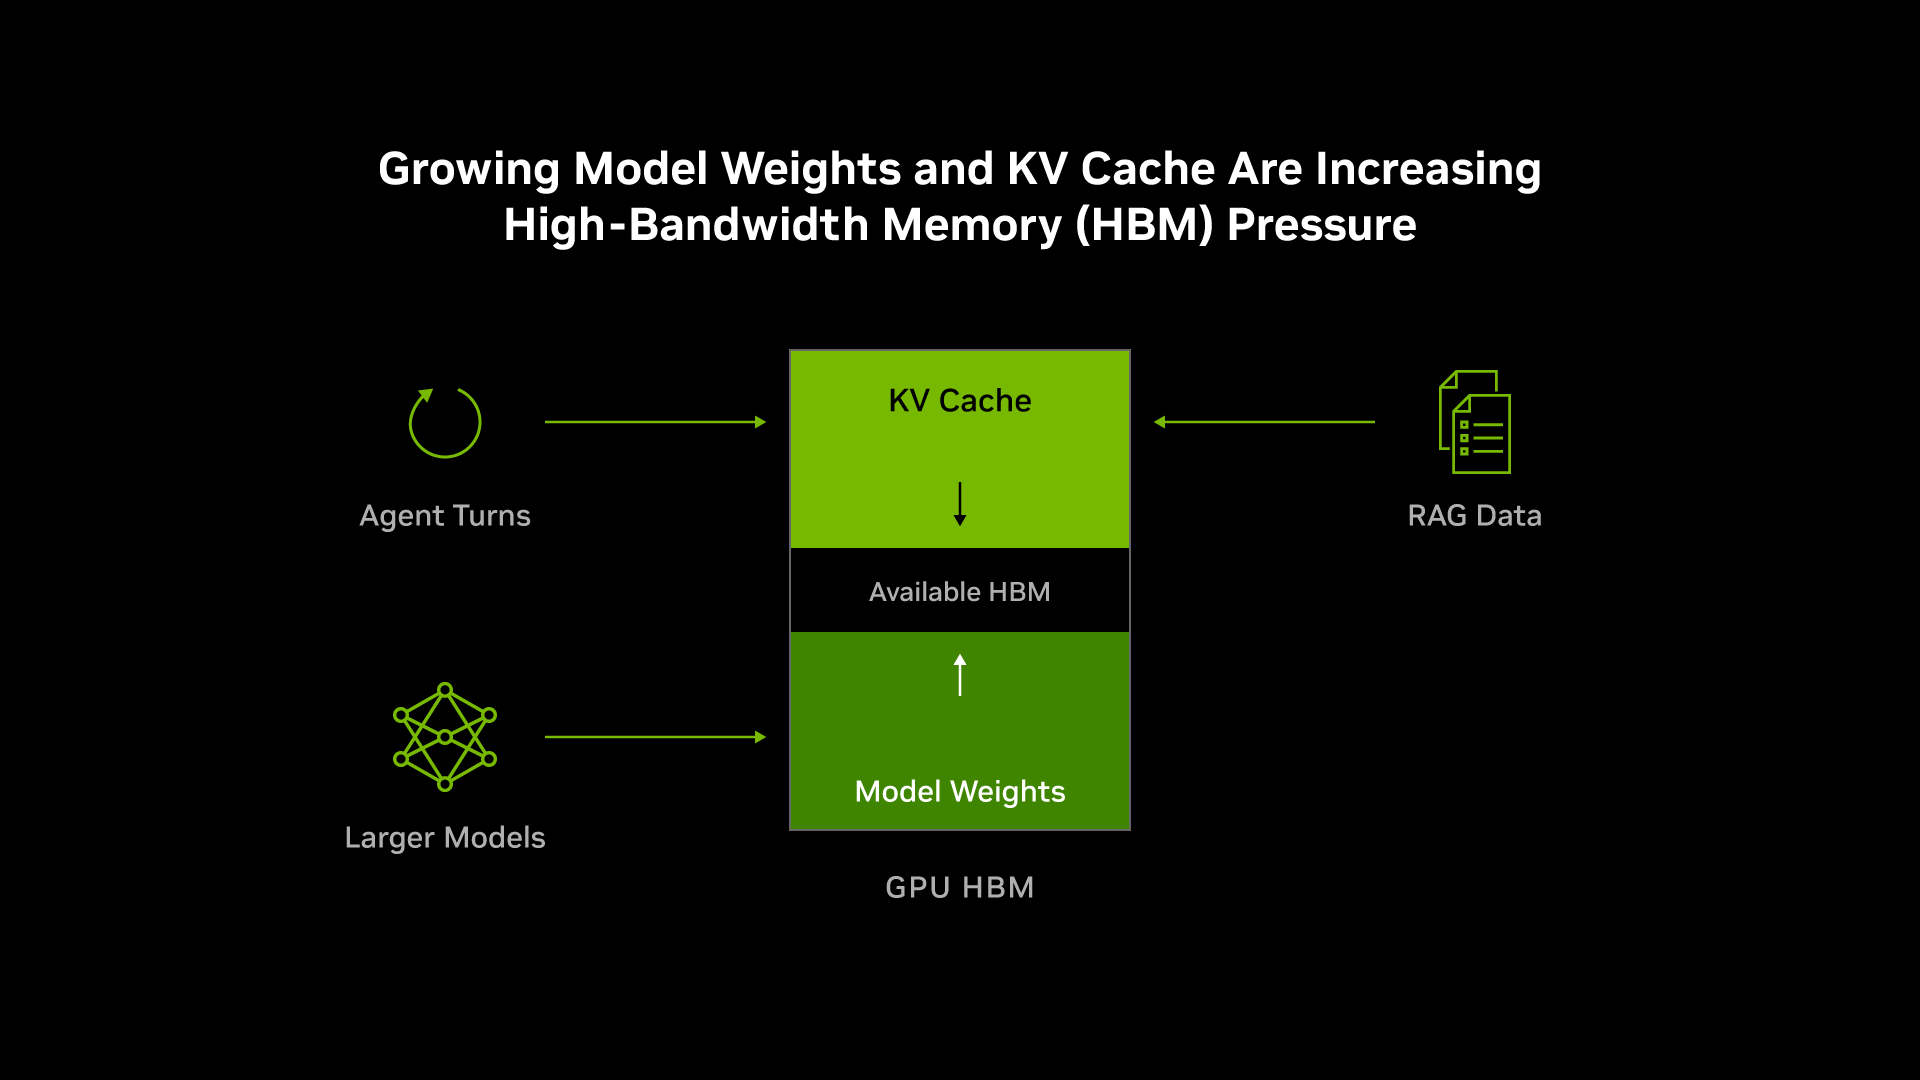
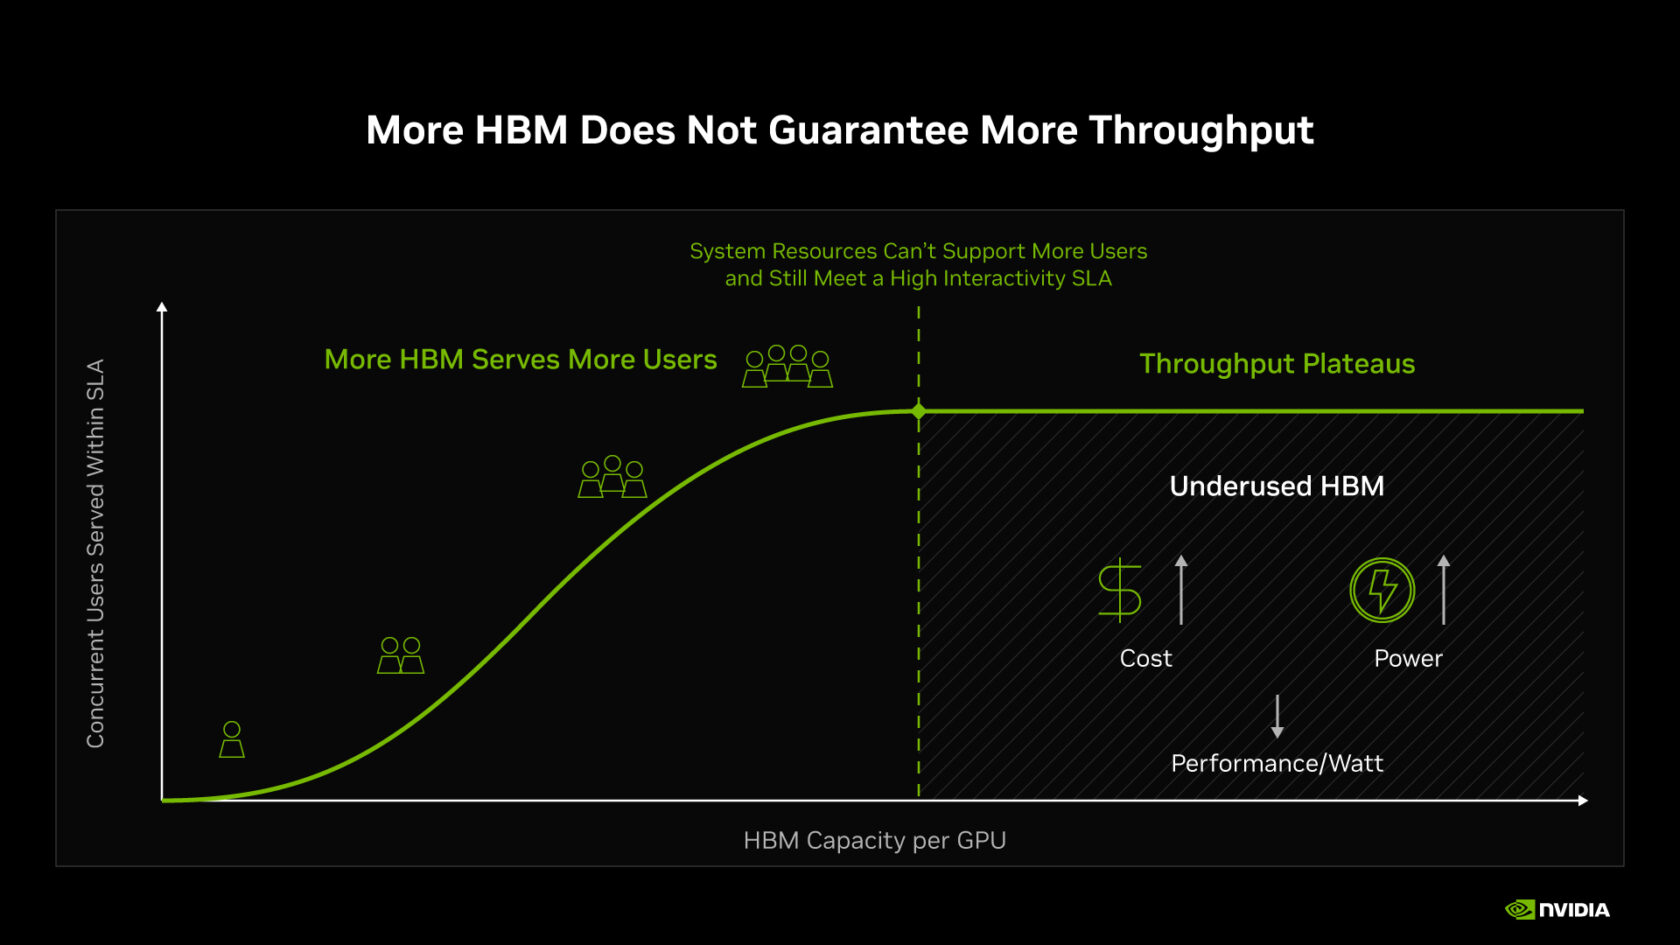
A medida que los modelos de IA crecen en complejidad — con trillones de parámetros, ventanas de contexto más largas y tareas de inferencia más agentes — la demanda de memoria de alto ancho de banda (HBM) en GPUs se intensifica. NVIDIA destaca que esta presión creciente choca con un suministro de memoria limitado y precios en aumento, un desafío que se prevé persistirá en el corto plazo.
En lugar de simplemente aumentar la capacidad de HBM, que enfrenta limitaciones físicas y de costos, NVIDIA se enfoca en el codiseño de pila completa. Esta estrategia implica diseñar de forma conjunta el hardware de GPU, CPUs, redes, sistemas de almacenamiento y software para maximizar el uso efectivo de la memoria en todos los niveles dentro de la cadena de procesamiento de IA — denominado la fábrica de IA.
En estas fábricas de IA existe una jerarquía de memoria: la capa más rápida y costosa es la HBM de la GPU, que almacena pesos del modelo y caché clave-valor (KV) manteniendo el contexto activo. Debajo de esta se encuentran memorias CPU grandes pero más lentas, SSDs locales y almacenamiento compartido — todos intercambiando velocidad por capacidad y eficiencia de costos. El objetivo es reducir la cantidad de datos almacenados en la capa más costosa, reubicar datos inactivos a niveles más económicos y precargar datos rápidamente de vuelta a las GPUs, mejorando el rendimiento y reduciendo la latencia.
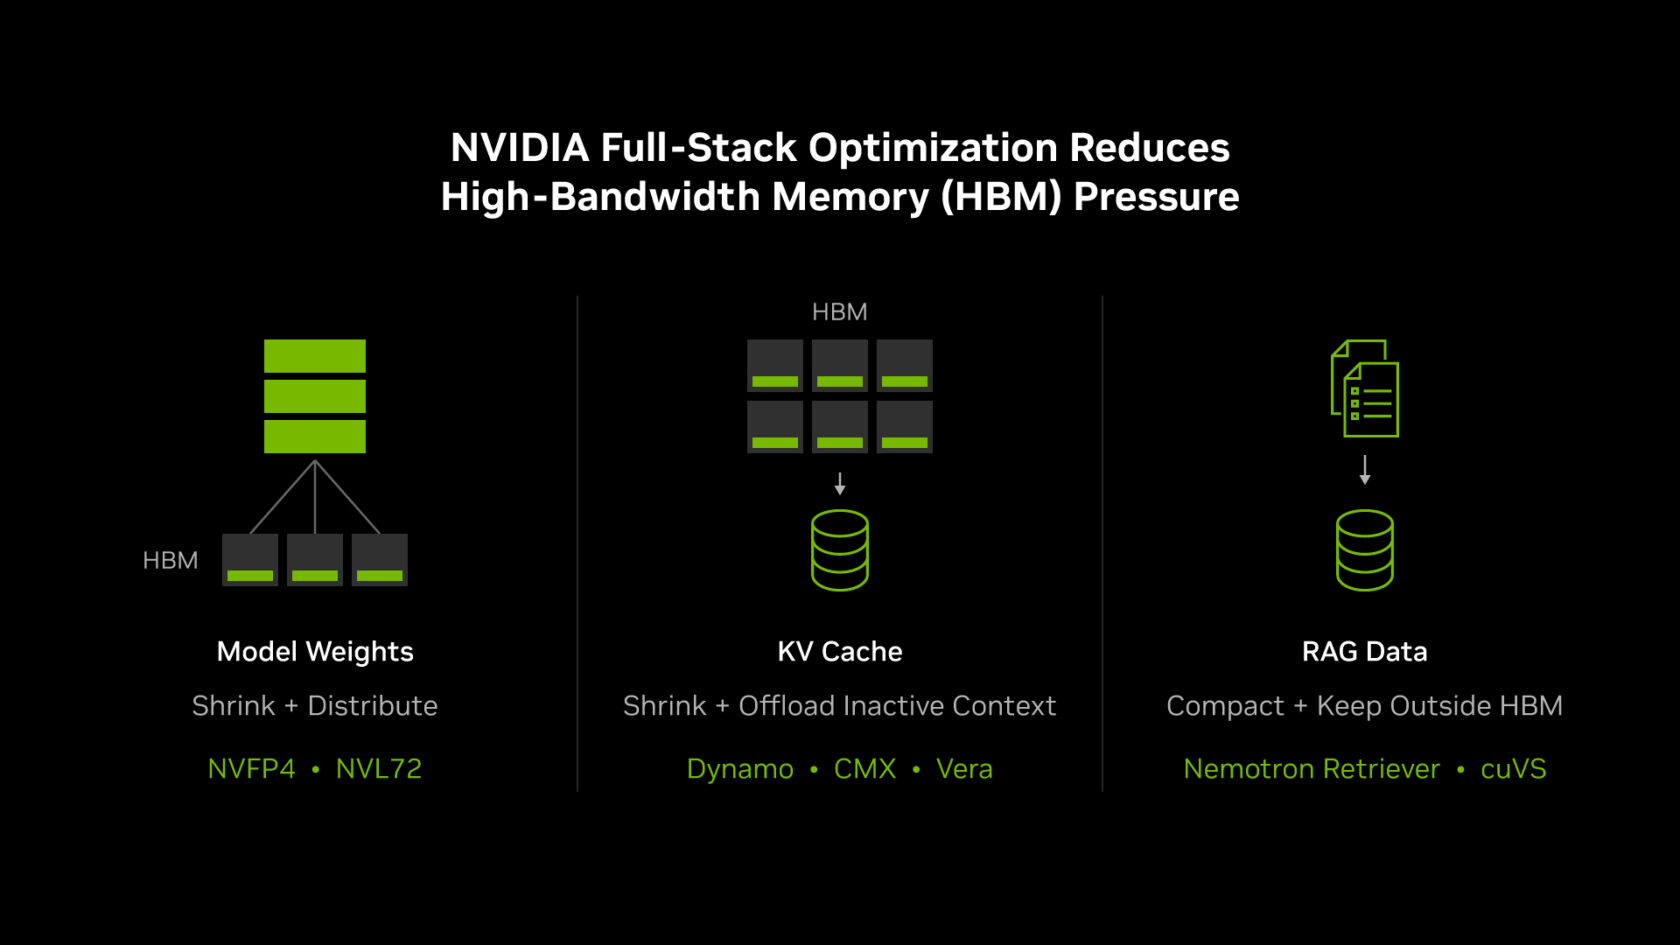
El enfoque de NVIDIA incluye múltiples innovaciones. Primero, adoptar un formato flotante de 4 bits llamado NVFP4 que ayuda a reducir el tamaño de los pesos del modelo y cachés KV, disminuyendo la huella de memoria. Distribuir el modelo completo a través de hasta 72 GPUs dentro del sistema NVL72 libera aún más HBM para caché KV y concurrencia de usuarios.
Segundo, el contexto inactivo de la caché KV puede descargarse de la costosa HBM a memorias grandes conectadas a CPU o niveles de almacenamiento compartido usando el nuevo software de inferencia NVIDIA Dynamo y soluciones de memoria de contexto CMX. Este software administra la caché KV entre memoria GPU, memoria CPU y almacenamiento para permitir una reutilización rápida sin mantener todos los datos constantemente en HBM.
Tercero, técnicas de generación aumentada por recuperación (RAG) reducen la carga de HBM manteniendo grandes bases de conocimiento empresarial fuera de la GPU. En cambio, el Nemotron Retriever de NVIDIA produce incrustaciones vectoriales compactas, y la biblioteca cuVS gestiona el índice buscable a través de CPUs y capas de almacenamiento. Solo pasajes relevantes ingresan al contexto rápido de la GPU.
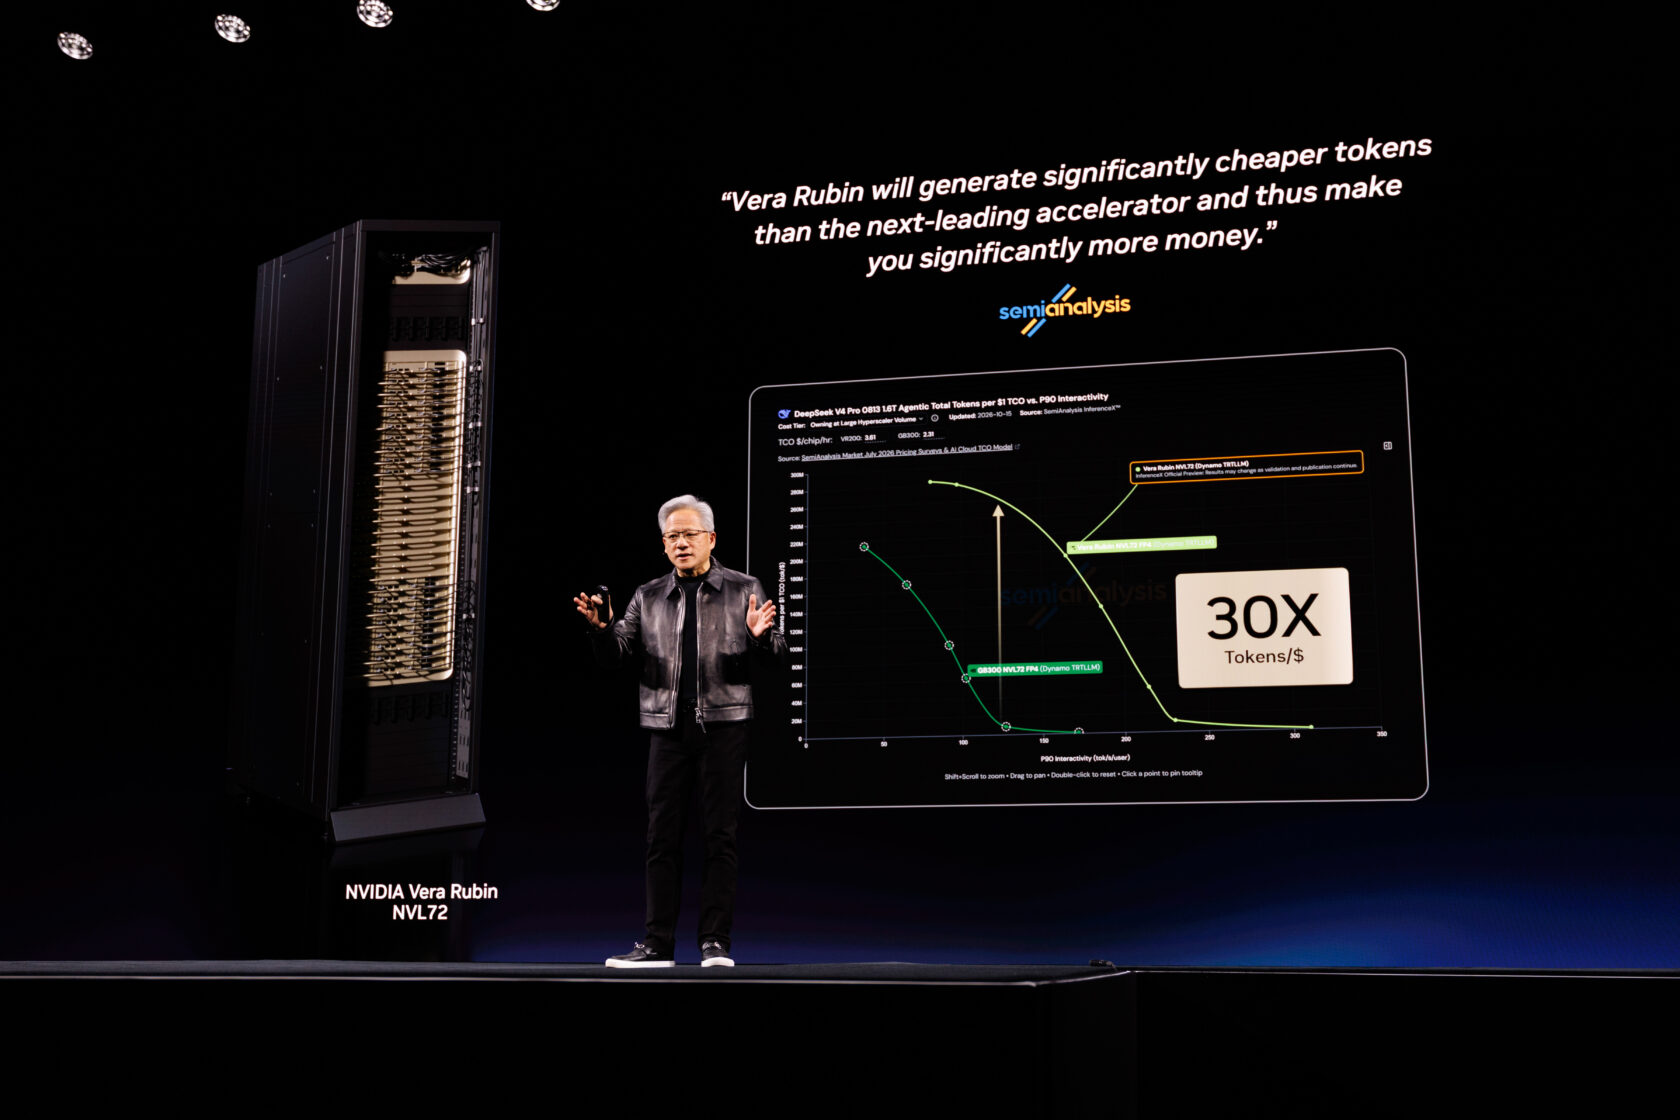
NVIDIA reporta que estas optimizaciones combinadas han generado un aumento aproximado del 3% en la capacidad de HBM por GPU, desde NVIDIA Blackwell Ultra a través de la plataforma Vera Rubin, pero han producido hasta 30 veces más rendimiento agente por dólar en cargas de trabajo de prueba como SemiAnalysis AgentX.
Al abordar las limitaciones de ancho de banda de memoria, la llamada pared de memoria, el codiseño de pila completa de NVIDIA permite a las cargas de trabajo de IA realizar más cálculos útiles por byte de memoria, reduciendo consumo energético y costos. Esta estrategia integral de gestión de memoria marca un cambio desde perseguir capacidad bruta hacia orquestar eficiencia entre hardware y software para las crecientes demandas de IA.
Para un análisis técnico detallado, NVIDIA ofrece un video explicativo y profundización sobre cómo el codiseño de pila completa reduce la presión de memoria en inferencia y mejora la economía de plataformas de IA.
Fuentes e informes originales
Read the original source ↗
Comentarios (0)
Aún no hay comentarios.
Escribe un comentario
Los comentarios se publican tras moderación. Tu nombre y comentario serán públicos. Cuenta