
NVIDIA улучшает эффективность памяти AI с помощью подхода полного совместного проектирования стека
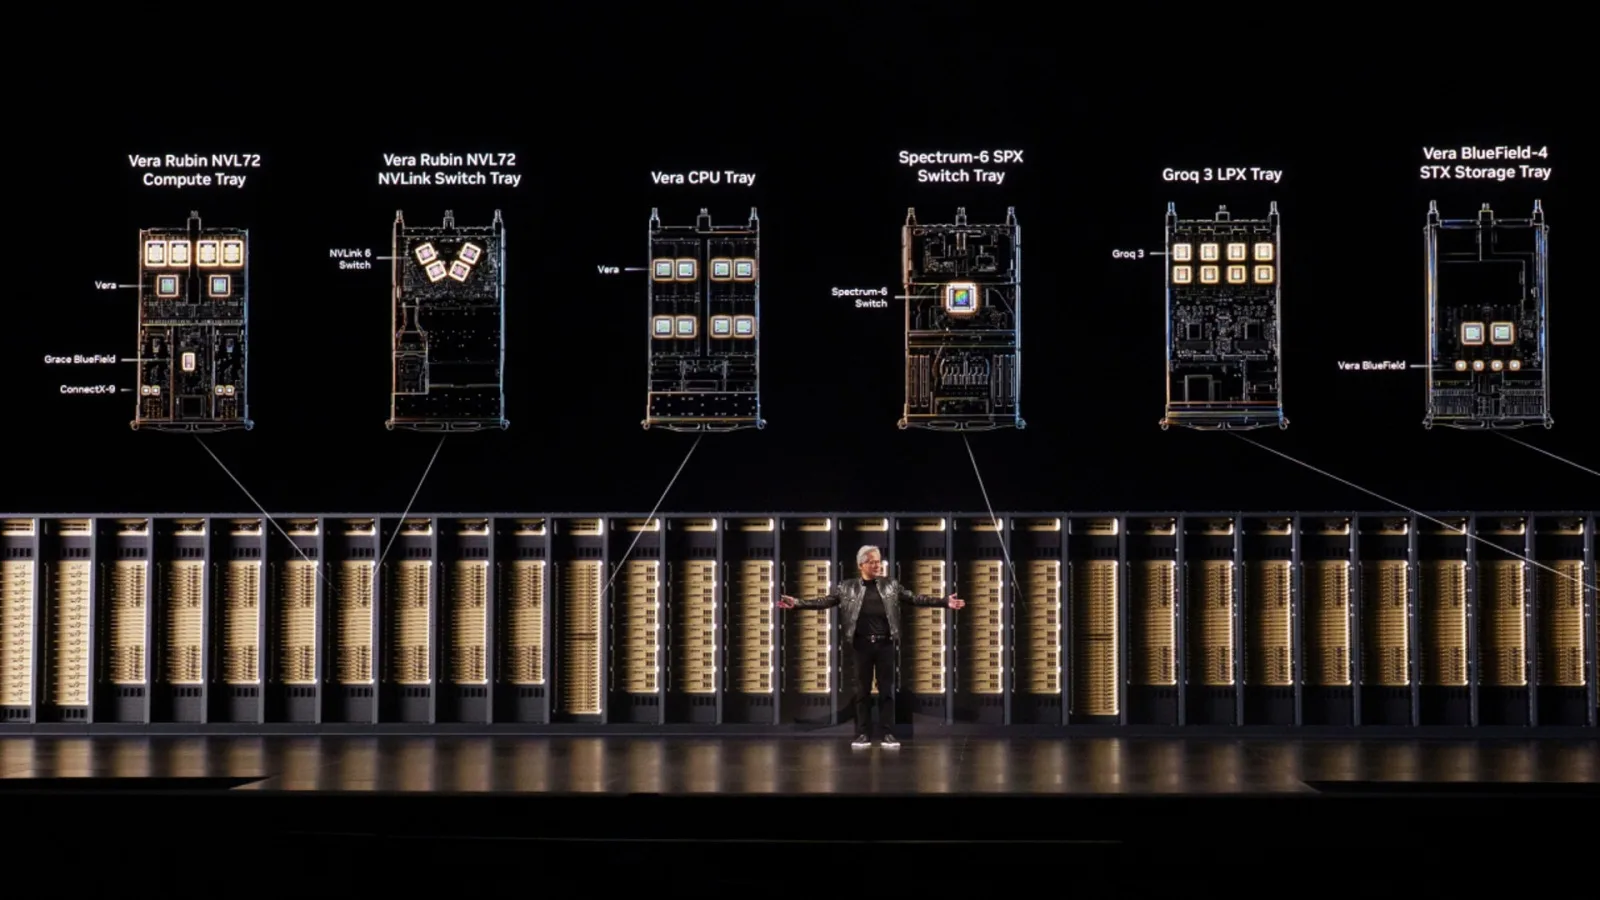
Image: NVIDIA · Source
NVIDIA решает растущие требования к памяти GPU в AI посредством полного совместного проектирования стека, оптимизируя использование памяти на уровне аппаратного и программного обеспечения для повышения пропускной способности и эффективности несмотря на ограниченную емкость памяти с высокой пропускной способностью.
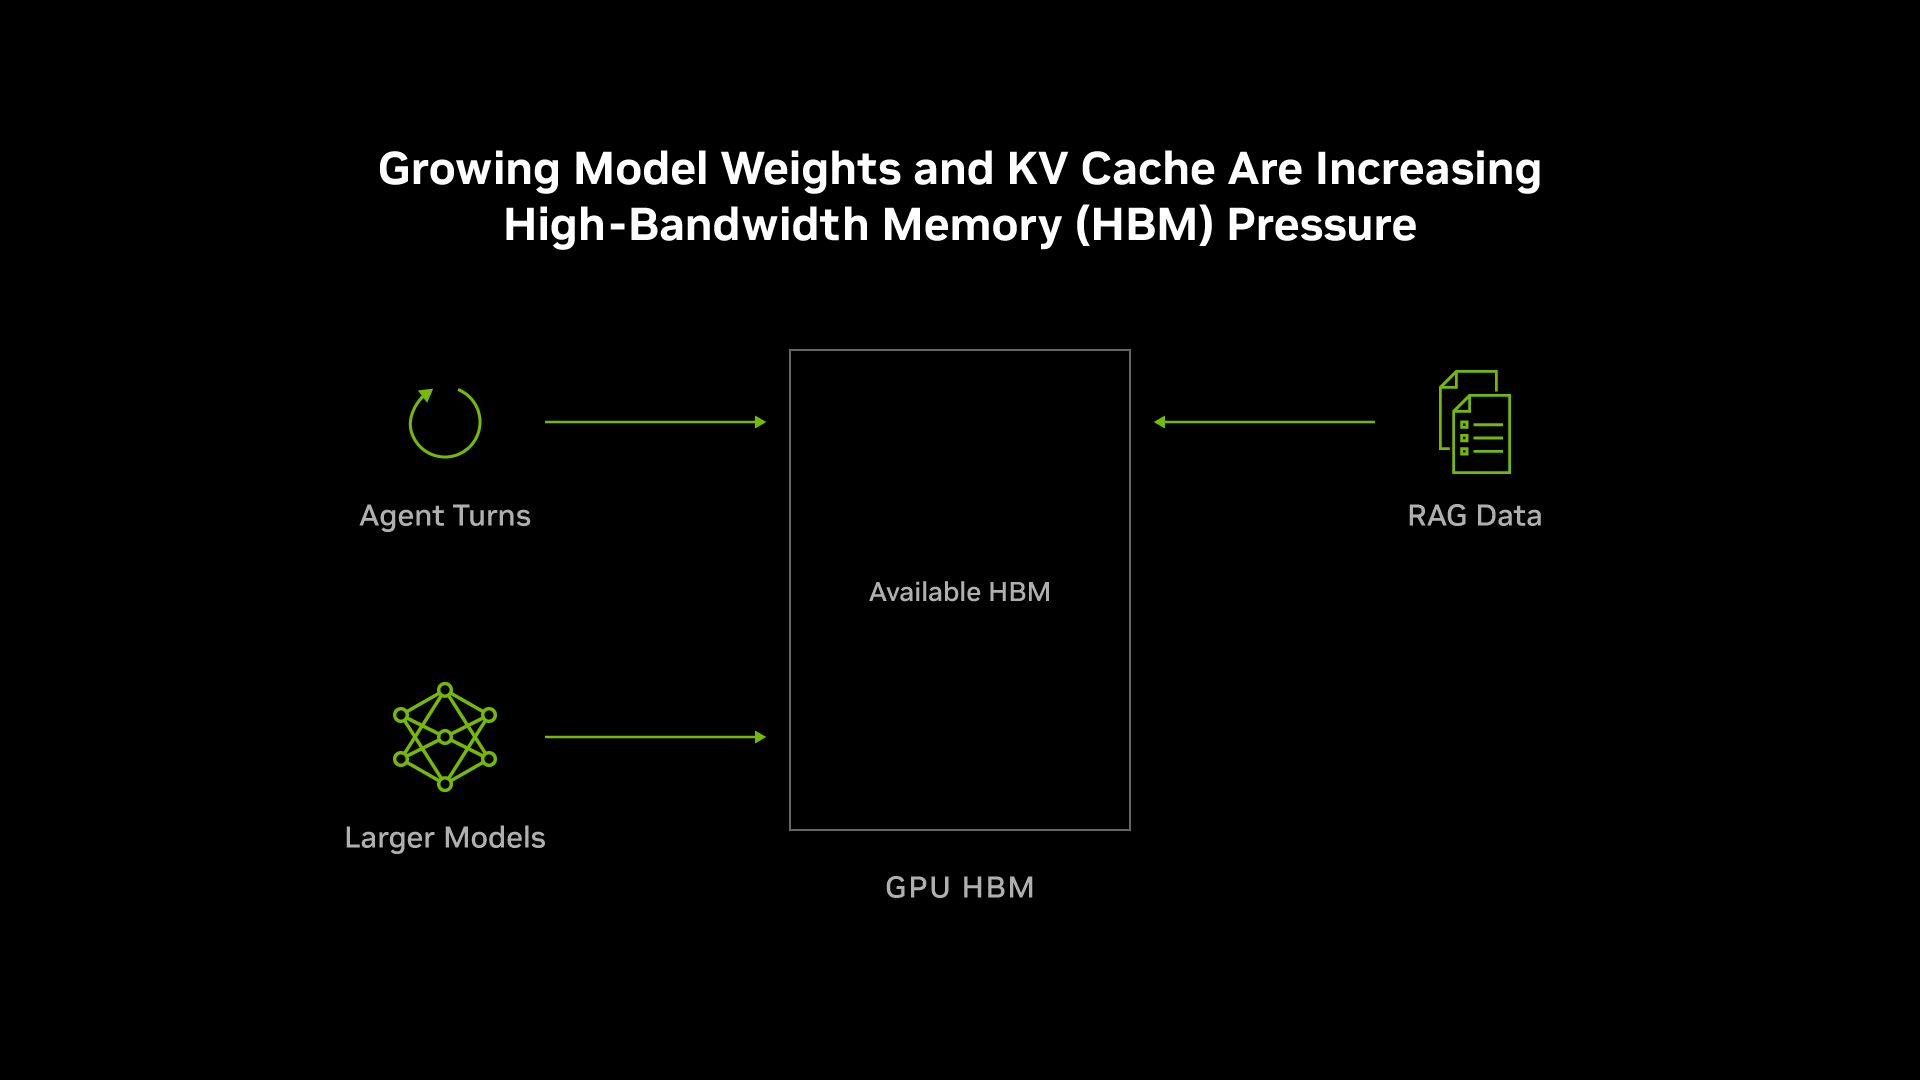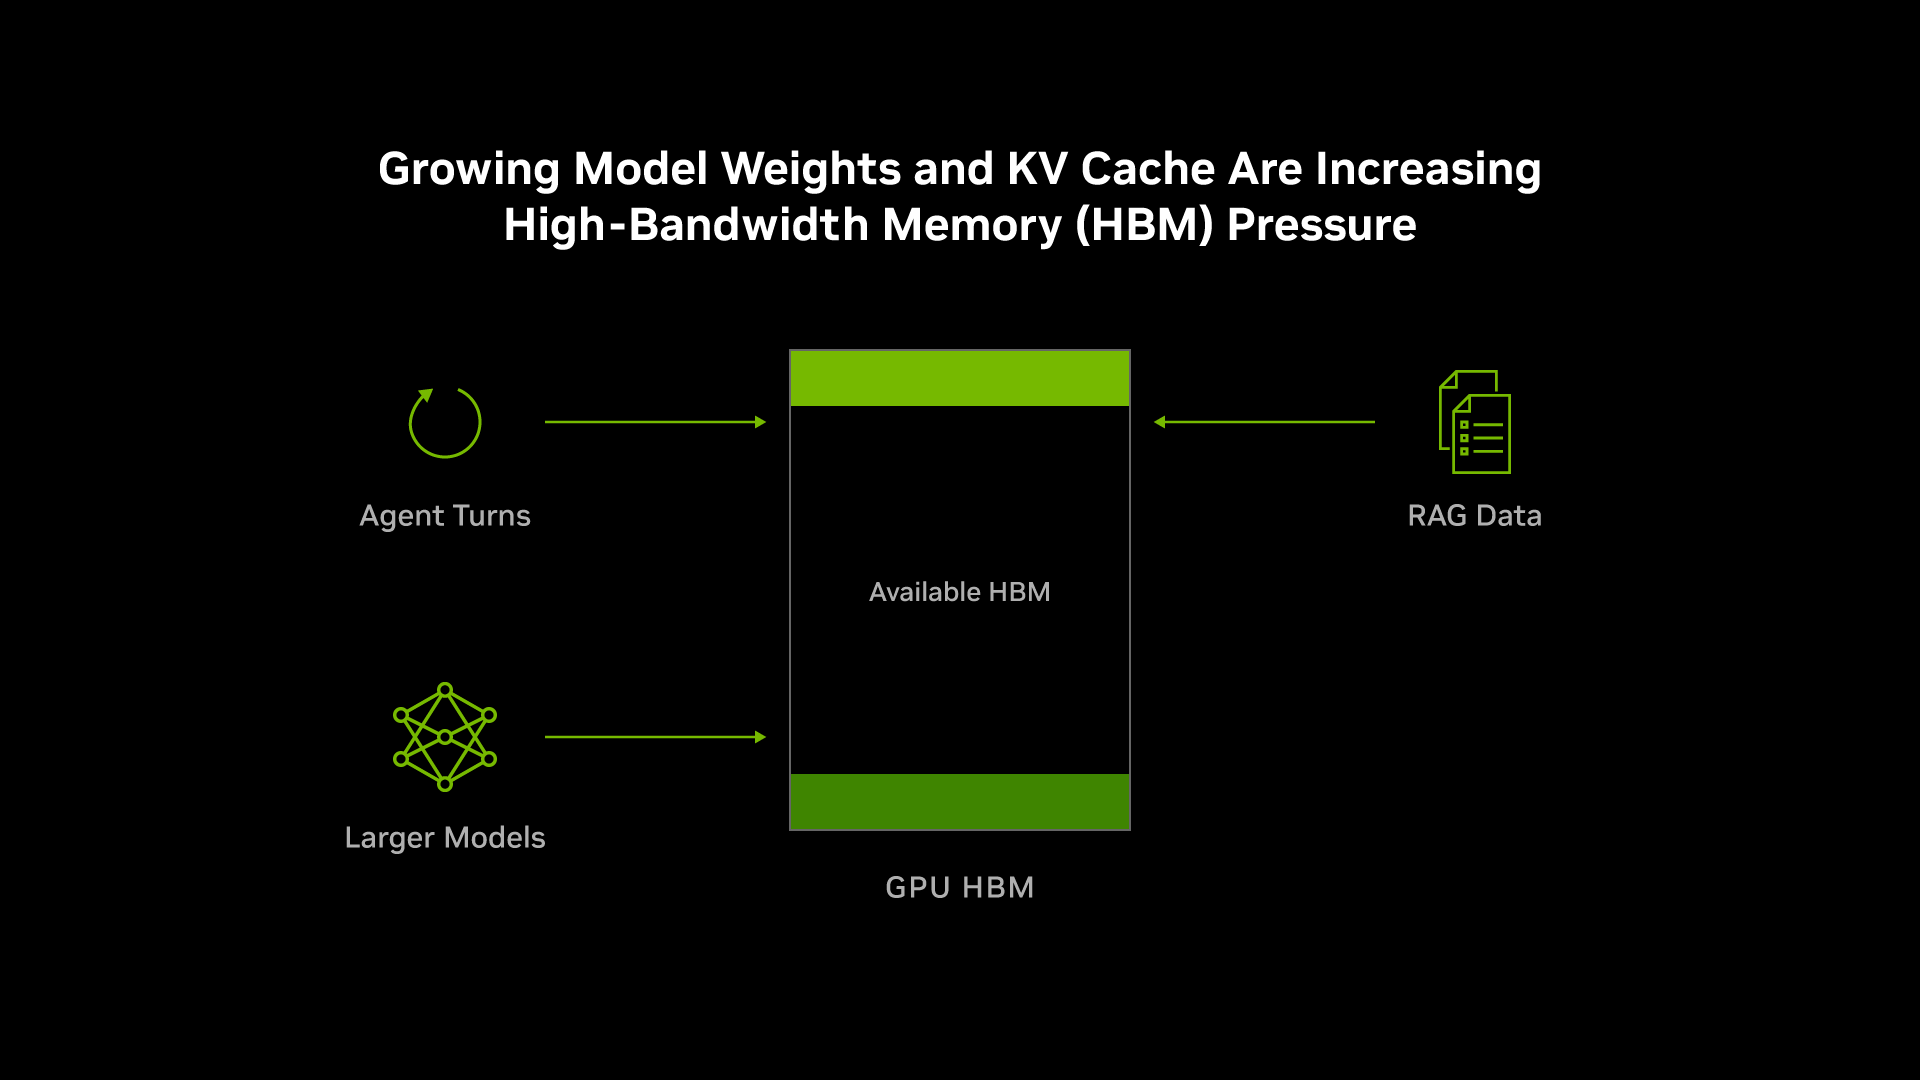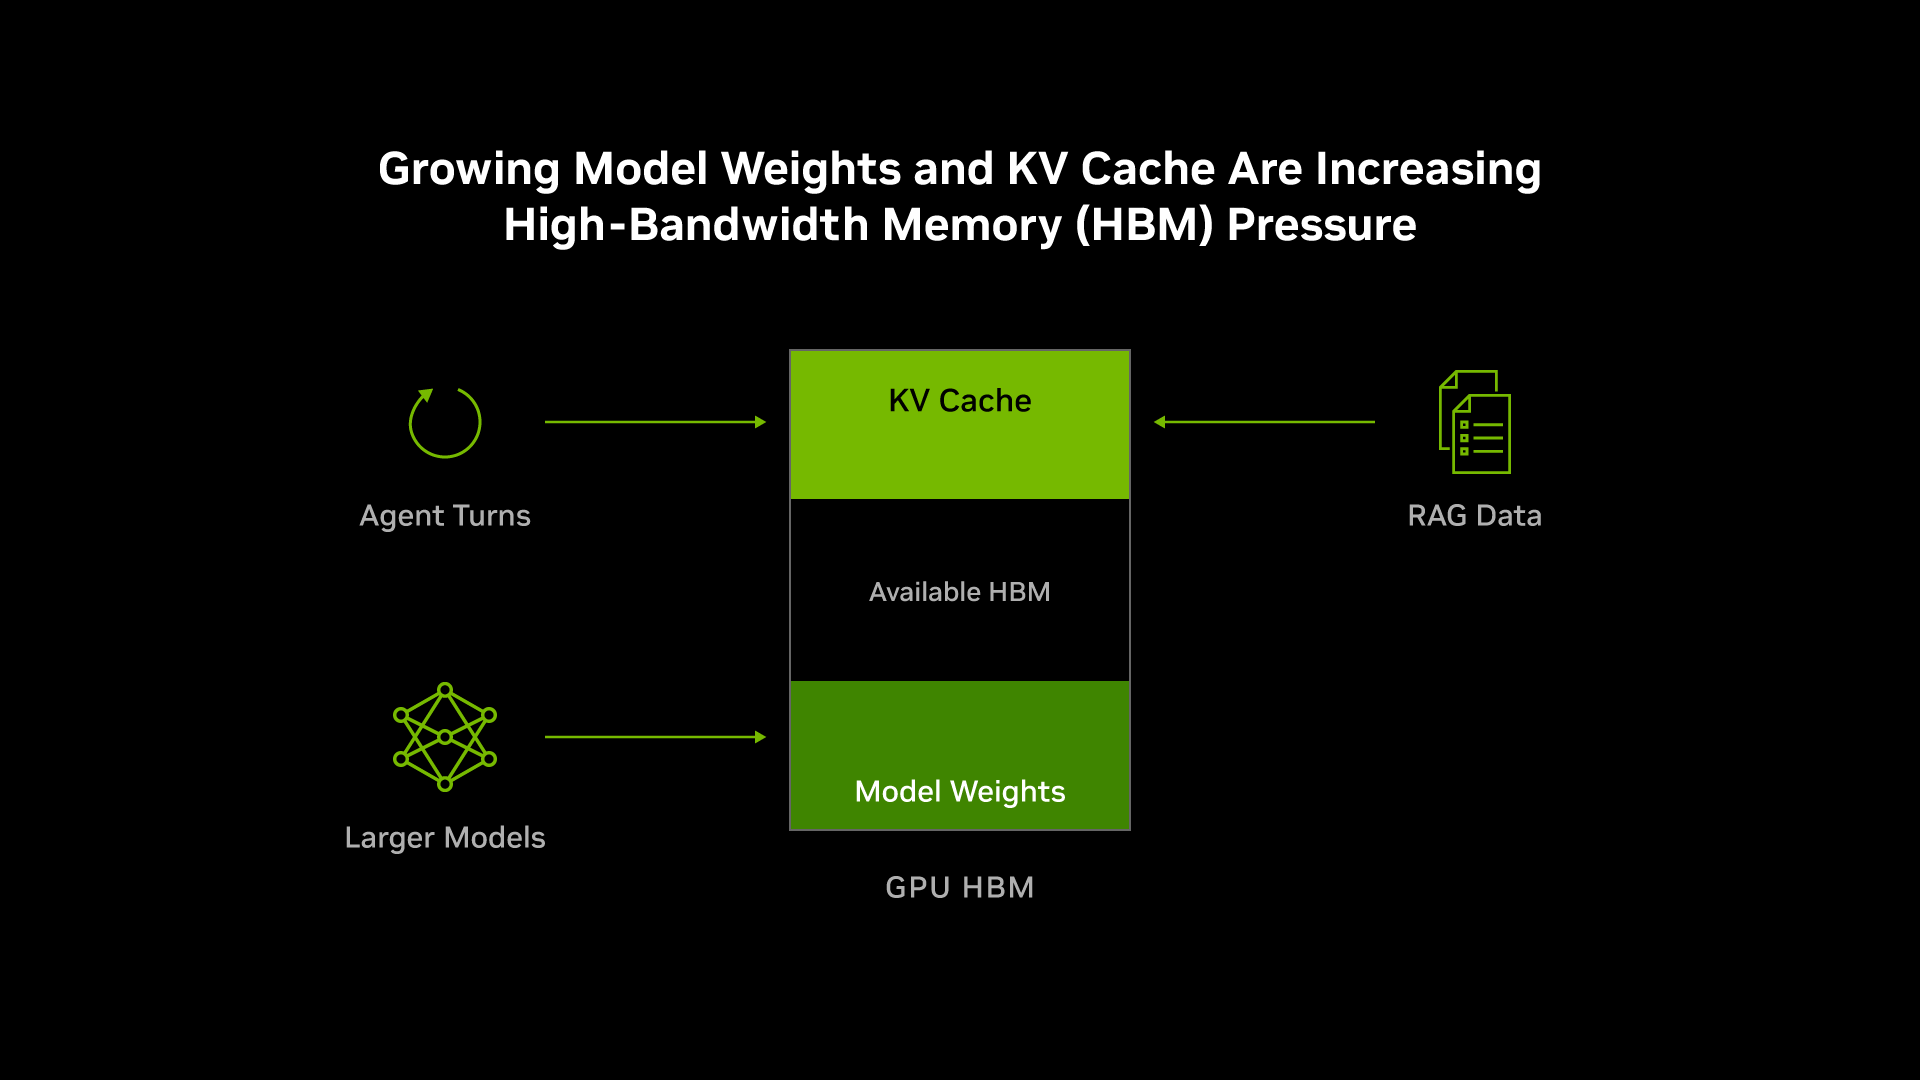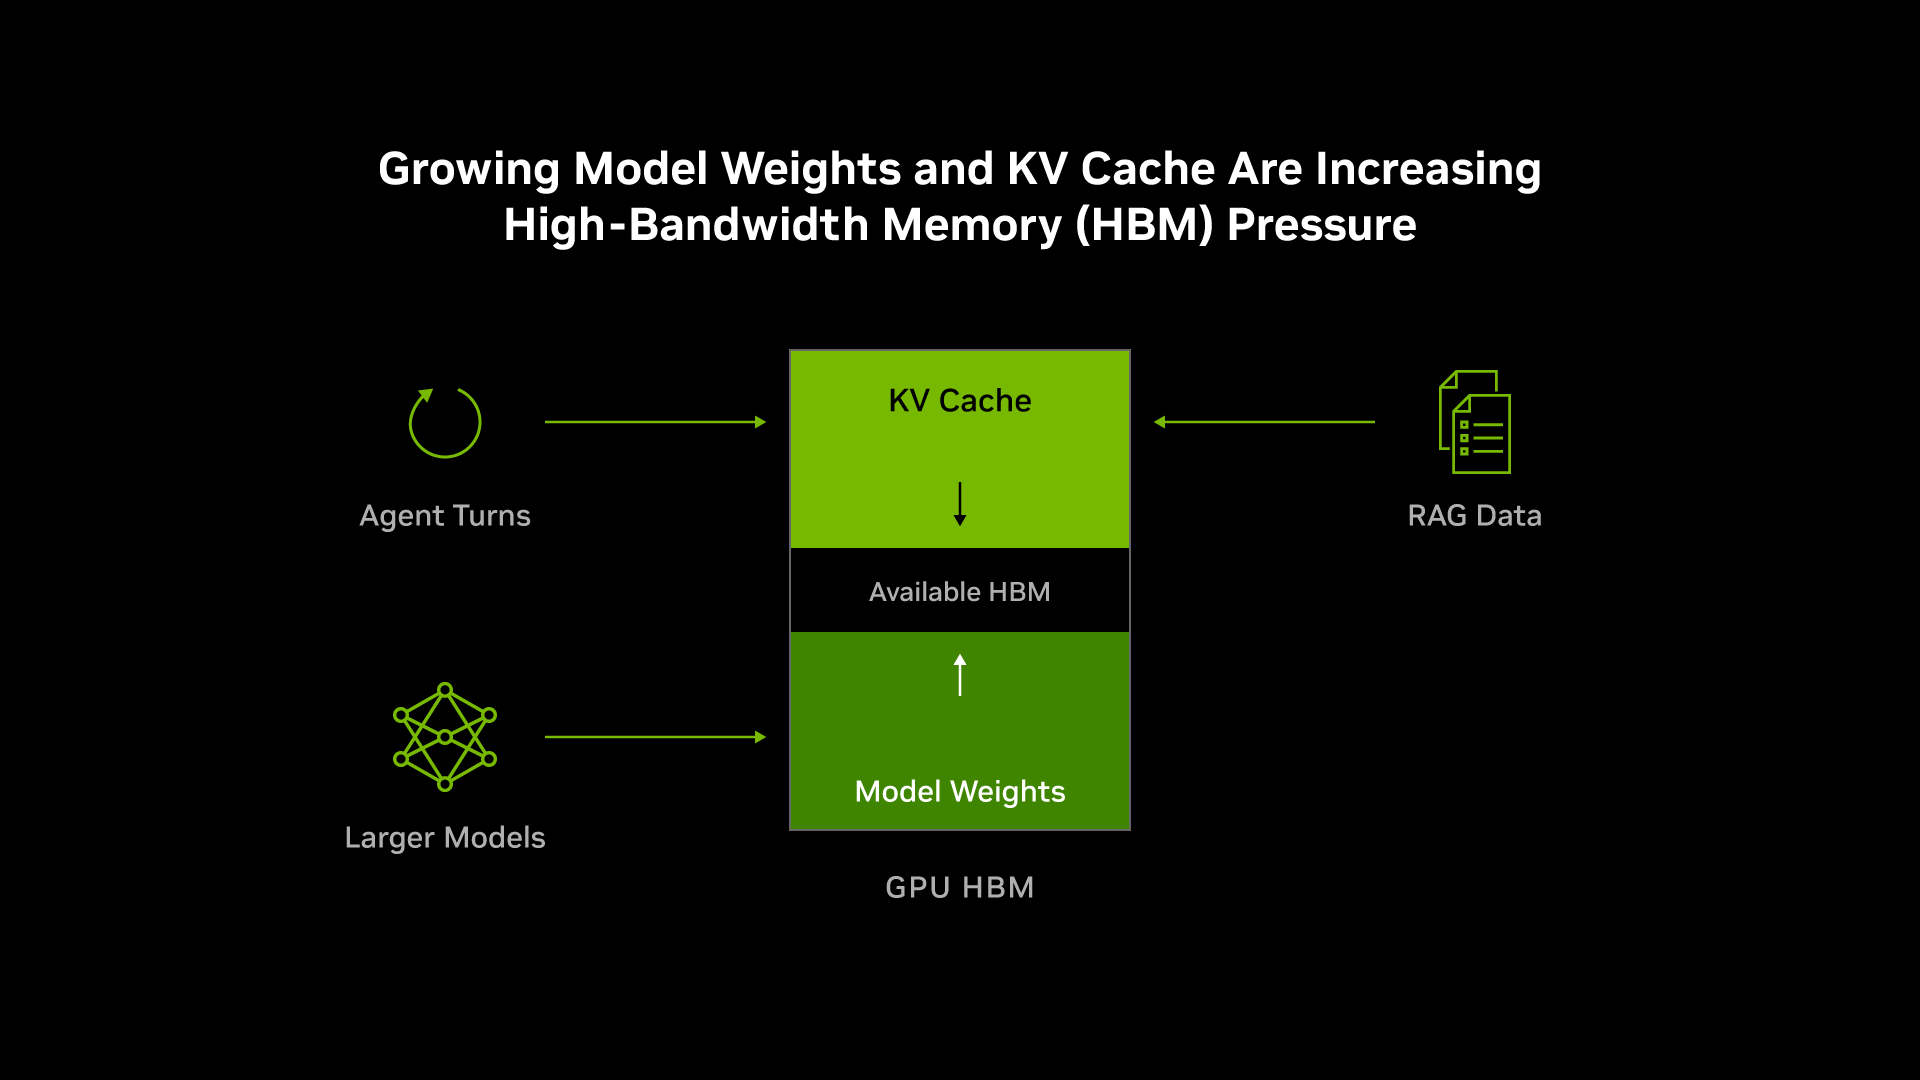
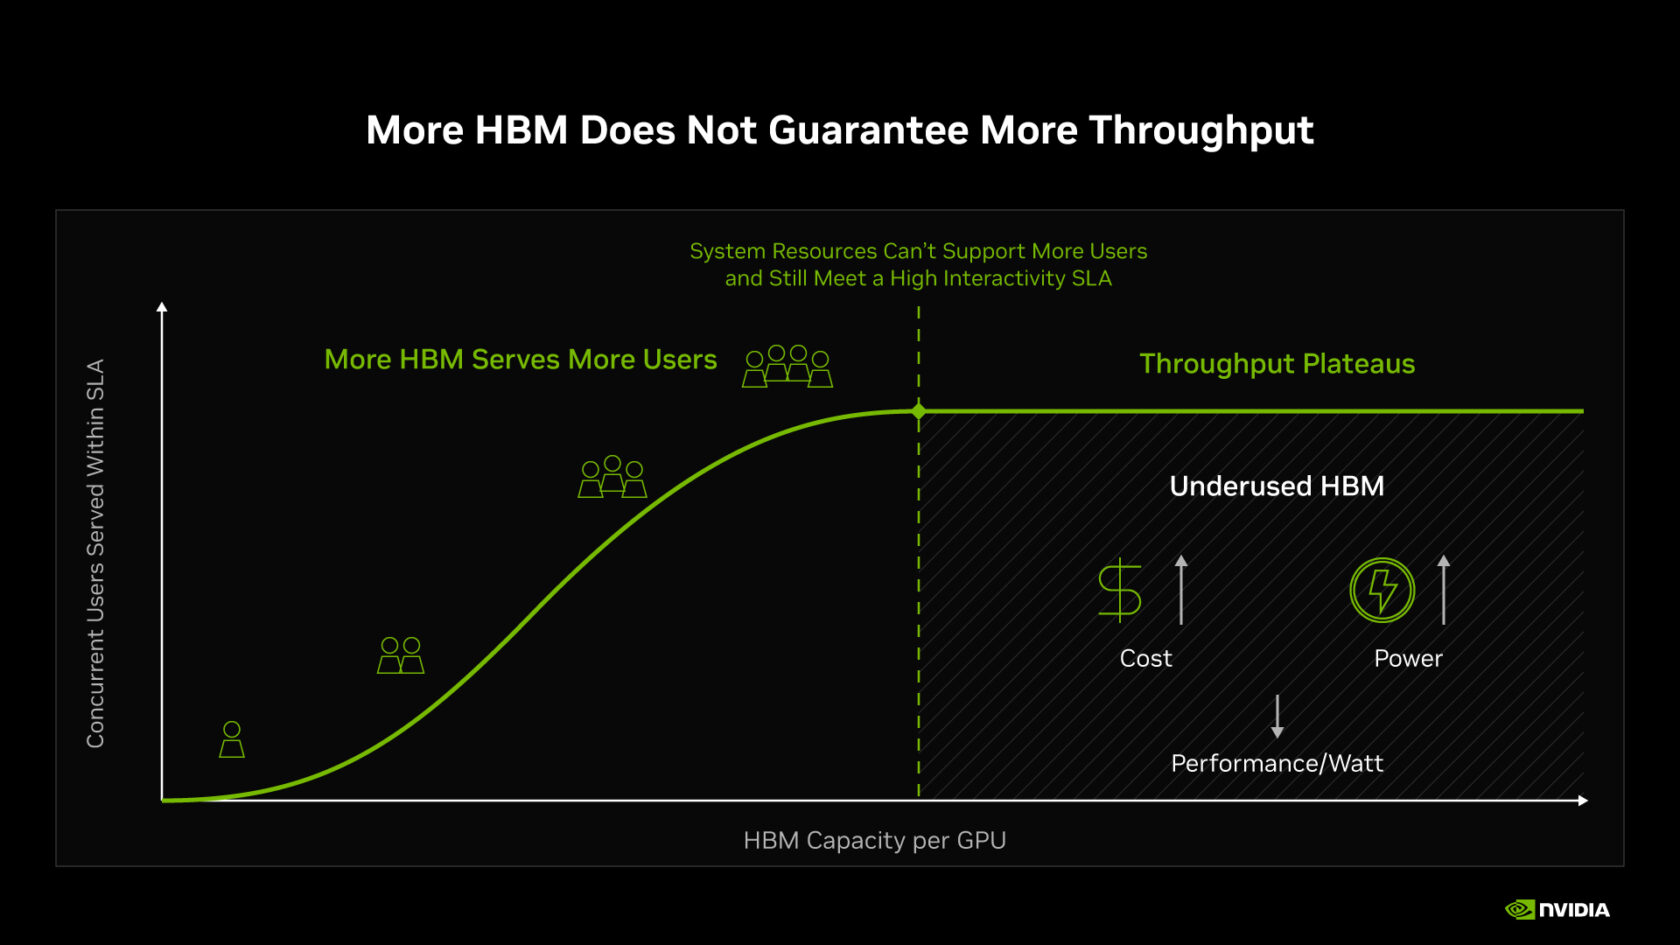
По мере усложнения моделей искусственного интеллекта — с триллионами параметров, увеличенными окнами контекста и более сложными инференс-задачами — растет потребность в памяти с высокой пропускной способностью (HBM) на GPU. NVIDIA отмечает, что этот растущий спрос сталкивается с ограниченным запасом памяти и растущими ценами, что является проблемой, ожидаемой в ближайшем будущем.
Вместо простого увеличения емкости HBM, что сталкивается с физическими и финансовыми ограничениями, NVIDIA сосредотачивается на полном совместном проектировании стека. Эта стратегия включает в себя согласованное проектирование аппаратного обеспечения GPU, CPU, сетей, систем хранения данных и программного обеспечения для максимизации эффективного использования памяти на всех уровнях внутри конвейера обработки AI — называемого AI фабрикой.
В этих AI фабриках существует иерархия памяти: самый быстрый и самый дорогой уровень — это HBM GPU, где хранятся веса модели и кэш ключ-значение (KV) активного контекста. Ниже расположена объемная, но более медленная память CPU, локальные SSD и общие хранилища — все они жертвуют скоростью ради вместимости и экономичности. Цель — уменьшить объем данных, хранящихся в самом дорогом уровне, перенести неактивные данные в более дешевые уровни и вовремя подгружать данные обратно в GPU, улучшая пропускную способность и снижая задержки.
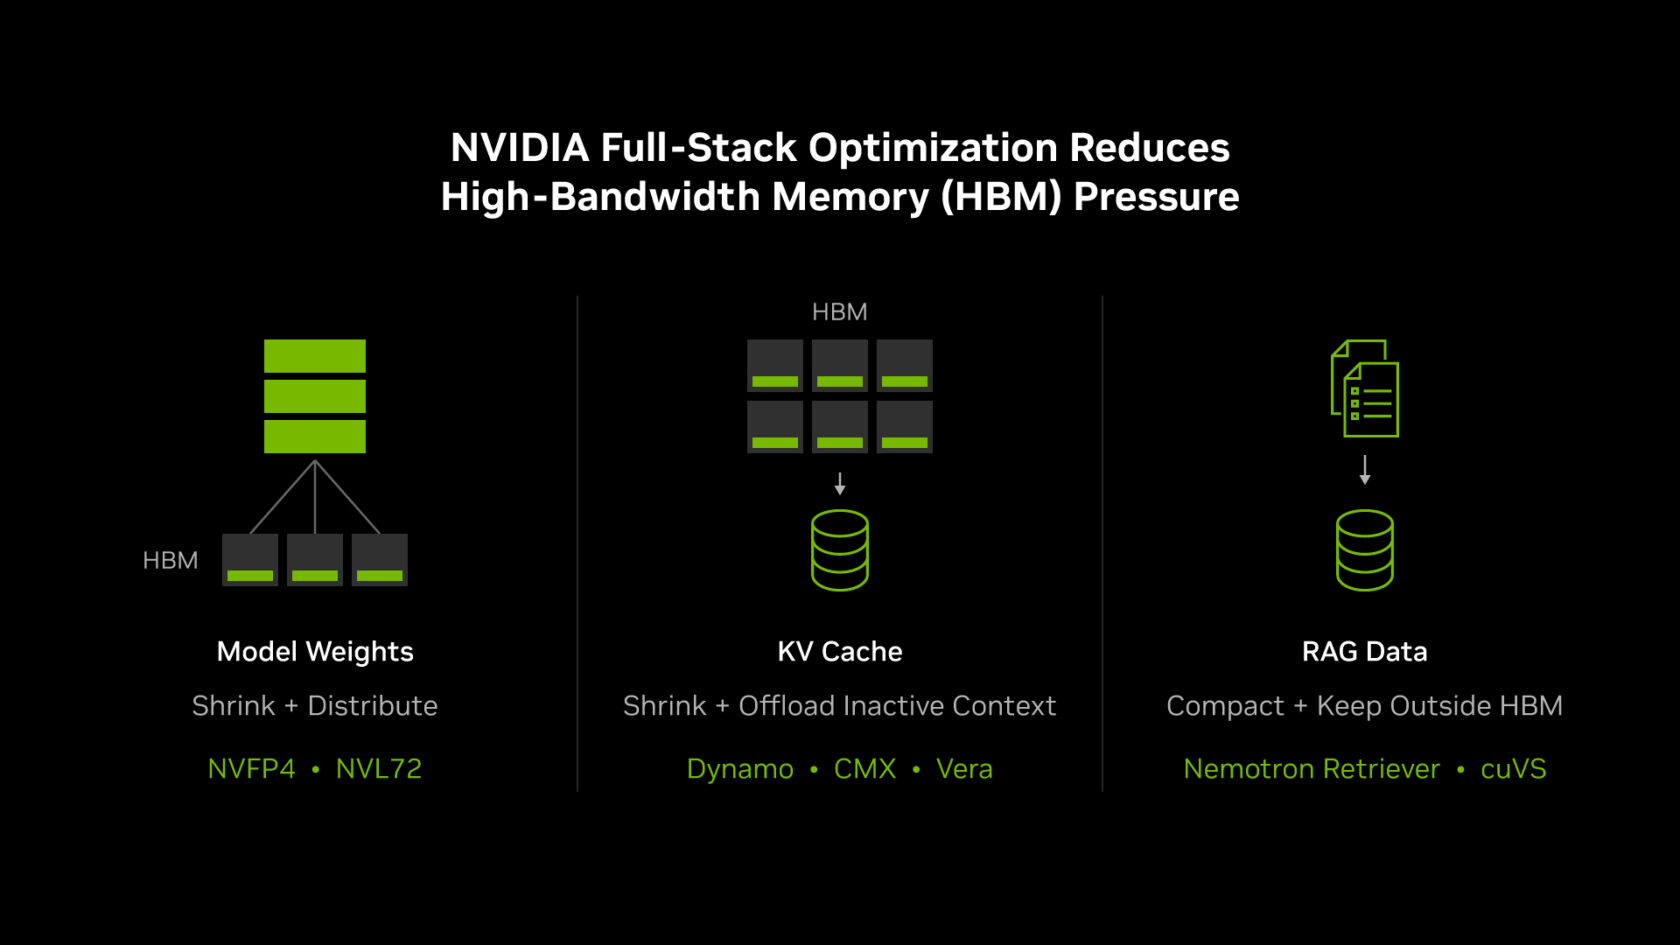
Подход NVIDIA включает несколько инноваций. Во-первых, использование 4-битного формата с плавающей точкой под названием NVFP4 помогает уменьшить объем весов модели и кэша KV, снижая потребление памяти. Распределение всей модели на до 72 GPU в системе NVL72 дополнительно освобождает HBM для кэша KV и одновременной работы пользователей.
Во-вторых, неактивный контекст кэша KV может выгружаться из дорогой HBM в объемную память, подключенную к CPU, или в общие уровни хранения с помощью нового программного обеспечения NVIDIA Dynamo для инференса и решений CMX для контекстной памяти. Это ПО управляет кэшем KV между памятью GPU, CPU и хранилищем, позволяя быстро повторно использовать данные без необходимости постоянно держать все данные в HBM.
В-третьих, методы генерации с дополнением извлечением (retrieval-augmented generation, RAG) уменьшают нагрузку на HBM, храня крупные корпоративные базы знаний вне GPU. Вместо этого Nemotron Retriever от NVIDIA создает компактные векторные эмбеддинги, а библиотека cuVS управляет индексом для поиска по CPU и слоям хранения. В GPU попадают только релевантные фрагменты.
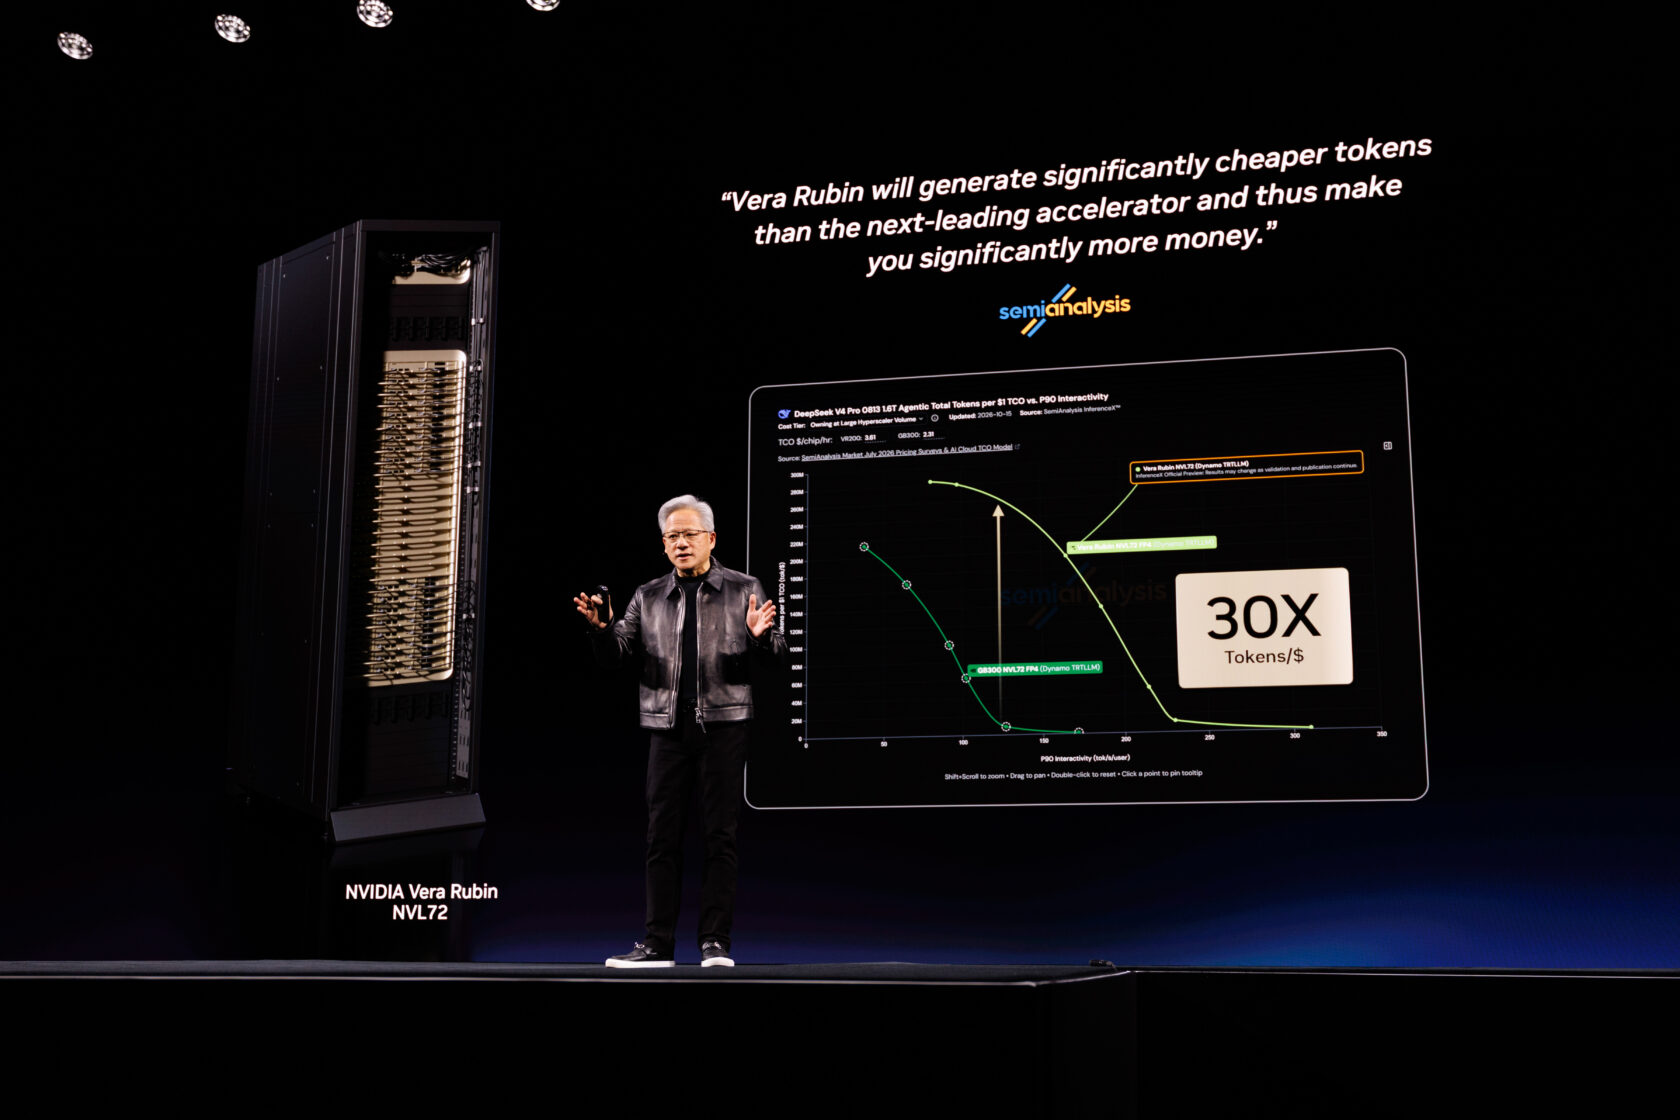
NVIDIA сообщает, что эти объединенные оптимизации привели к примерно 3% увеличению емкости HBM на GPU с NVIDIA Blackwell Ultra до платформы Vera Rubin, но обеспечили до 30-кратного увеличения пропускной способности инференса на доллар в тестовых нагрузках, таких как SemiAnalysis AgentX.
Решая проблему ограничений пропускной способности памяти — так называемую «стену памяти» — полный совместный дизайн стека NVIDIA позволяет нагрузкам AI выполнять больше полезных вычислений на байт памяти, снижая энергопотребление и затраты. Эта комплексная стратегия управления памятью знаменует сдвиг от простого увеличения сырой емкости памяти к координации эффективности между аппаратными и программными слоями для удовлетворения растущих требований AI.
Для получения подробной технической информации NVIDIA предоставляет видео с объяснением и углубленным разбором того, как полный совместный дизайн стека снижает нагрузку на память при инференсе и улучшает экономику AI-платформ.
Источники и первоисточники
Read the original source ↗
Комментарии (0)
Комментариев пока нет. Начните обсуждение.
Написать комментарий
Комментарии публикуются после модерации. Ваше имя и комментарий будут видны всем. Аккаунт