
NVIDIA Verbessert die AI-Speichereffizienz durch einen Full-Stack-Codesign-Ansatz
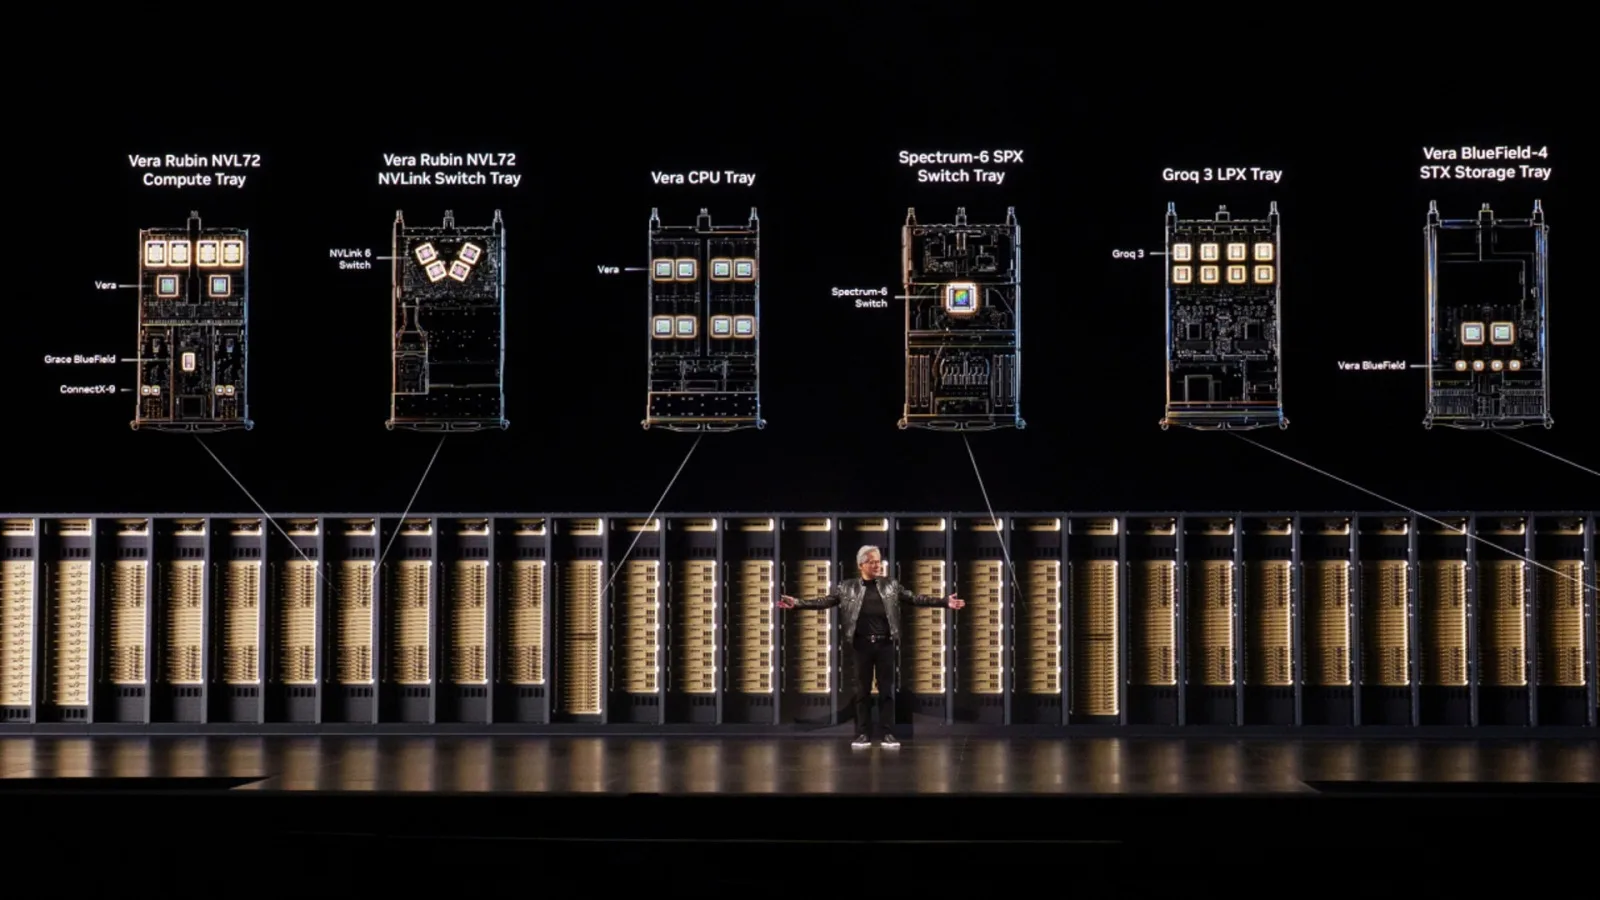
Image: NVIDIA · Source
NVIDIA begegnet dem steigenden GPU-Speicherbedarf in der KI durch Full-Stack-Codesign und optimiert die Speichernutzung über Hardware und Software hinweg, um Durchsatz und Effizienz trotz begrenzter Hochgeschwindigkeits-Speicherkapazität zu steigern.
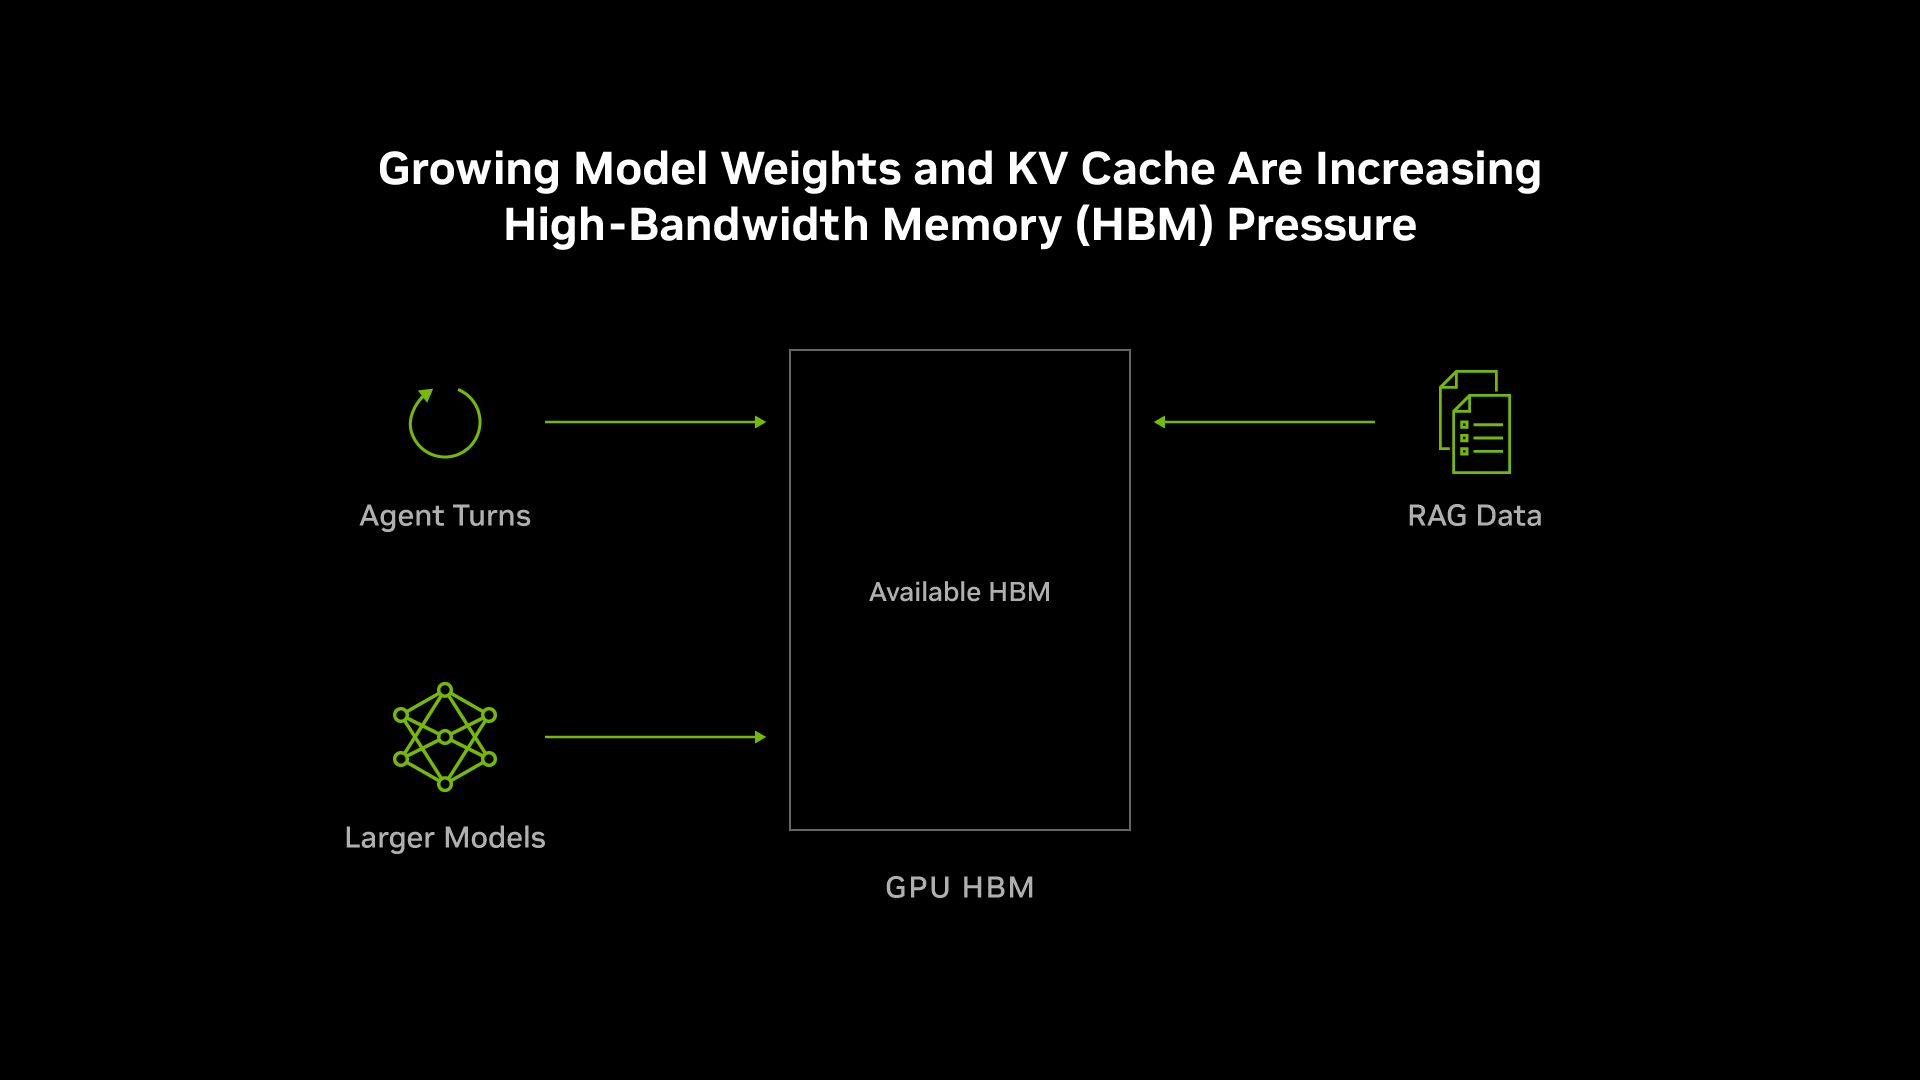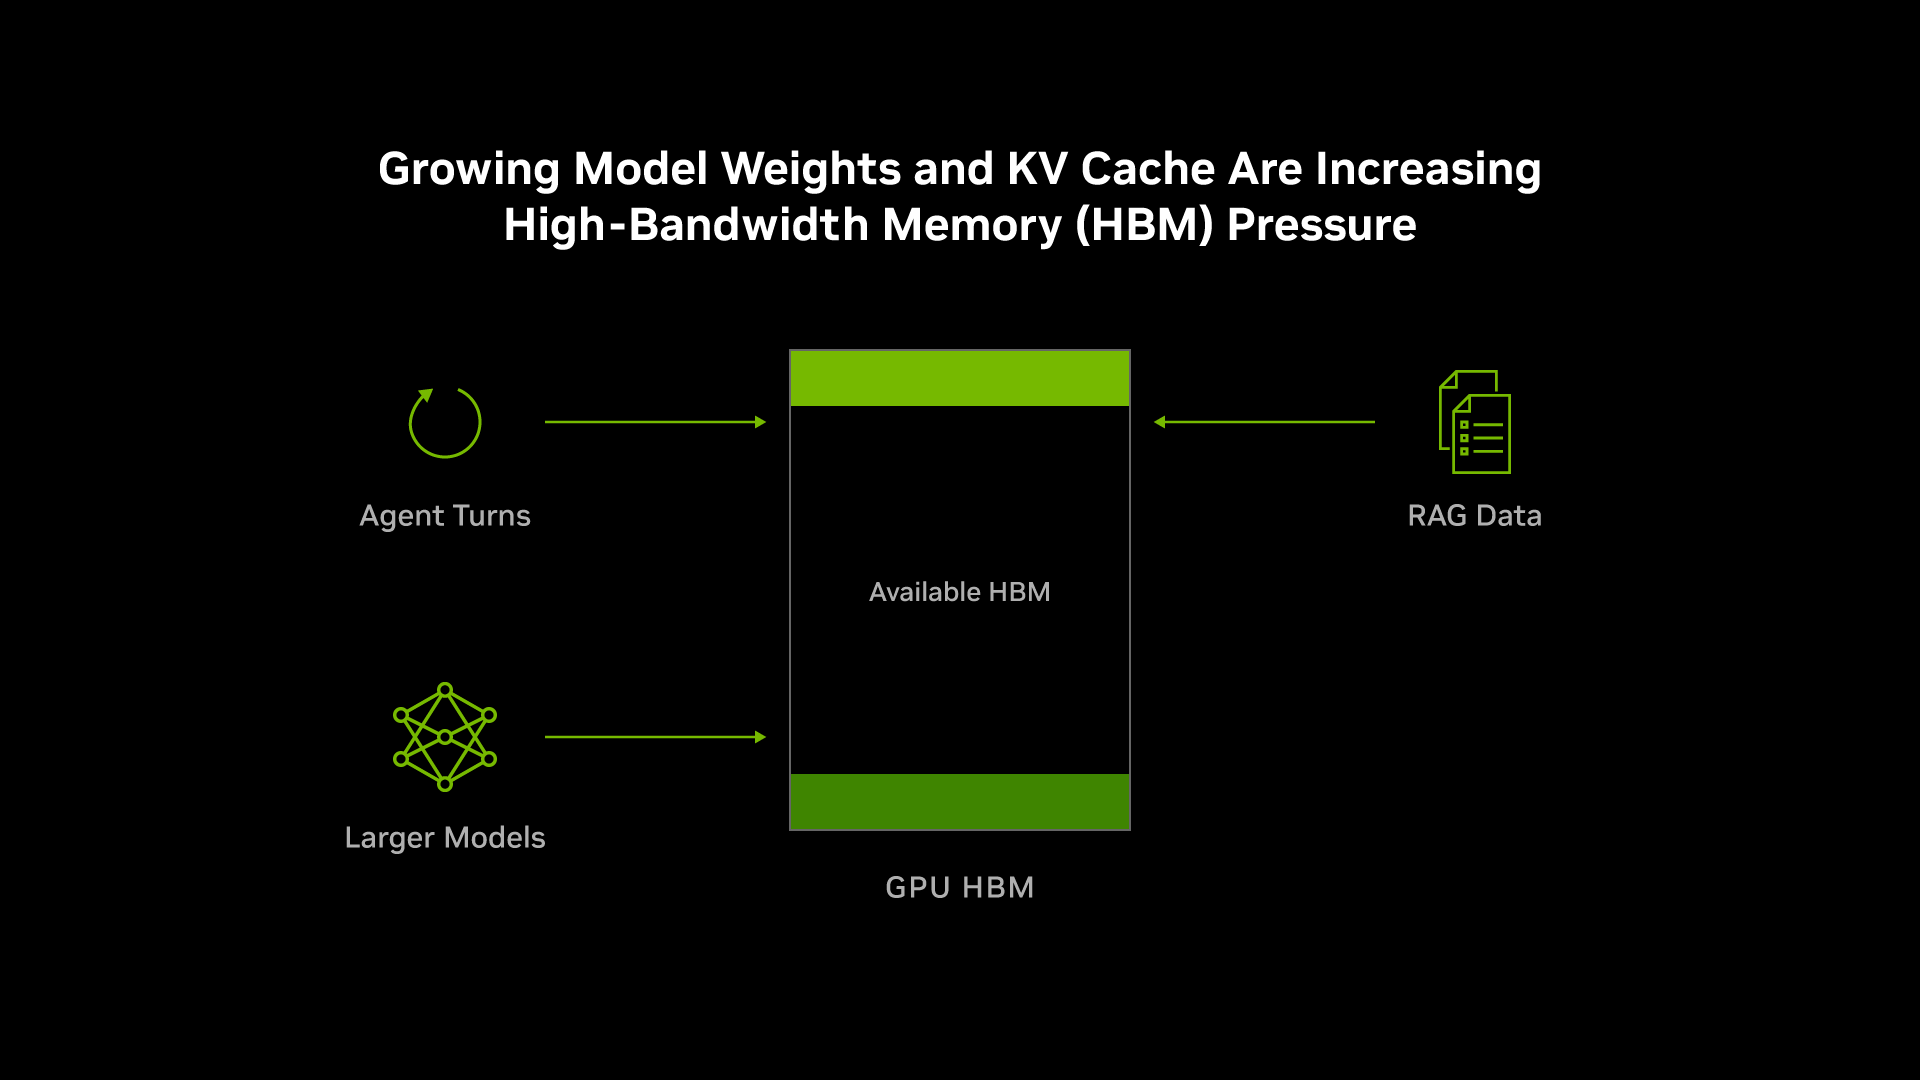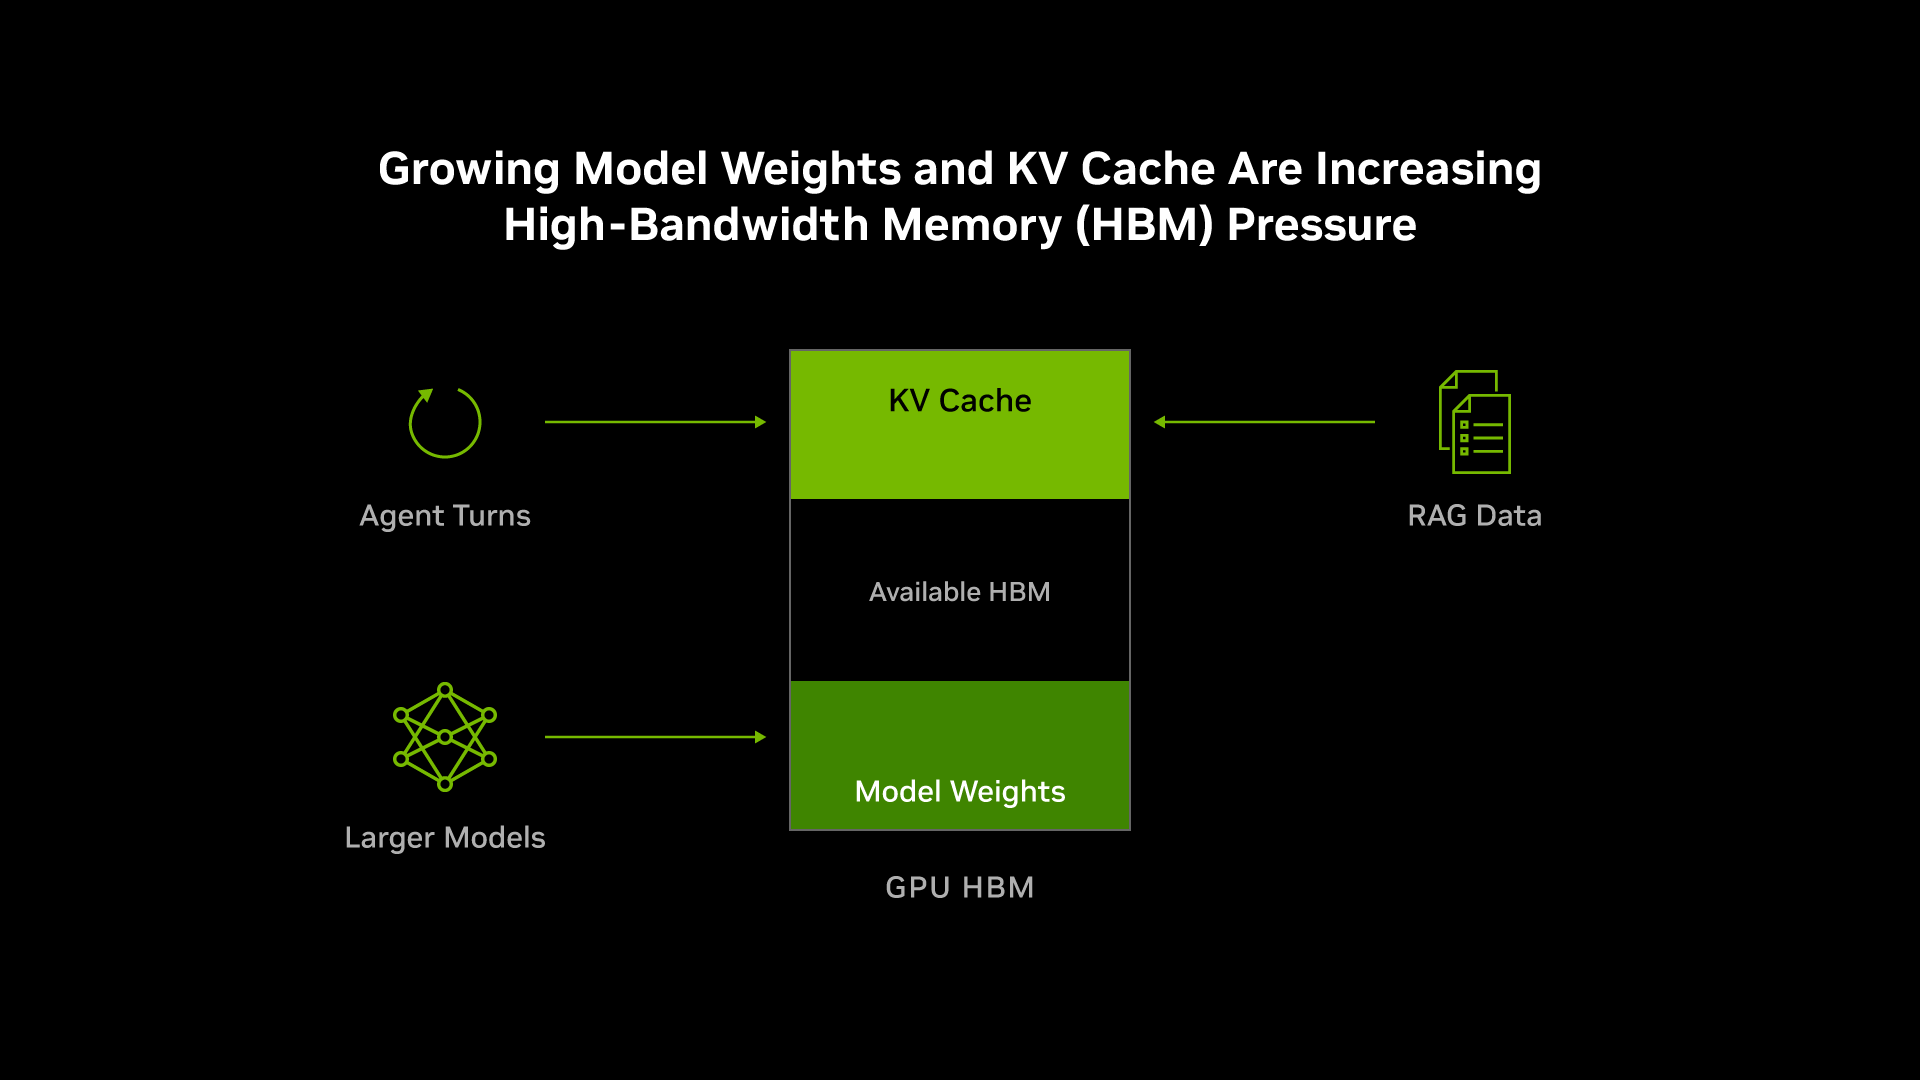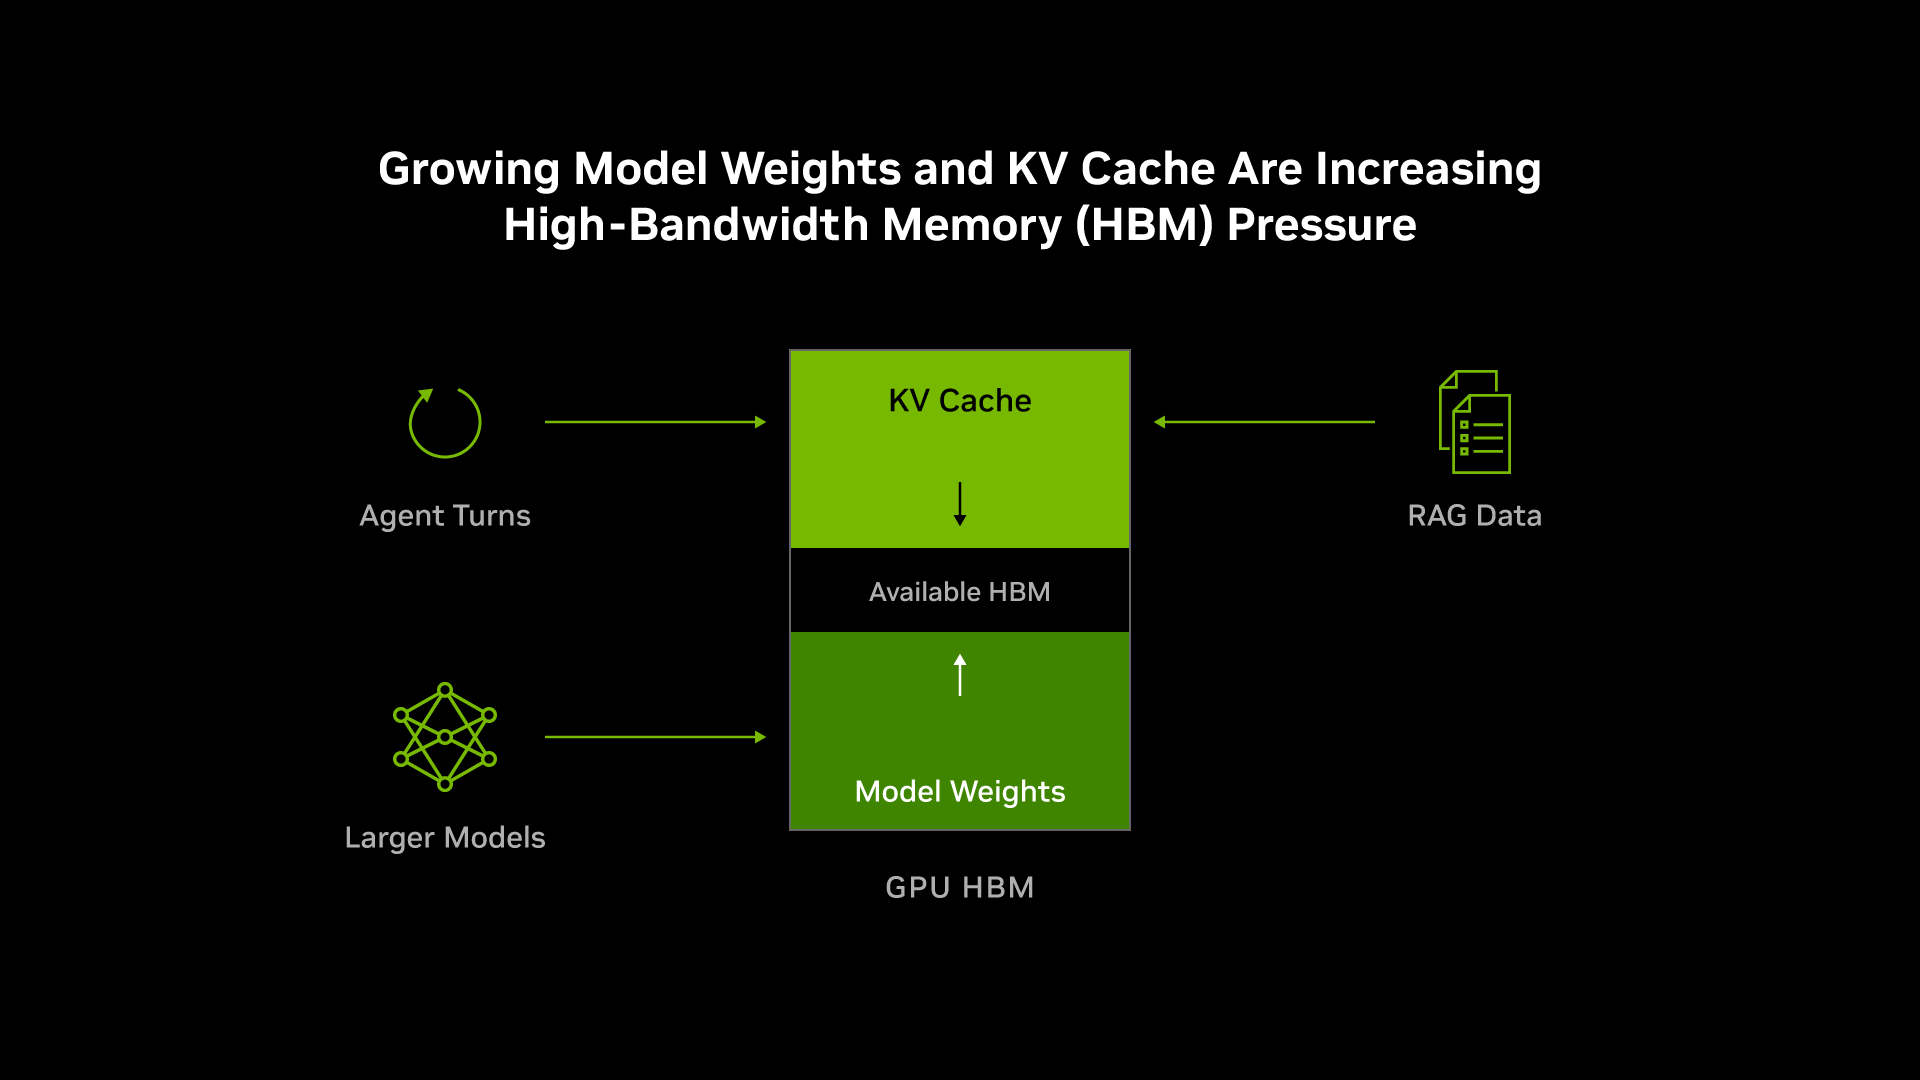
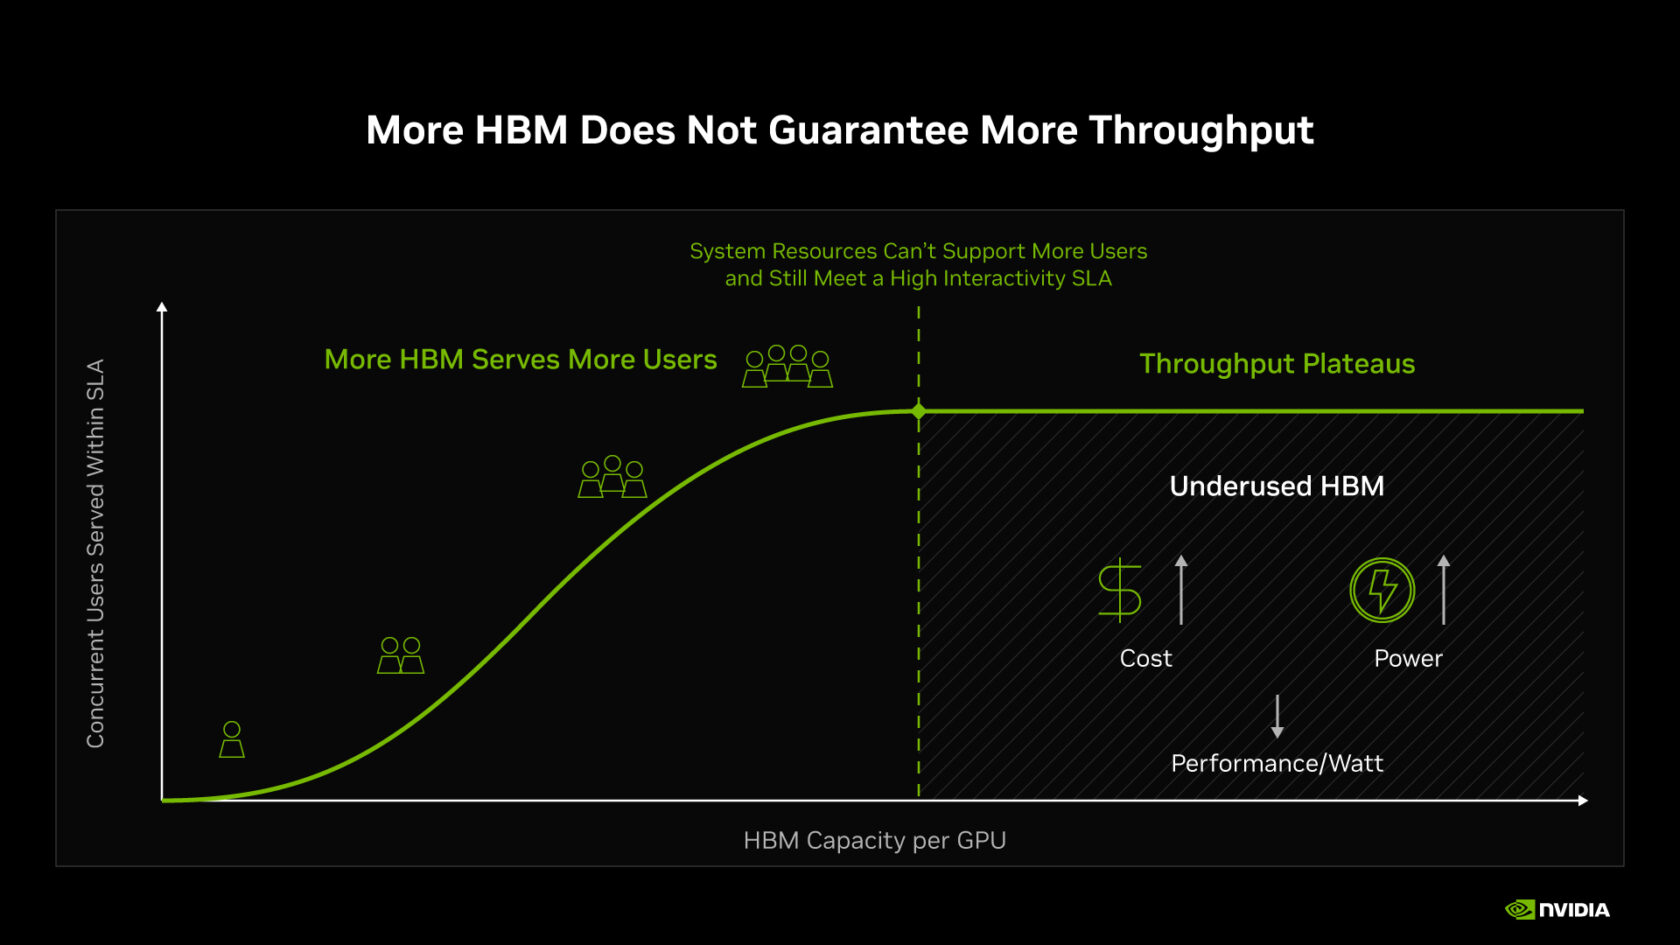
Während KI-Modelle immer komplexer werden — mit Billionen von Parametern, längeren Kontextfenstern und mehr agentischer Inferenz — steigt die Nachfrage nach Hochbandbreitenspeicher (HBM) auf GPUs deutlich. NVIDIA hebt hervor, dass dieser wachsende Druck auf begrenzte Speicherressourcen und steigende Preise trifft, eine Herausforderung, die kurzfristig andauern wird.
Anstatt lediglich die HBM-Kapazität zu erhöhen, was durch physische und Kostenbeschränkungen begrenzt ist, setzt NVIDIA auf Full-Stack-Codesign. Diese Strategie umfasst die gemeinschaftliche Entwicklung von GPU-Hardware, CPUs, Netzwerken, Speichersystemen und Software, um die effektive Speichernutzung auf allen Ebenen der KI-Verarbeitungspipeline — genannt die KI-Fabrik — zu maximieren.
In diesen KI-Fabriken existiert eine Speicherhierarchie: Die schnellste und teuerste Ebene ist GPU-HBM, die Modellgewichte und Key-Value-(KV-)Cache mit aktivem Kontext speichert. Darunter befinden sich große, aber langsamere CPU-Speicher, lokale SSDs und gemeinschaftlicher Speicher — alle tauschen Geschwindigkeit gegen Kapazität und Kosteneffizienz ein. Ziel ist es, das Datenvolumen in der teuersten Schicht zu reduzieren, inaktive Daten auf günstigere Ebenen zu verlagern und Daten rechtzeitig zurück zu GPUs vorzuziehen, um Durchsatz zu verbessern und Latenzen zu senken.
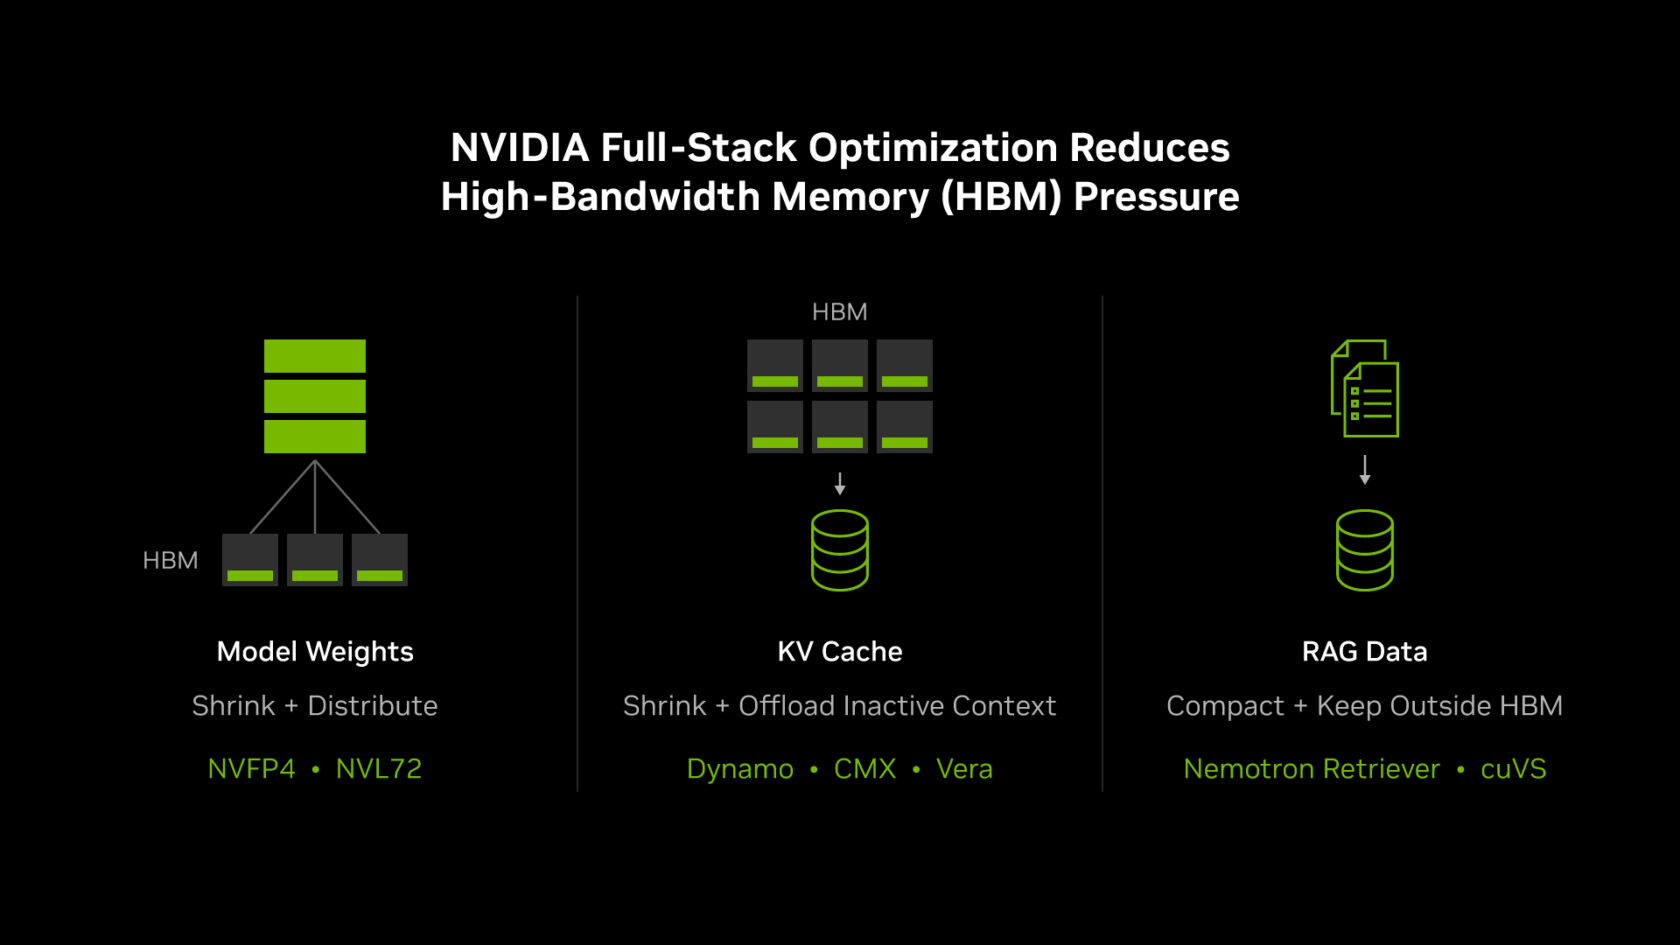
NVIDIAs Ansatz beinhaltet mehrere Innovationen. Zunächst die Verwendung eines 4-Bit-Gleitkommaformats namens NVFP4, das Modellgewichte und KV-Caches verkleinert und somit den Speicherbedarf verringert. Die Verteilung des gesamten Modells auf bis zu 72 GPUs im NVL72-System schafft zusätzlichen HBM-Platz für KV-Cache und Benutzerkonkurrenz.
Zweitens können inaktive KV-Cache-Kontexte von teurem HBM auf großen CPU-verbundenen Speicher oder gemeinschaftliche Speicherebenen ausgelagert werden, mithilfe der neuen NVIDIA Dynamo-Inferenzsoftware und CMX-Kontextspeicherlösungen. Diese Software verwaltet KV-Cache über GPU-Speicher, CPU-Speicher und Speicher, um schnelles Wiederverwenden zu ermöglichen, ohne alle Daten ständig im HBM zu halten.
Drittens reduzieren retrieval-augmented generation (RAG)-Techniken die HBM-Last, indem große unternehmensweite Wissensdatenbanken außerhalb der GPU gehalten werden. Stattdessen erzeugt NVIDIAs Nemotron Retriever kompakte Vektor-Einbettungen, und die cuVS-Bibliothek verwaltet den durchsuchbaren Index über CPUs und Speicherebenen. Nur relevante Passagen gelangen in den Hochgeschwindigkeit-GPU-Kontext.
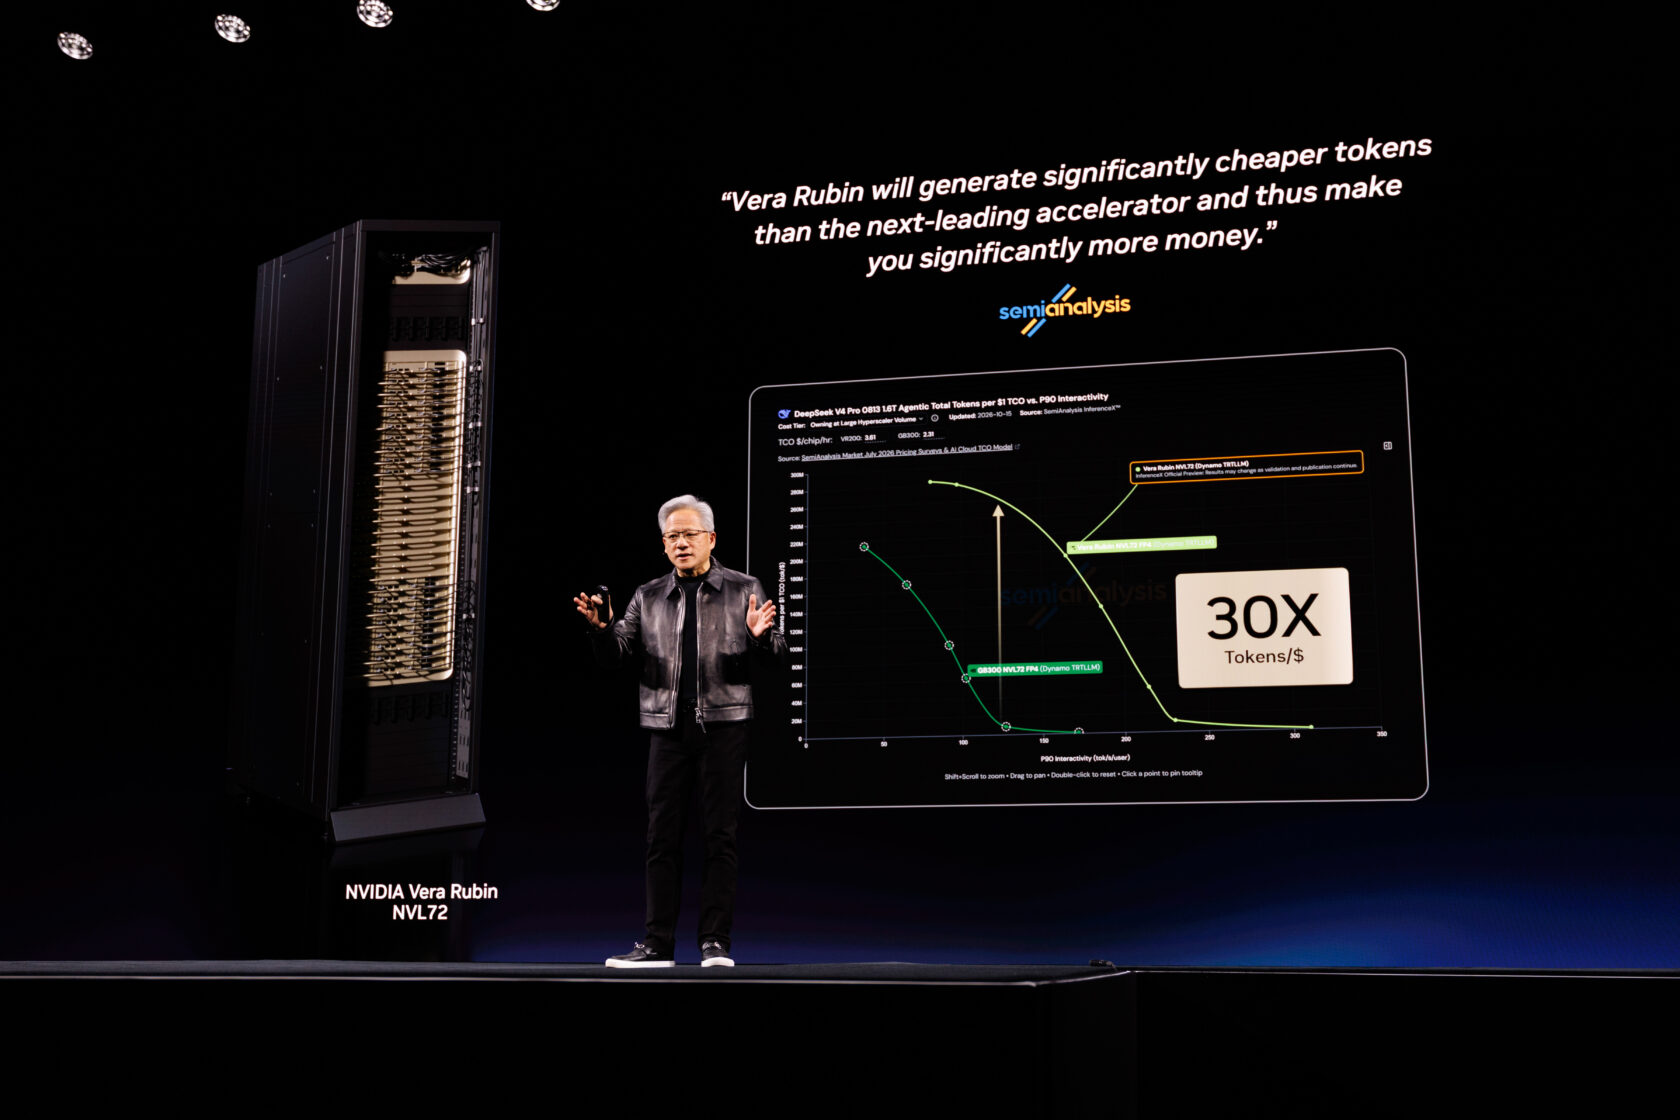
NVIDIA berichtet, dass diese kombinierten Optimierungen zu einem etwa 3 % höheren HBM-Kapazität pro GPU geführt haben – von NVIDIA Blackwell Ultra über die Vera Rubin-Plattform – aber zu bis zu 30-fach höherem agentischem Durchsatz pro Dollar bei Test-Workloads wie SemiAnalysis AgentX.
Indem NVIDIA die Speicherbandbreitenbeschränkungen – die sogenannte Speicherwand – adressiert, ermöglicht das Full-Stack-Codesign KI-Workloads, mehr nützliche Berechnungen pro Byte Speicher durchzuführen, was Stromverbrauch und Kosten senkt. Diese ganzheitliche Speichermanagementstrategie markiert einen Wandel von der reinen Kapazitätssteigerung hin zu einer orchestrierten Effizienz über Hardware- und Softwareebenen für die wachsenden Anforderungen der KI.
Für detaillierte technische Einblicke stellt NVIDIA ein erklärendes Video und eine ausführliche Analyse bereit, wie Full-Stack-Codesign die Speicherbelastung bei Inferenz reduziert und die Wirtschaftlichkeit von KI-Plattformen verbessert.
Quellen und Originalberichte
Read the original source ↗
Kommentare (0)
Noch keine Kommentare.
Kommentar schreiben
Kommentare erscheinen nach Moderation. Name und Kommentar werden öffentlich angezeigt. Konto