
NVIDIA forbedrer AI-minneeffektiviteten med helhetlig kodeutforming
Bilde: NVIDIA · Kilde
NVIDIA møter den økende etterspørselen etter GPU-minne i AI ved helhetlig kodeutforming som optimaliserer minnebruk på tvers av maskinvare og programvare for å øke gjennomstrømning og effektivitet til tross for begrenset kapasitet for høyhastighetsminne.
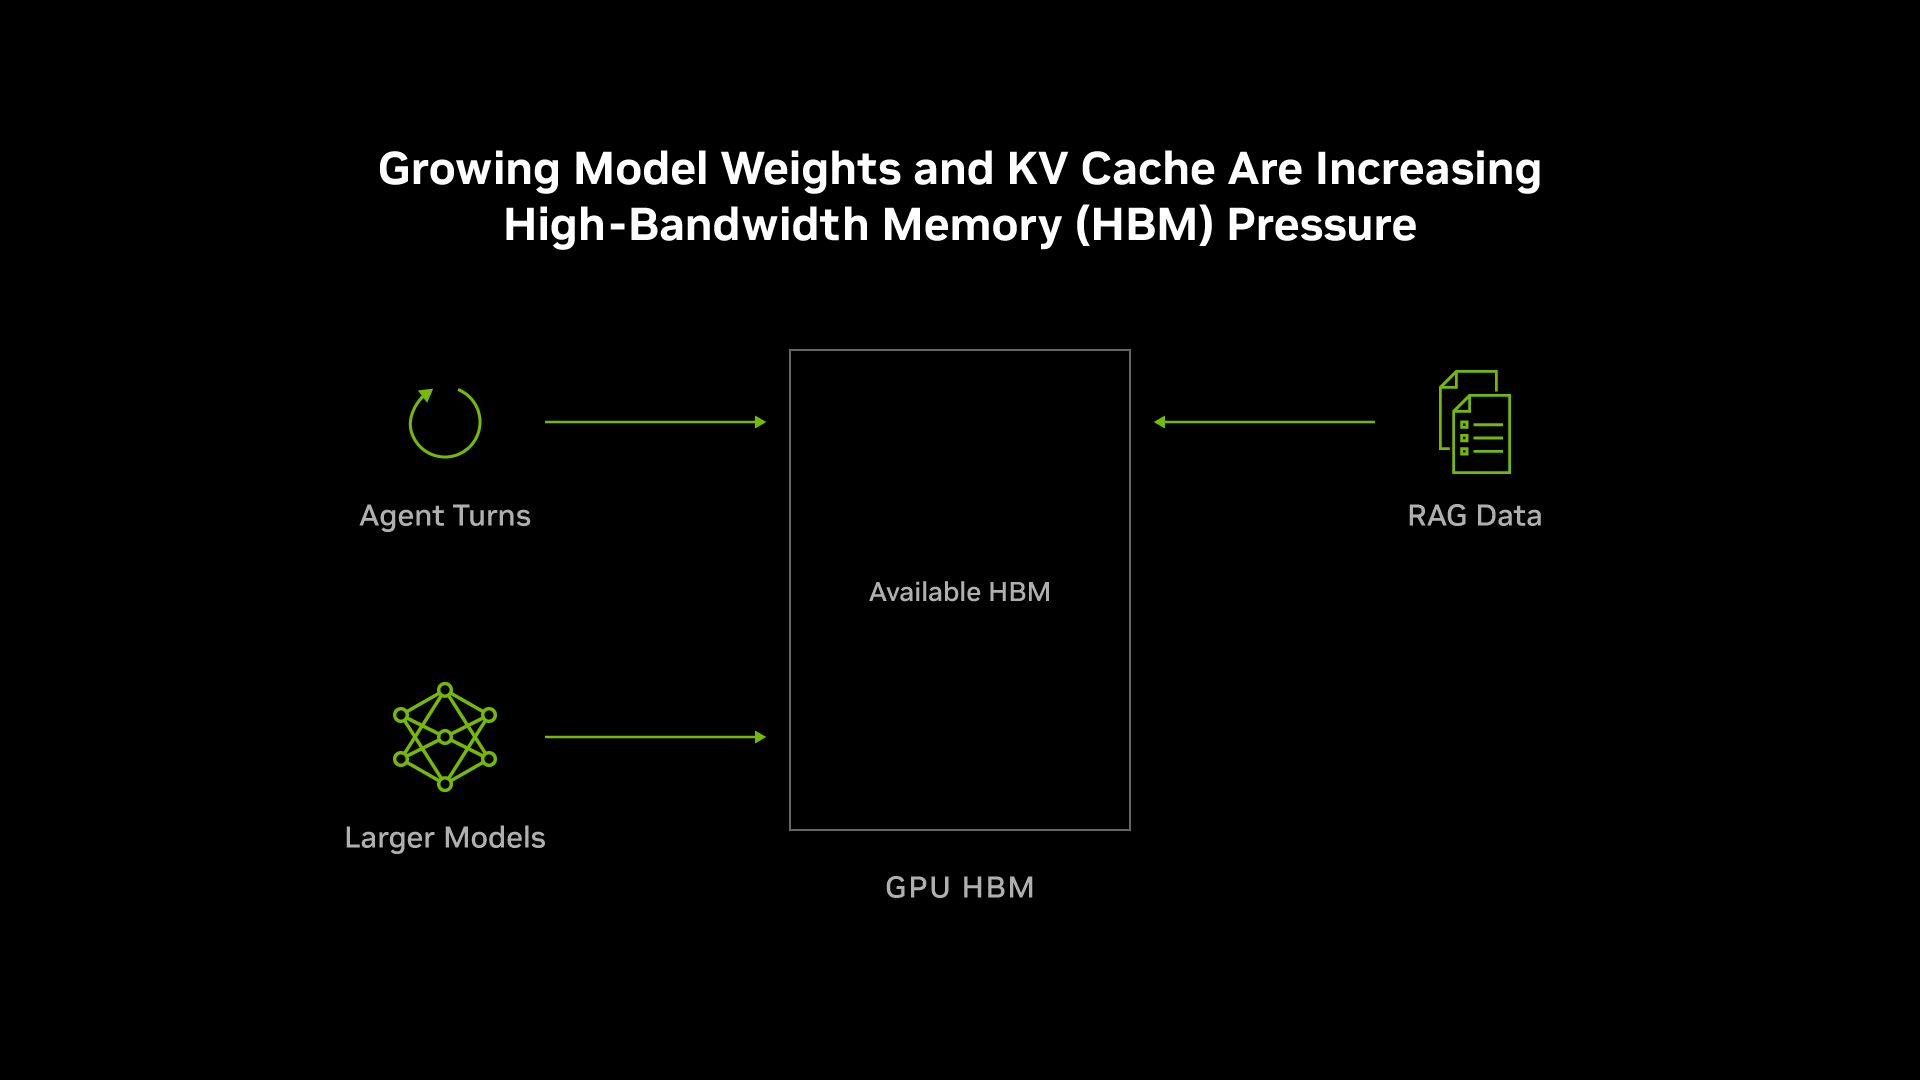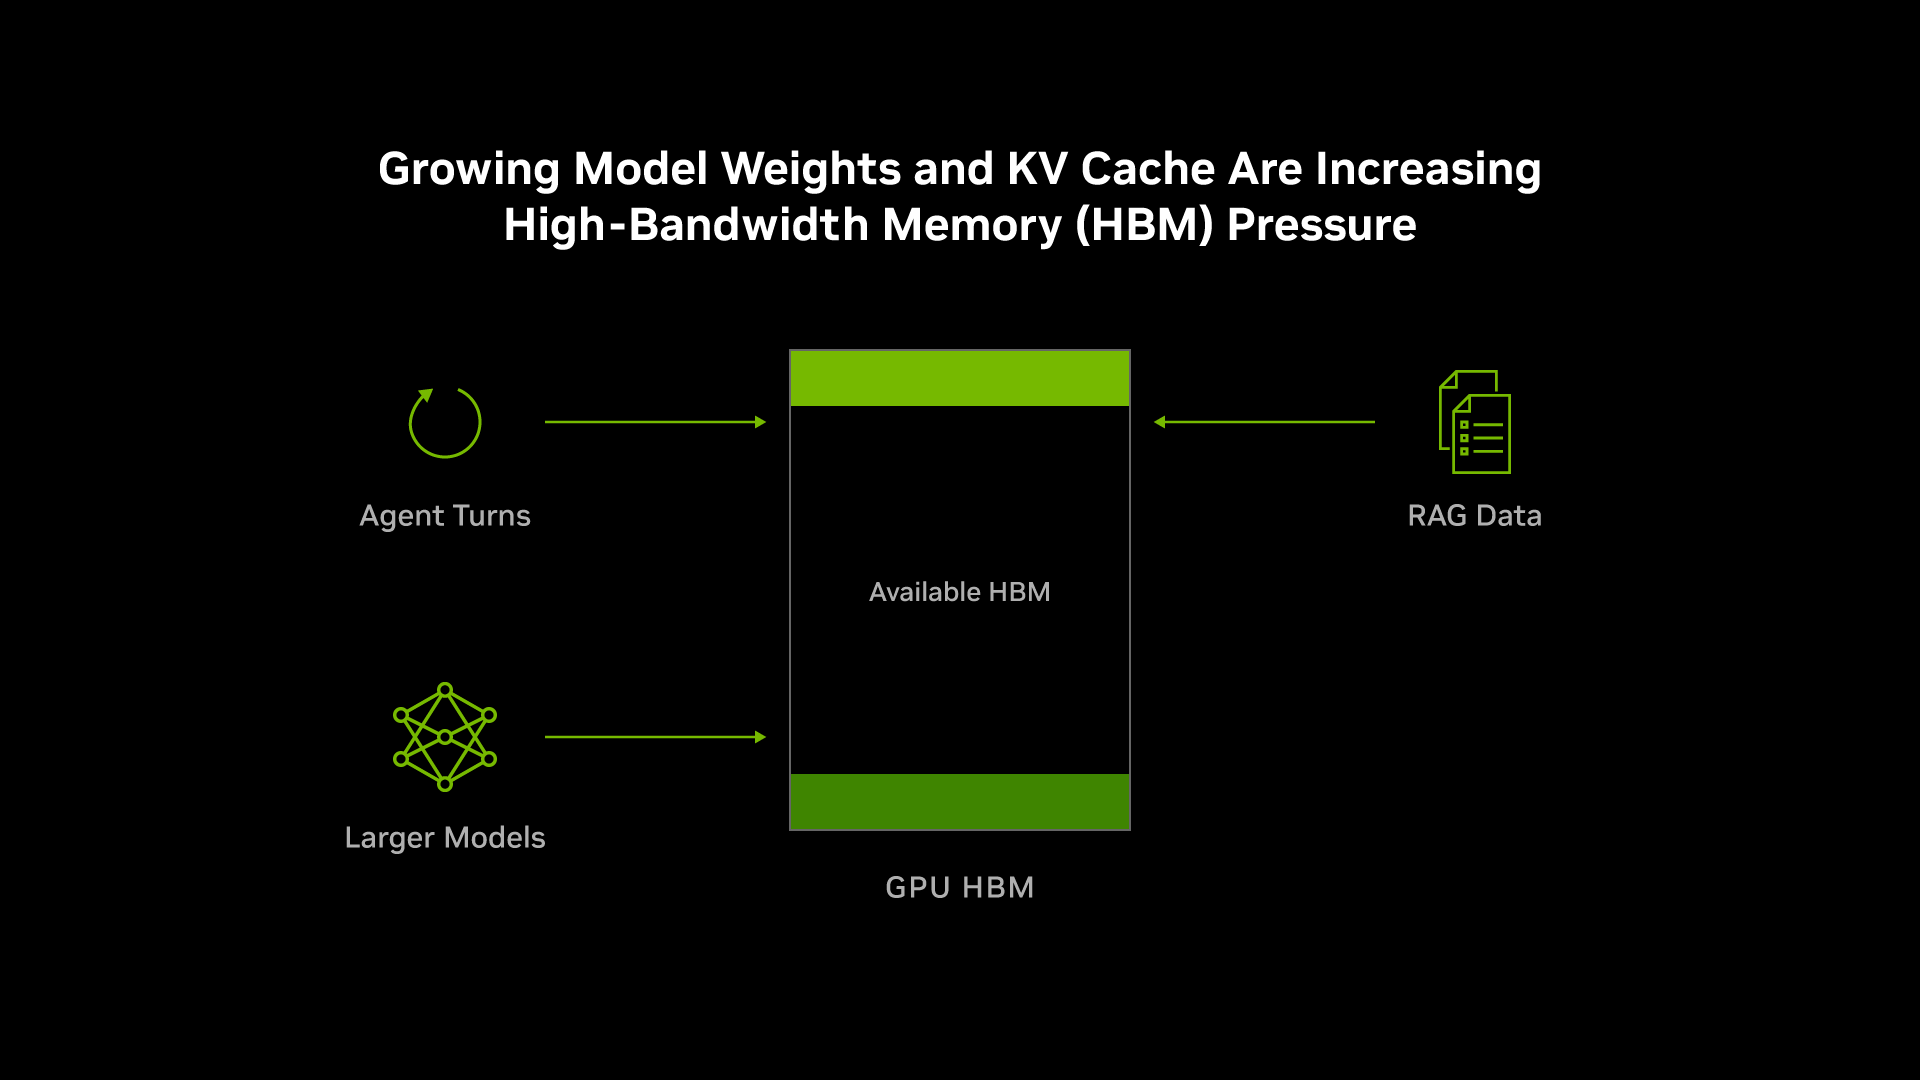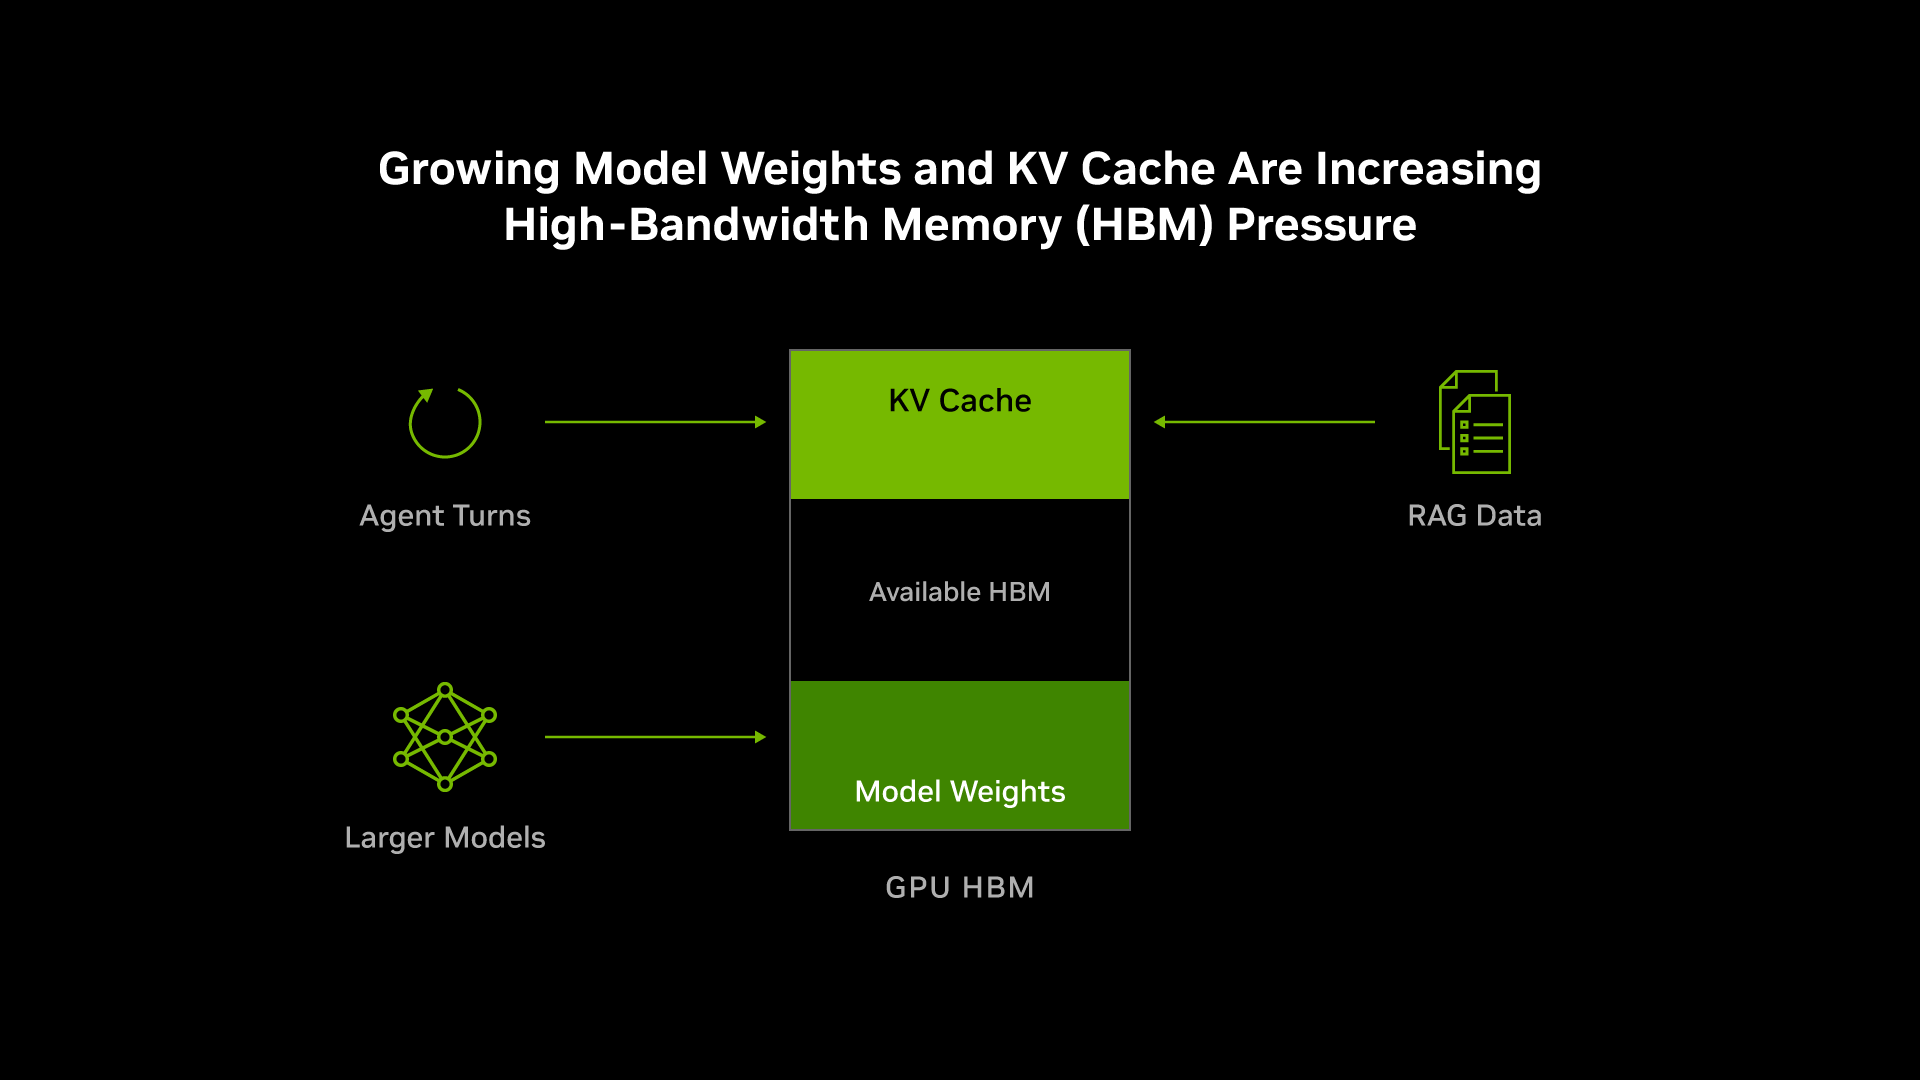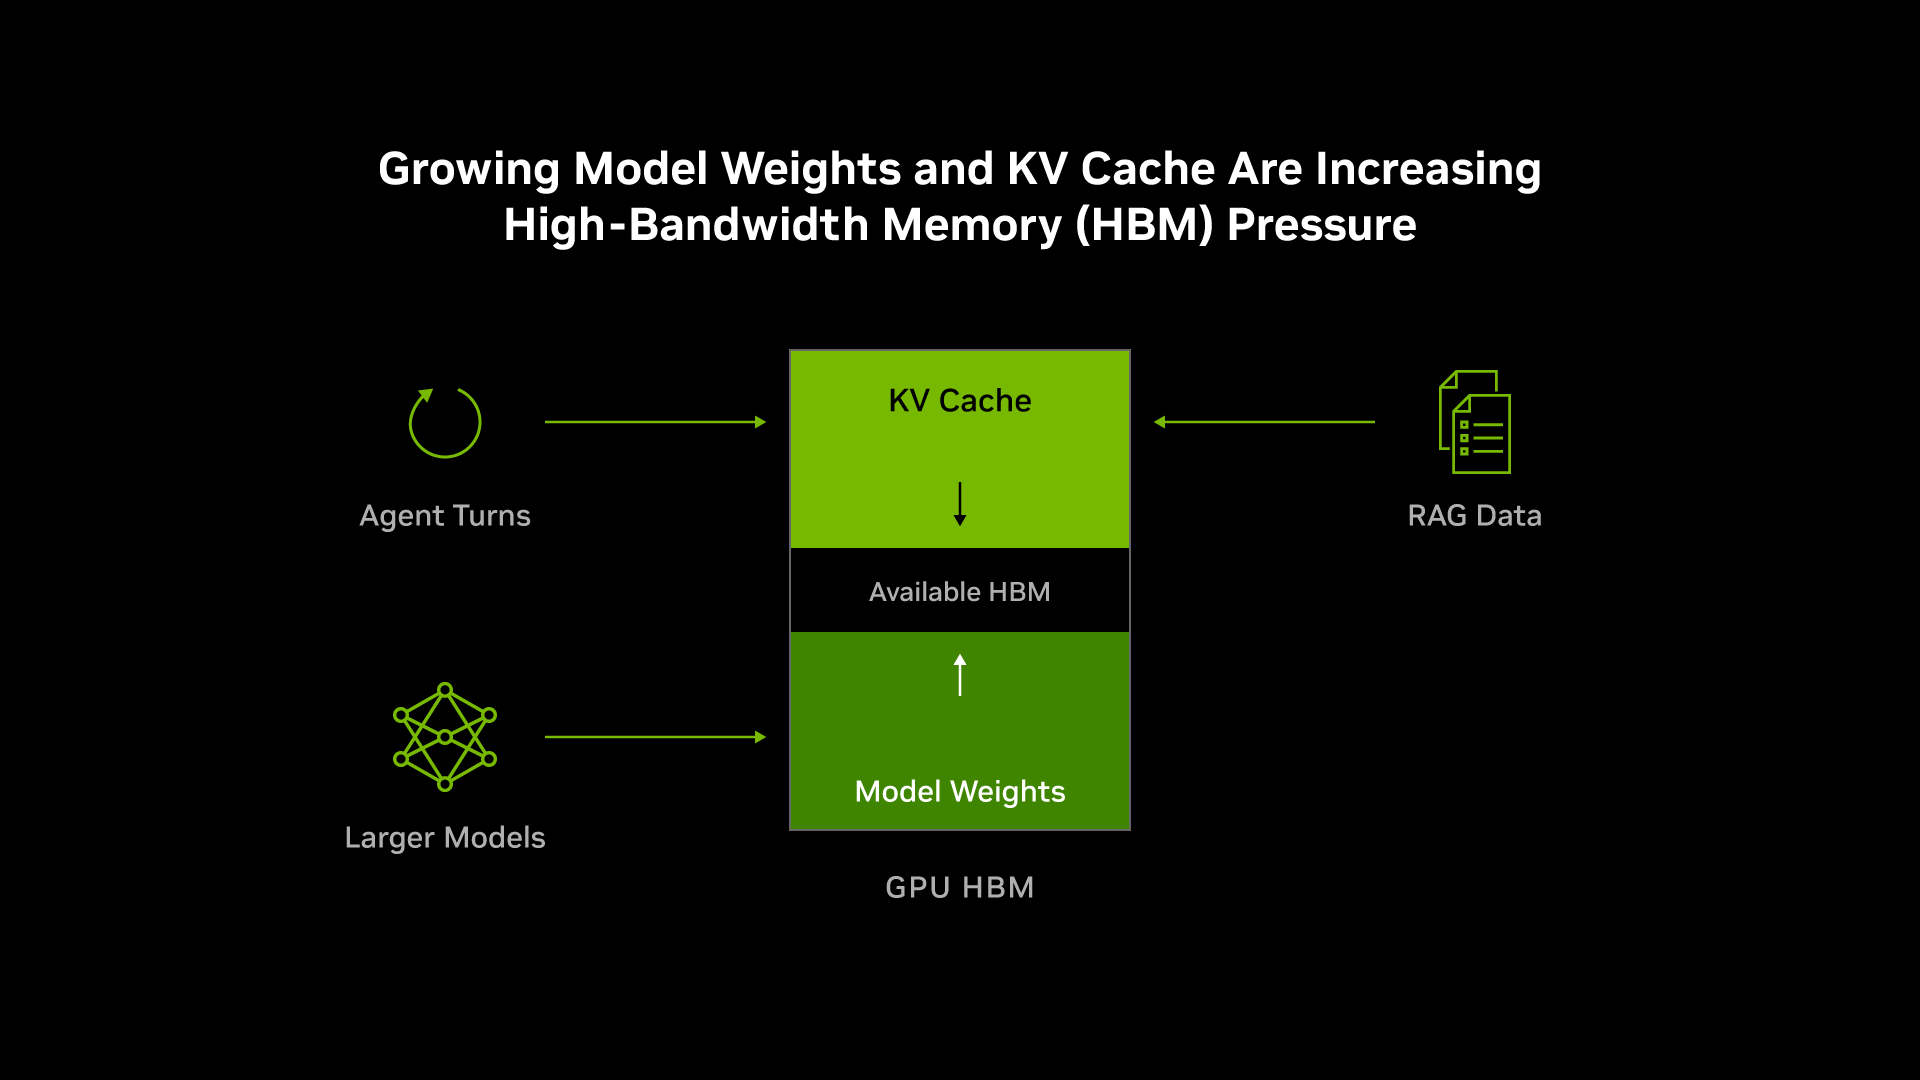
Etter hvert som AI-modeller øker i kompleksitet — med billioner av parametere, lengre kontekstvinduer og flere agentdrevne inferensoppgaver — intensiveres behovet for høy båndbredde-minne (HBM) på GPUer. NVIDIA fremhever at dette økende presset kolliderer med begrenset minnetilførsel og stigende priser, en utfordring som forventes å vare i nær fremtid.
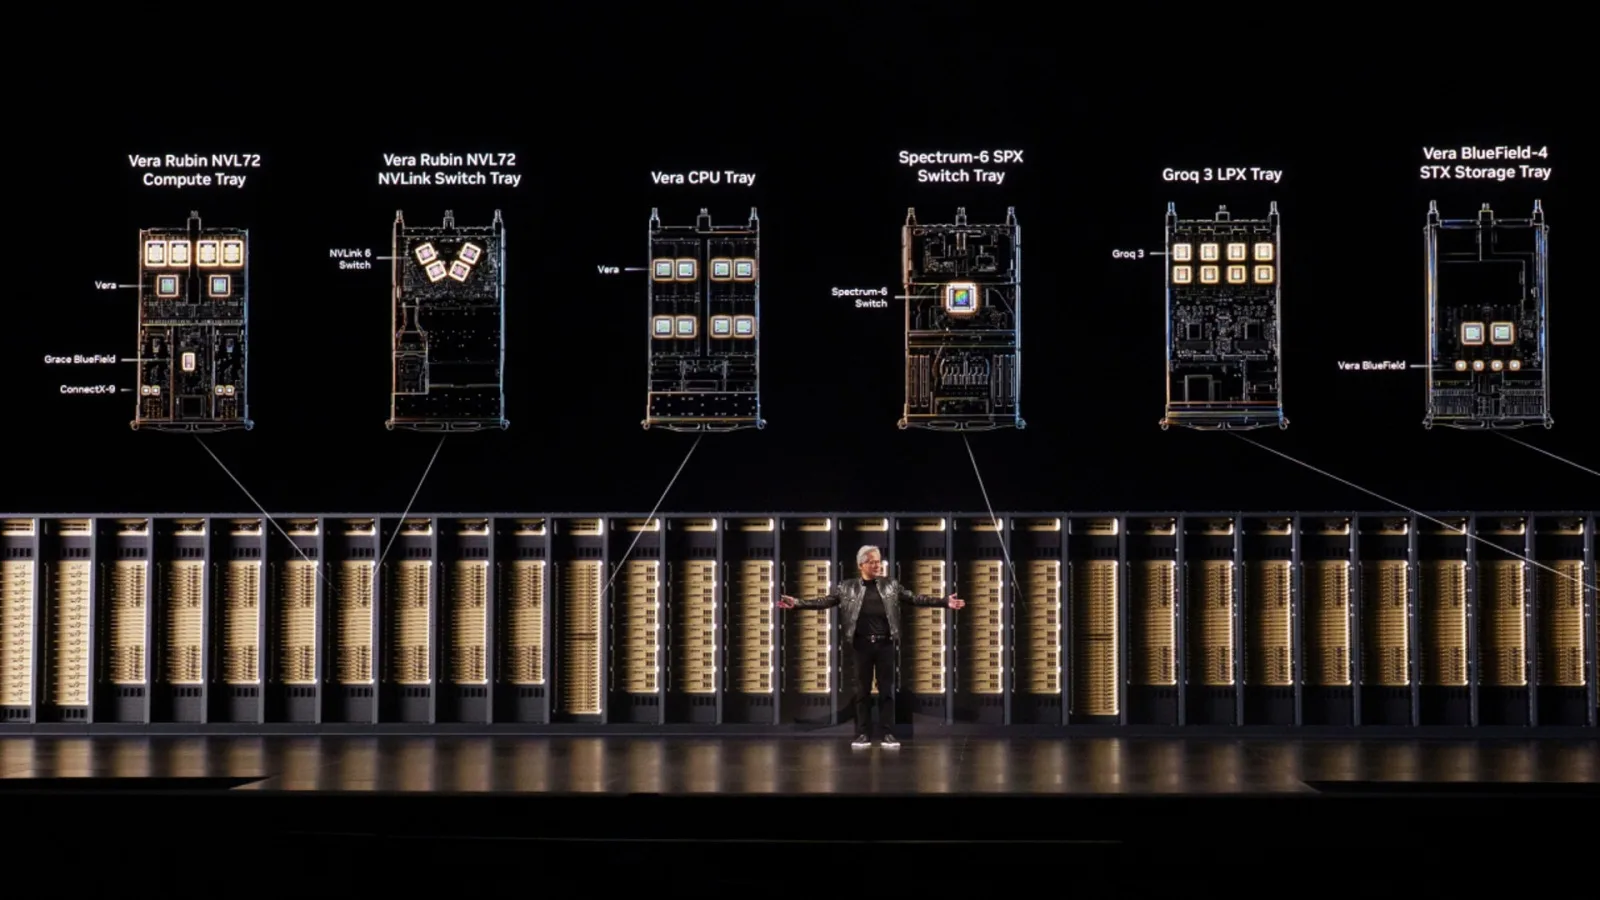
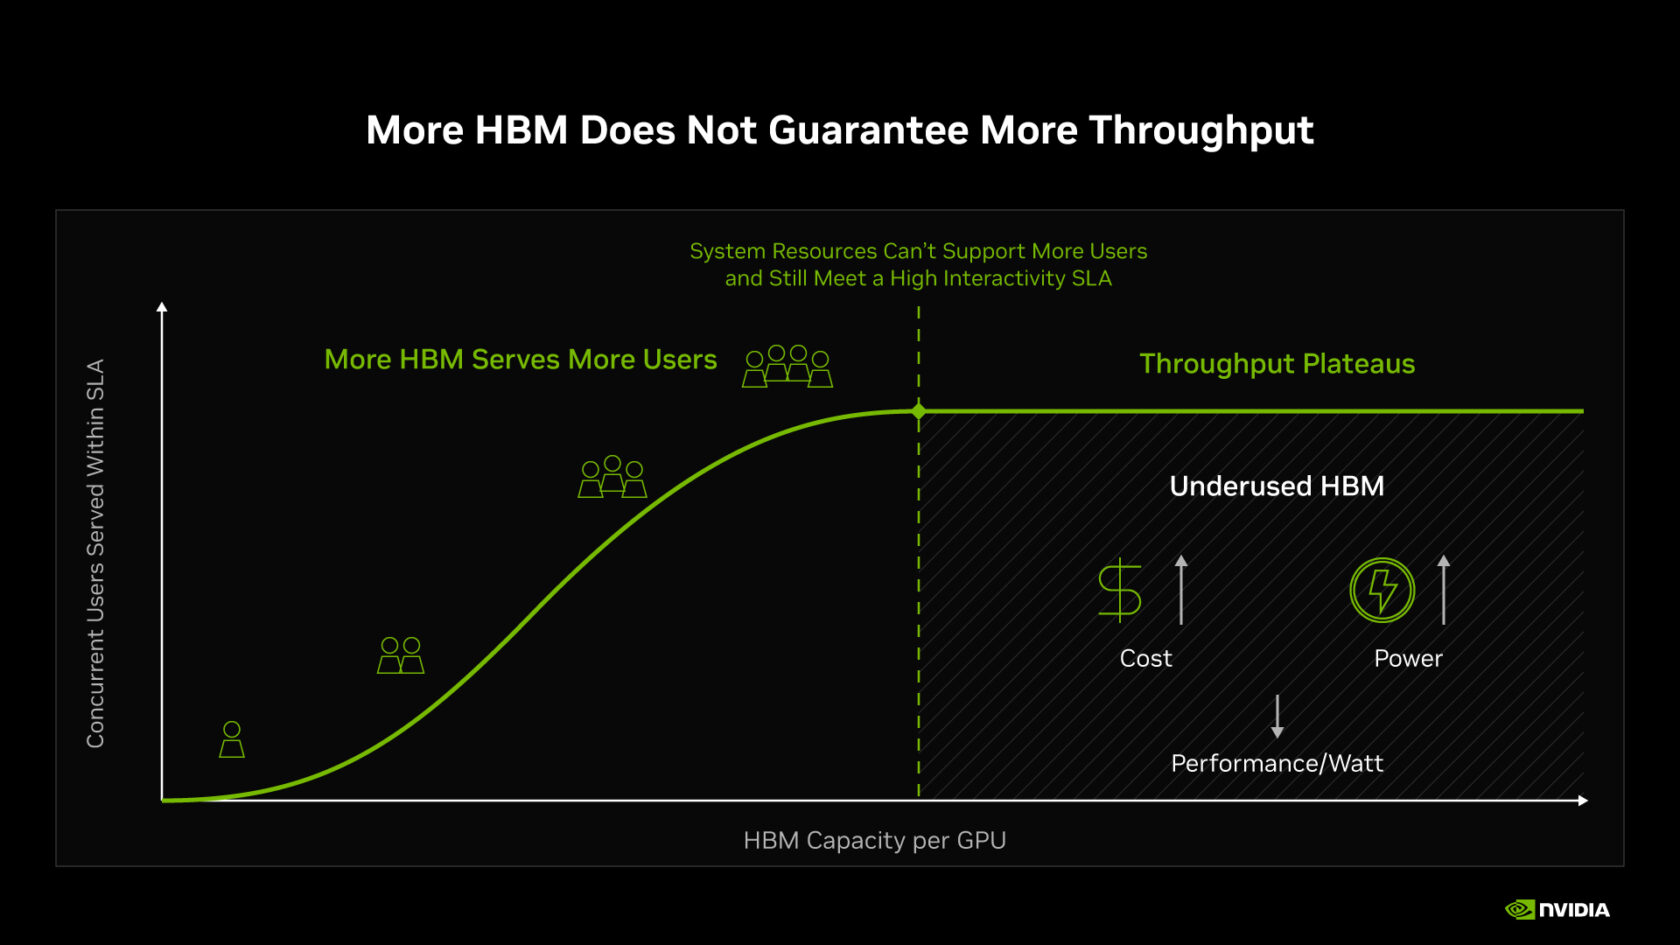
I stedet for bare å øke HBM-kapasiteten, som møter fysiske og kostnadsbegrensninger, fokuserer NVIDIA på helhetlig kodeutforming. Denne strategien innebærer samutvikling av GPU-maskinvare, CPUer, nettverk, lagringssystemer og programvare for å maksimere effektiv minnebruk på alle nivåer i AI-prosessrørledningen — kalt AI-fabrikken.
I disse AI-fabrikkene finnes et minnehierarki: det raskeste og dyreste laget er GPU HBM, som lagrer modellvekter og nøkkel-verdi (KV) cache med aktiv kontekst. Under dette finnes mer voluminøst, men langsommere CPU-minne, lokale SSD-er og delt lagring — som alle bytter hastighet mot kapasitet og kostnadseffektivitet. Målet er å redusere datamengden lagret i det dyreste laget, flytte inaktive data til rimeligere nivåer og forhåndslaste data tilbake til GPUer raskt, for å forbedre gjennomstrømning og redusere ventetid.
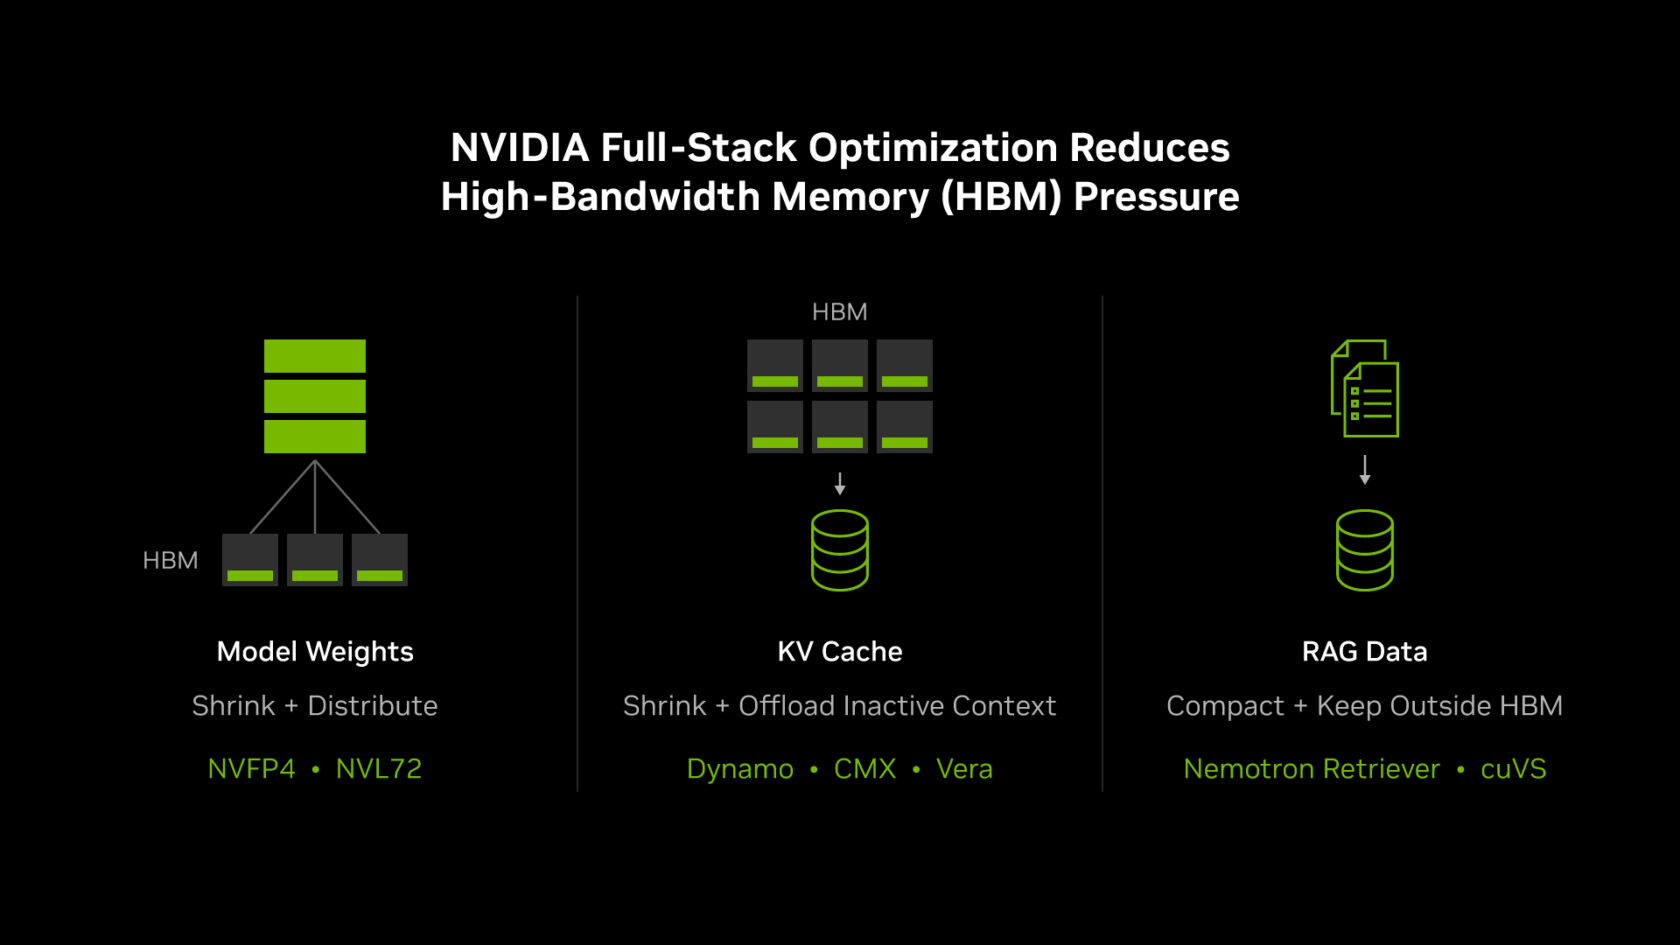
NVIDIAs tilnærming inkluderer flere nyvinninger. For det første benyttes et 4-biters flyttallsformat kalt NVFP4 for å krympe modellvekter og KV-cache, og dermed redusere minneavtrykket. Å distribuere hele modellen over opptil 72 GPUer innenfor NVL72-systemet frigjør i tillegg HBM for KV-cache og samtidige brukeroppgaver.
For det andre kan inaktiv KV-cache-kontekst flyttes fra dyr HBM til store CPU-tilknyttede minne- eller delte lagringsnivåer med den nye NVIDIA Dynamo inferensprogramvaren og CMX context memory-løsninger. Programvaren håndterer KV-cache på tvers av GPU-minne, CPU-minne og lagring for å muliggjøre rask gjenbruk uten å måtte holde all data konstant i HBM.
For det tredje reduserer retrieval-augmented generation (RAG)-teknikker HBM-belastningen ved å holde store bedriftskunnskapsbaser utenfor GPU-en. I stedet produserer NVIDIAs Nemotron Retriever kompakte vektorinnbygginger, og cuVS-biblioteket administrerer det søkbare indekset over CPU- og lagringslagene. Kun relevante passasjer føres inn i GPU-ens høyhastighetskontekst.
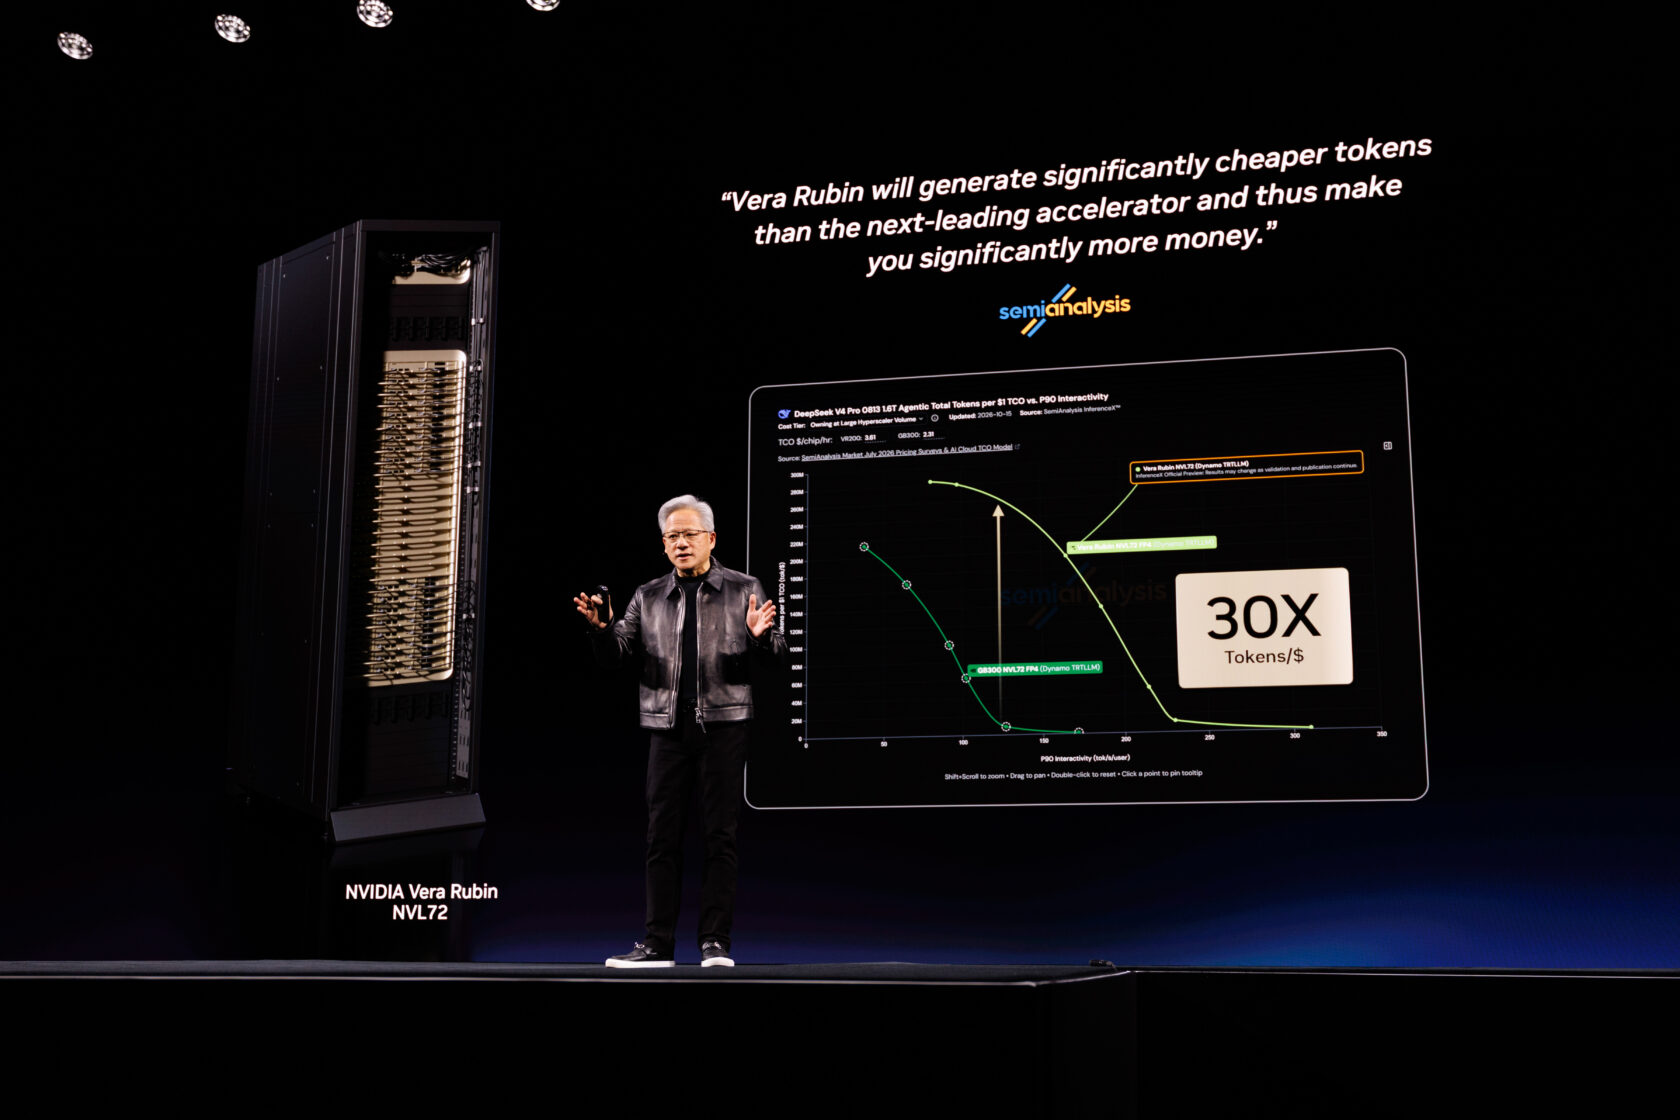
NVIDIA rapporterer at disse kombinerte optimaliseringene har ført til om lag 3 % økt HBM-kapasitet per GPU fra NVIDIA Blackwell Ultra til Vera Rubin-plattformen, men ga opptil 30 ganger høyere agentdrevet gjennomstrømning per dollar i testarbeidsbelastninger som SemiAnalysis AgentX.
Ved å ta tak i minnebåndbreddebegrensningene — den såkalte minneveggen — muliggjør NVIDIAs helhetlige kodeutforming at AI-arbeidsbelastninger kan utføre flere nyttige beregninger per minnebyte, noe som reduserer strømforbruk og kostnader. Denne helhetlige minnehåndteringsstrategien markerer et skifte fra å jage rå minnekapasitet til å orkestrere effektivitet på tvers av maskinvare- og programvarelag for AI-ens voksende behov.
For detaljert teknisk innsikt tilbyr NVIDIA en videoforklaring og dypdykk i hvordan helhetlig kodeutforming reduserer minnepress ved inferens og forbedrer økonomien i AI-plattformen.
Kilder og originalrapportering
Les originalkilden ↗
Kommentarer (0)
Ingen kommentarer ennå. Start diskusjonen.
Skriv en kommentar
Kommentarer publiseres etter moderering. Ditt navn og kommentar vil være synlige offentlig. Konto