
NVIDIA förbättrar AI:s minneseffektivitet med helintegrerad koddesign
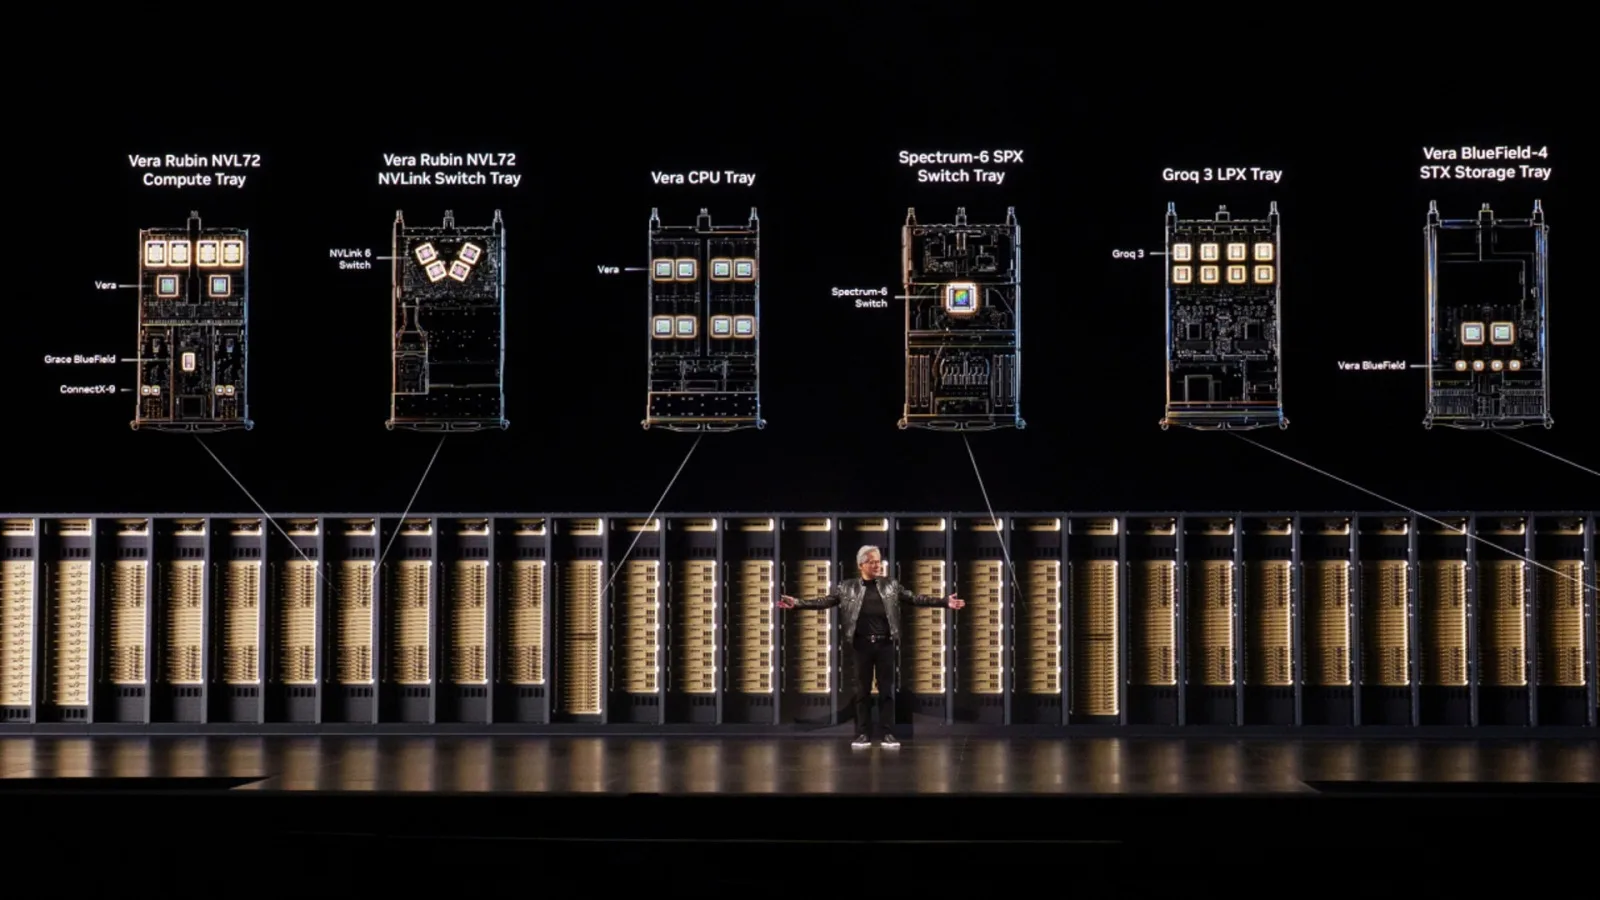
Bild: NVIDIA · Källa
NVIDIA hanterar den ökande efterfrågan på GPU-minne inom AI genom helintegrerad koddesign som optimerar minnesanvändning över hårdvara och mjukvara för att öka genomflöde och effektivitet trots begränsad kapacitet för högbandbreddminne.
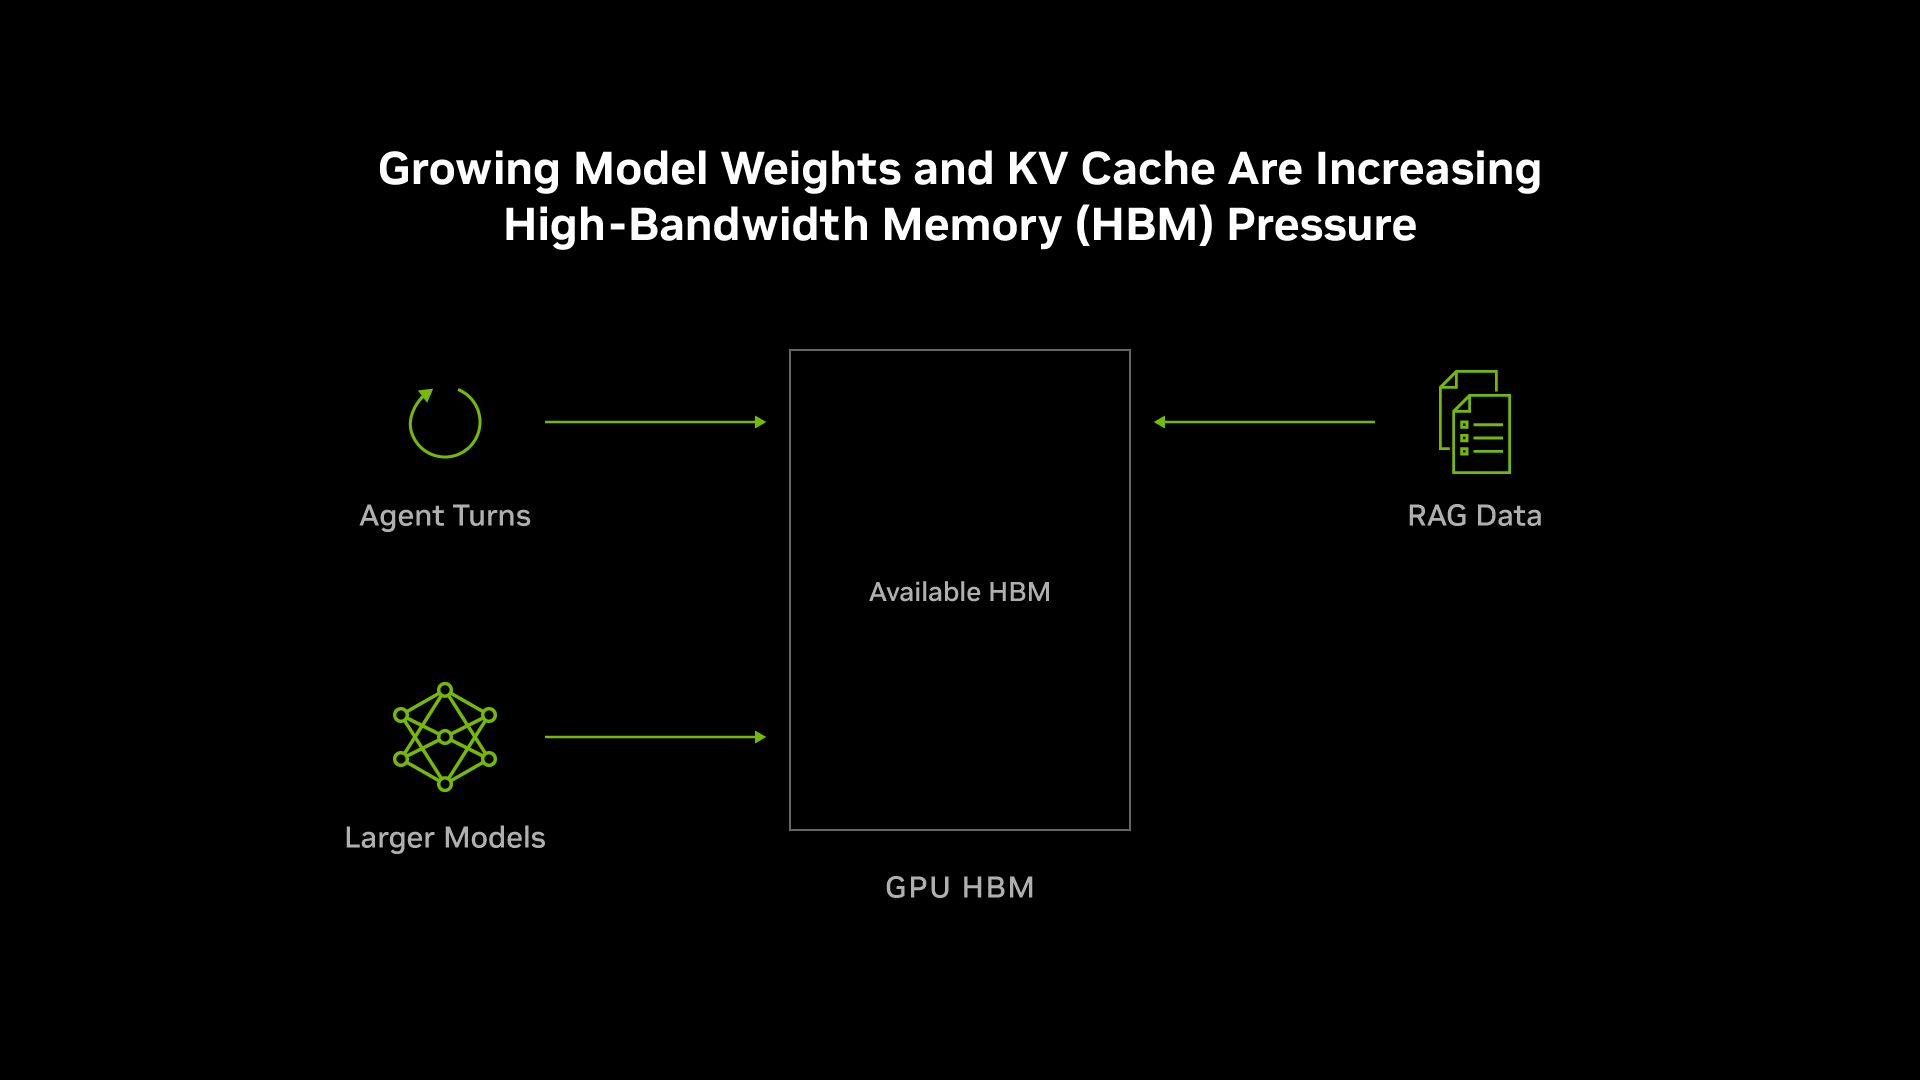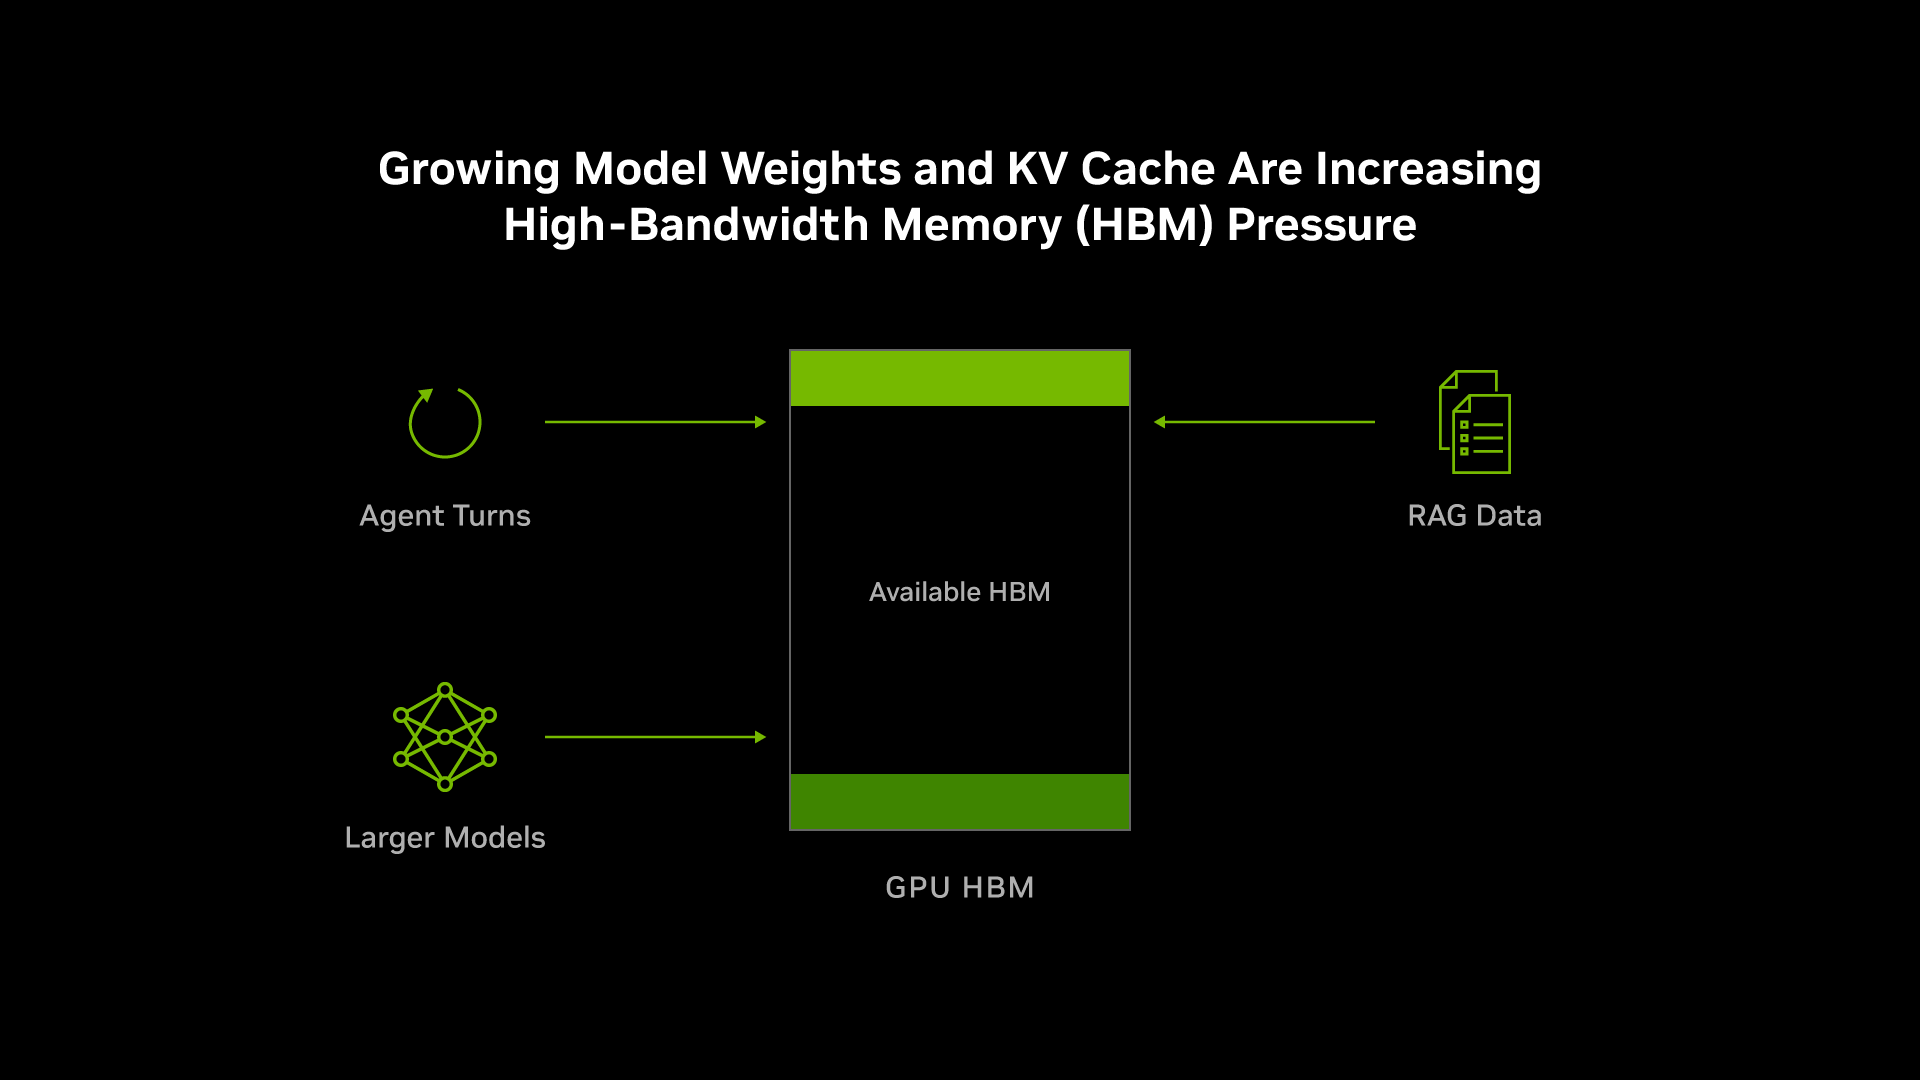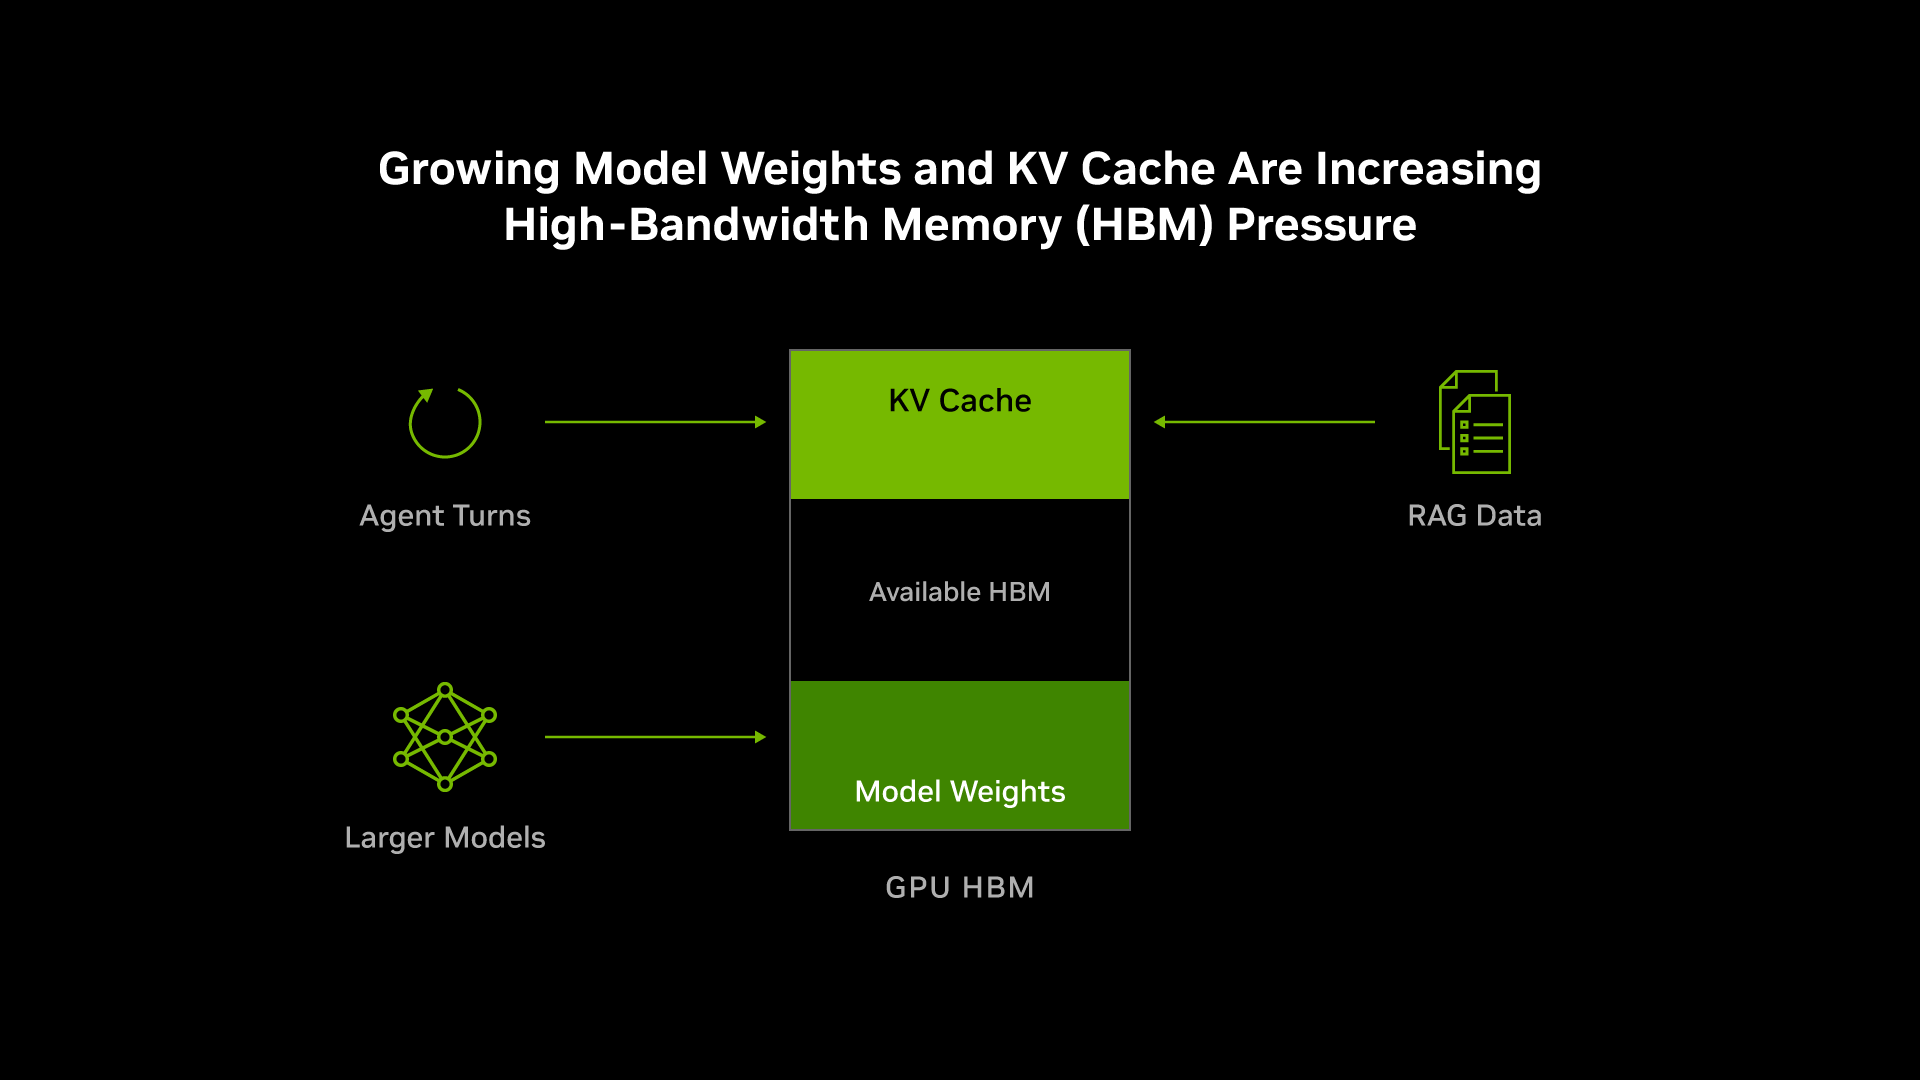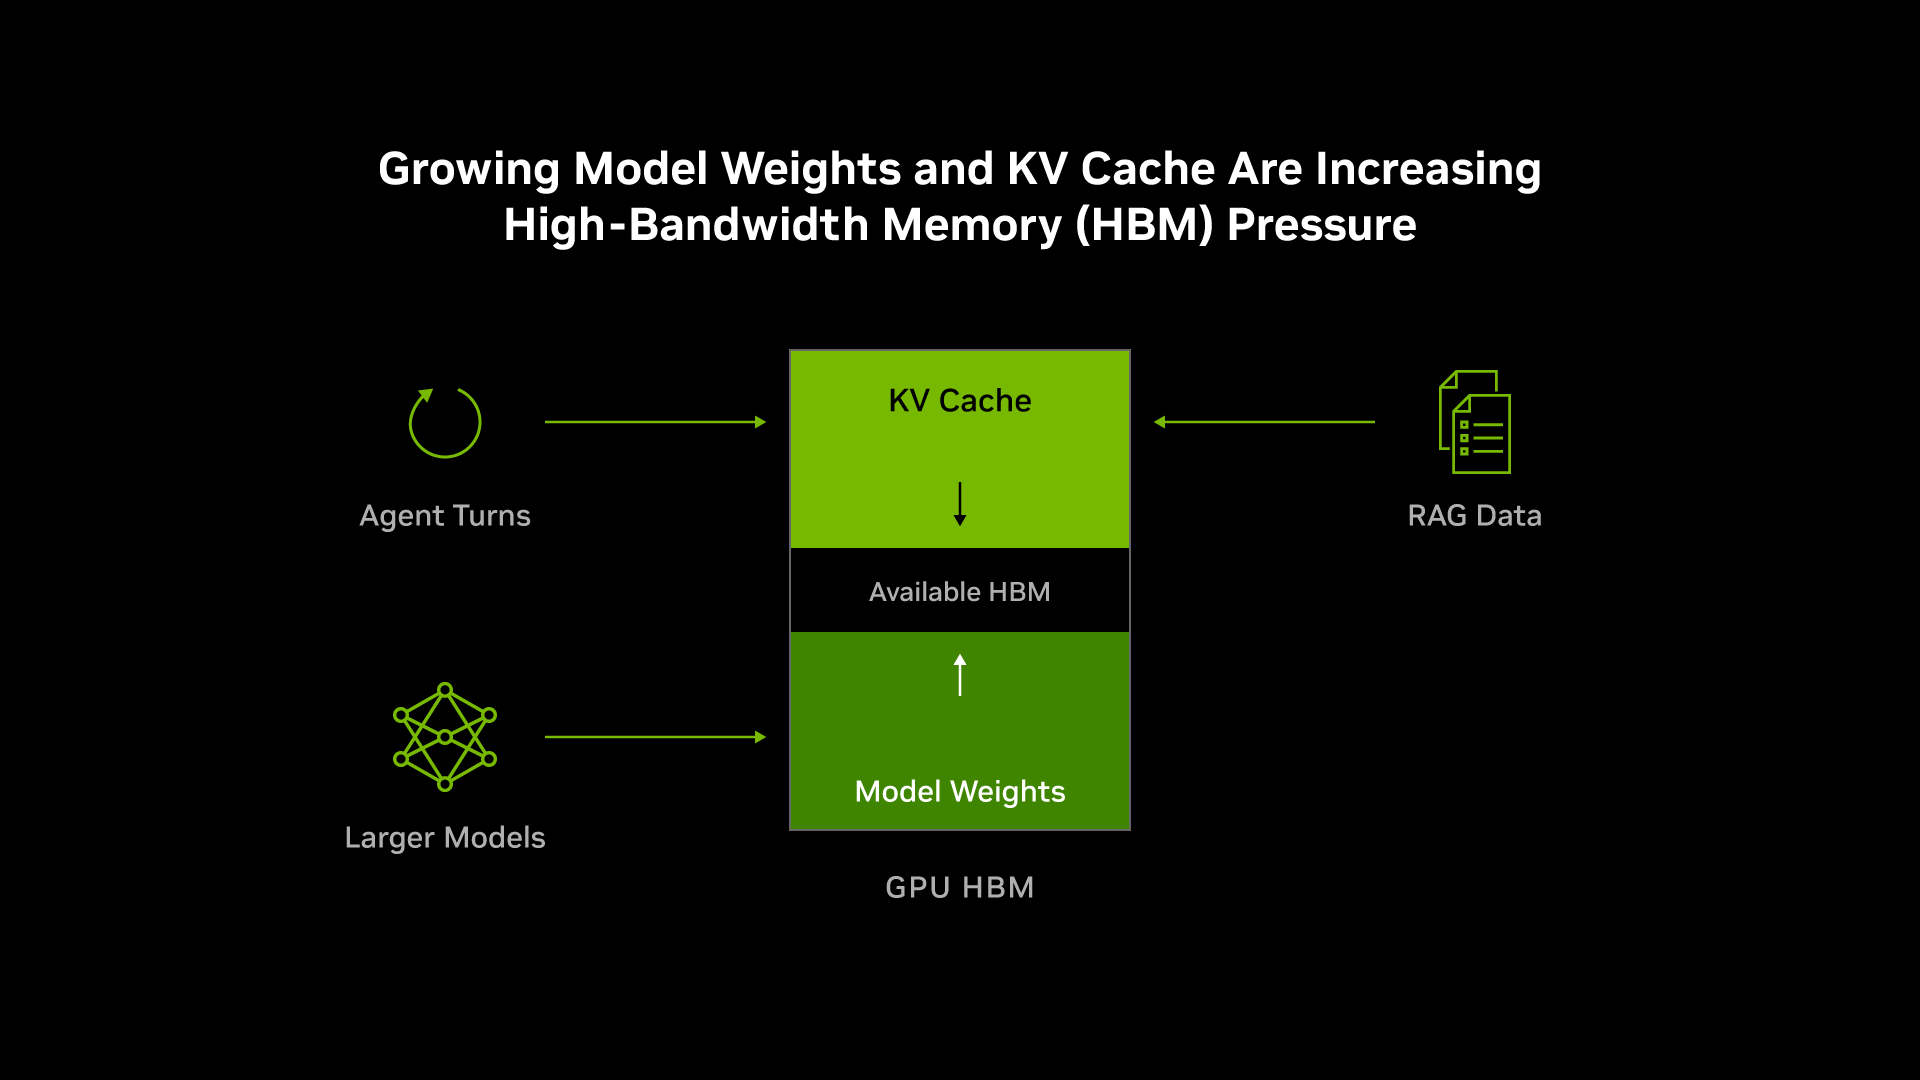
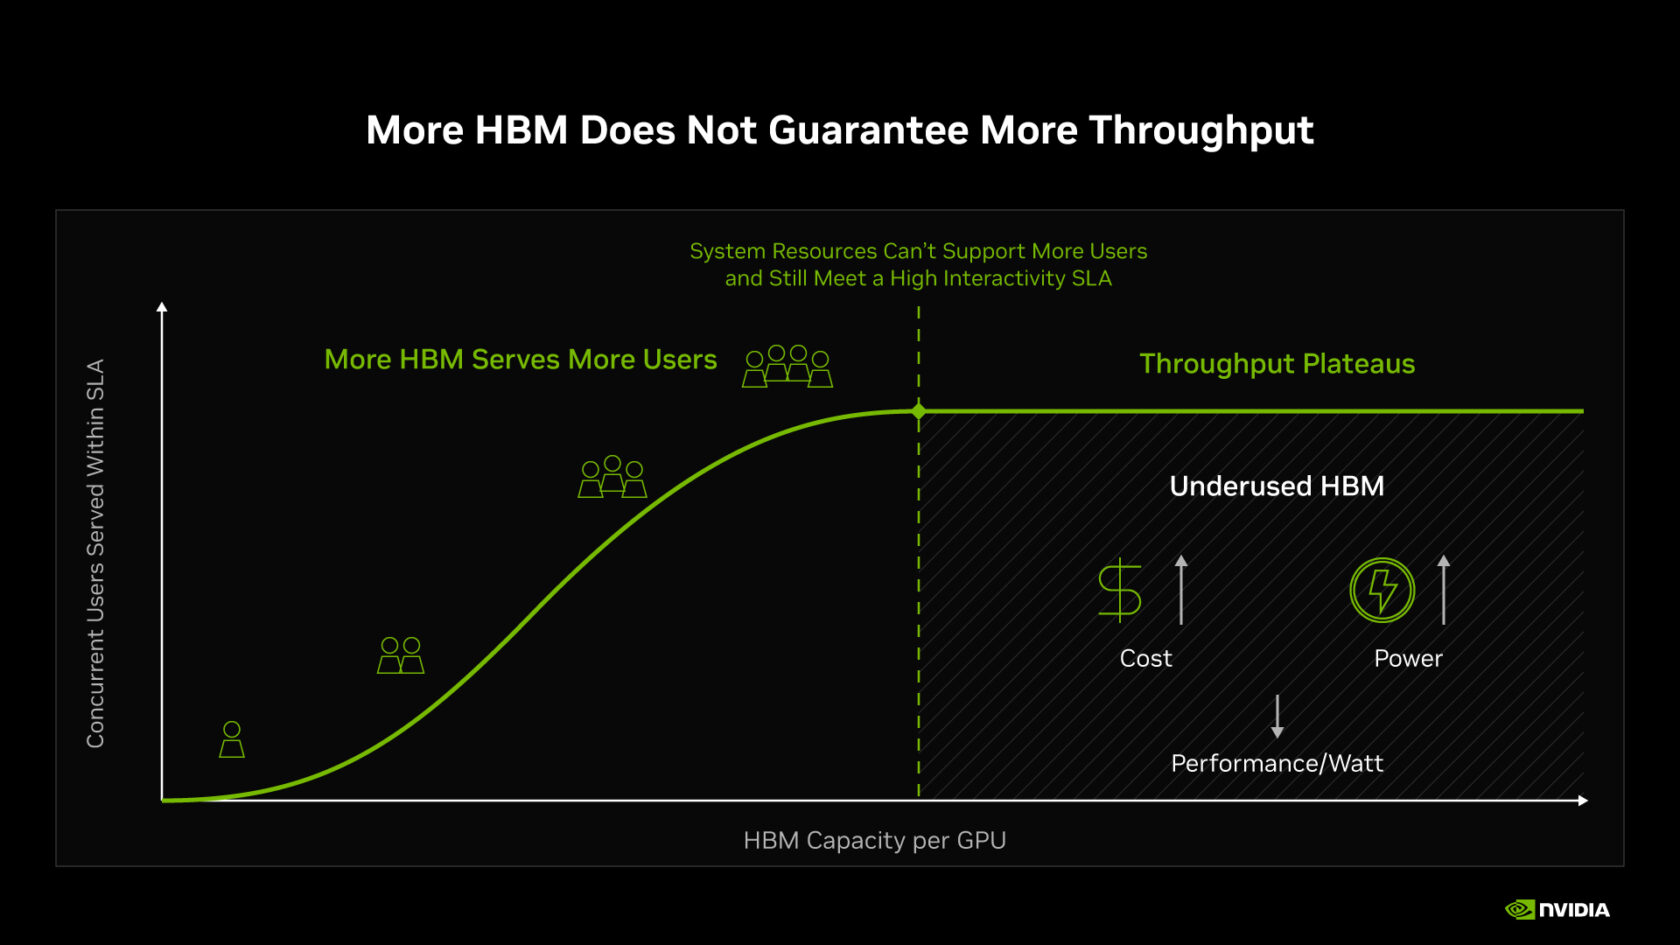
När AI-modeller växer i komplexitet — med biljoner parametrar, längre kontextfönster och fler autonoma inferensuppgifter — ökar behovet av högbandbreddminne (HBM) på GPUs. NVIDIA påpekar att denna ökande press står i konflikt med begränsad minneskapacitet och stigande priser, en utmaning som förväntas bestå på kort sikt.
Istället för att enbart öka HBM-kapaciteten, vilket stöter på fysiska och kostnadsmässiga begränsningar, fokuserar NVIDIA på helintegrerad koddesign. Denna strategi innebär att GPU-hårdvara, CPU:er, nätverk, lagringssystem och mjukvara utformas ihop för att maximera effektiv minnesanvändning på alla nivåer i AI-bearbetningspipeline — kallad AI-fabriken.
I dessa AI-fabriker finns en minneshierarki: det snabbaste och dyraste lagret är GPU HBM, som lagrar modellvikter och key-value (KV) cache med aktiv kontext. Under detta finns mer volymstark men långsammare CPU-minne, lokala SSD-enheter och delad lagring — alla med kompromiss mellan hastighet och kostnadseffektivitet. Målet är att minska mängden data som lagras i det dyraste lagret, flytta inaktiv data till billigare nivåer och förinläsa data till GPUs snabbt, vilket förbättrar genomflödet och minskar latens.
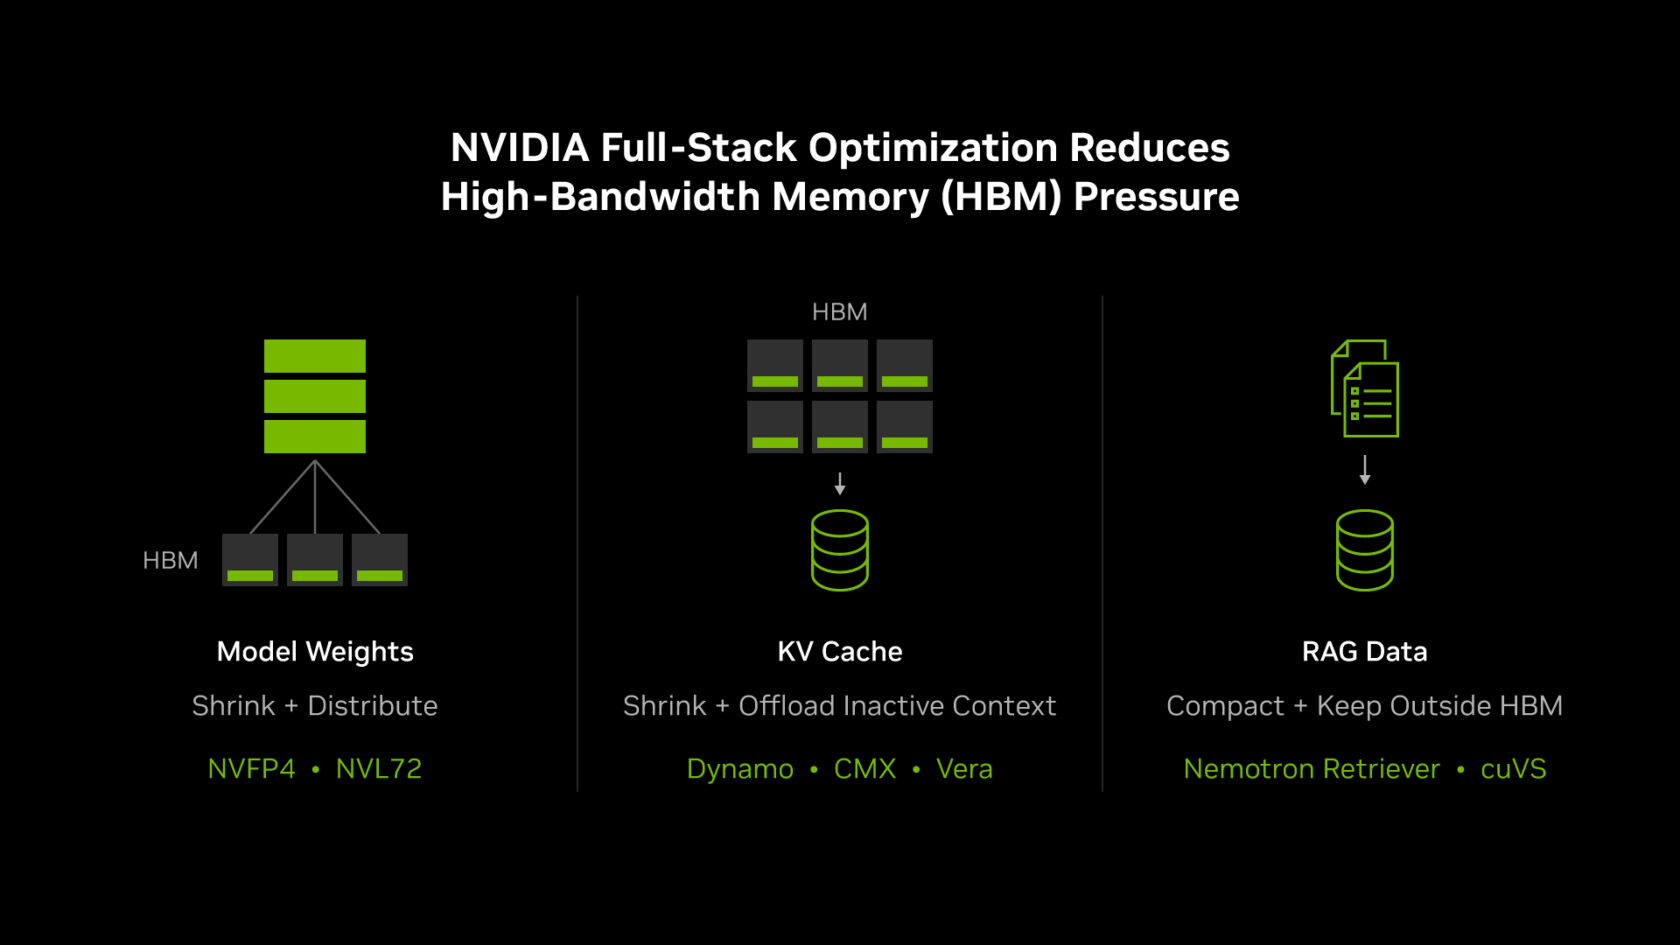
NVIDIAs ansats inkluderar flera innovationer. För det första används ett 4-bitars flyttalsformat kallat NVFP4 för att krympa modellvikter och KV-cache, vilket minskar minnesavtrycket. Genom att distribuera hela modellen över upp till 72 GPUs inom NVL72-systemet frigörs dessutom HBM för KV-cache och användarkonkurens.
För det andra kan inaktiv KV-cache kontext avlastas från dyrt HBM till stora CPU-anslutna minnes- eller delade lagringsnivåer med hjälp av den nya NVIDIA Dynamo-inferensmjukvaran och CMX context memory-lösningar. Denna mjukvara hanterar KV-cache över GPU-minne, CPU-minne och lagring för att möjliggöra snabb återanvändning utan att all data behöver ligga permanent i HBM.
För det tredje minskar retrieval-augmented generation (RAG) tekniker HBM-belastningen genom att hålla stora företagskunskapsbaser utanför GPU:n. Istället producerar NVIDIAs Nemotron Retriever kompakta vektorembeddingar, och cuVS-biblioteket hanterar den sökbara indexen över CPU- och lagringslager. Endast relevanta avsnitt förs in i GPU:ns högpresterande kontext.
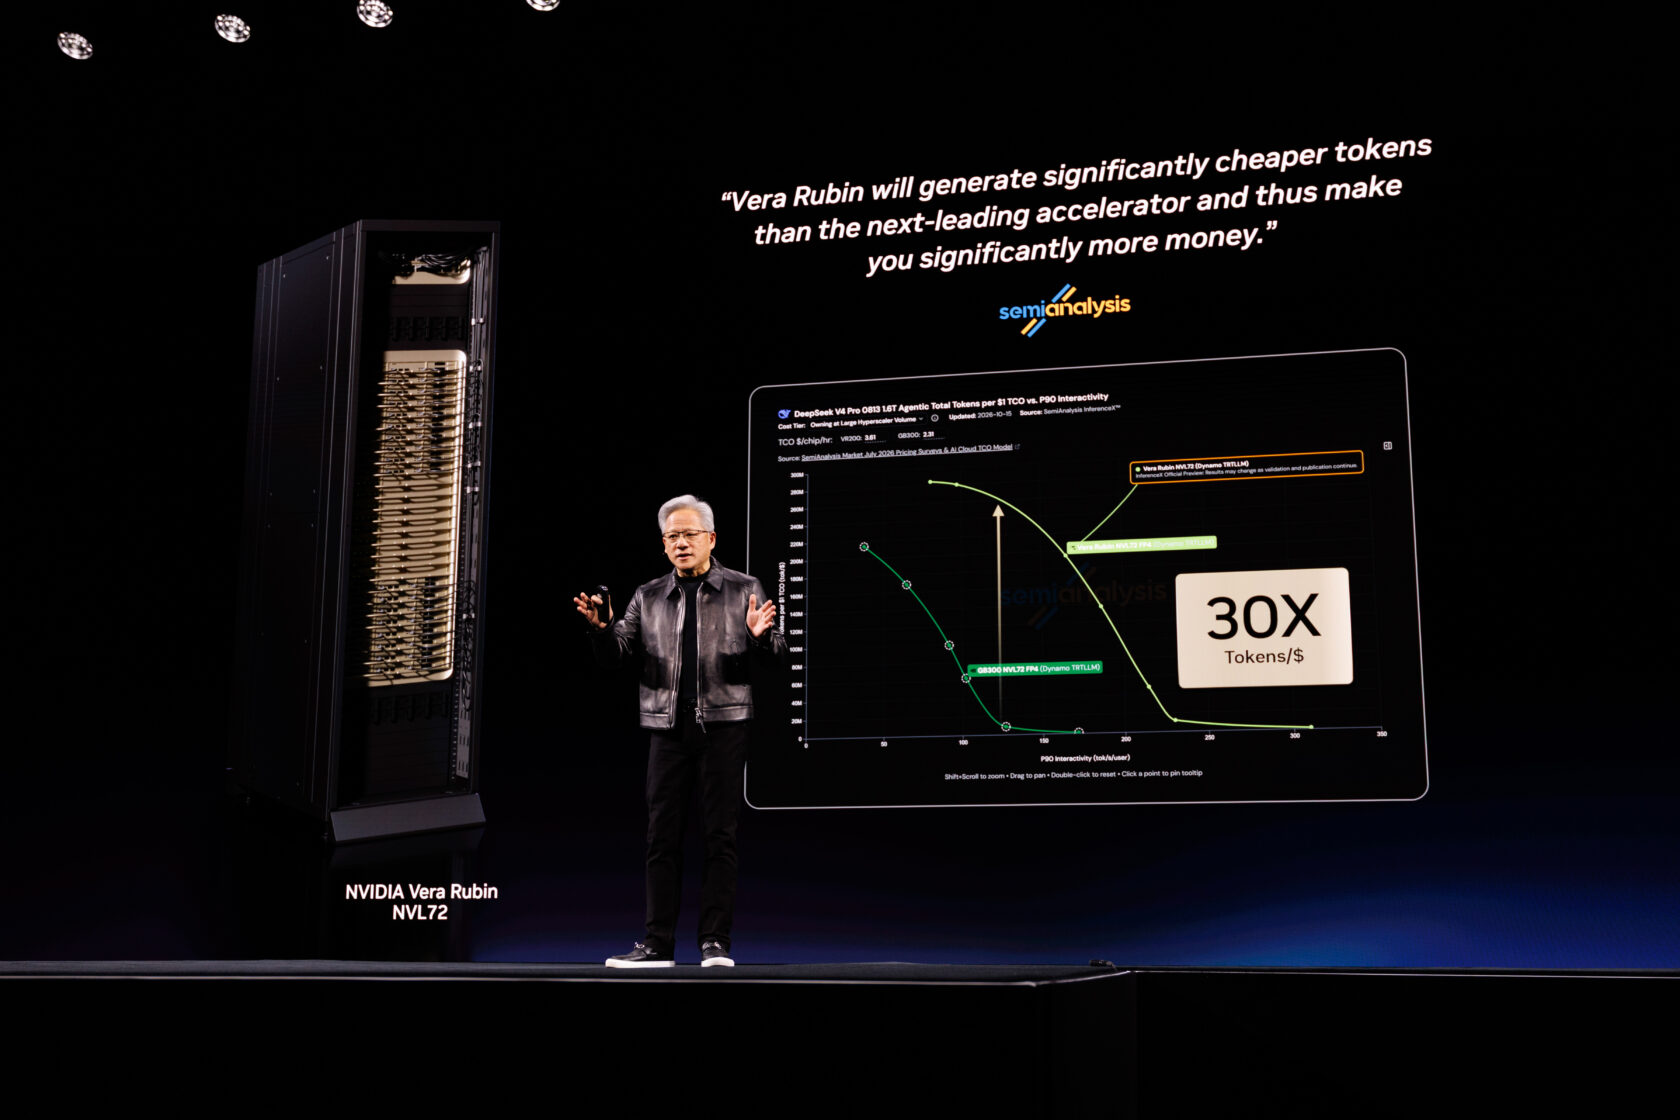
NVIDIA rapporterar att dessa kombinerade optimeringar lett till cirka 3 % ökad HBM-kapacitet per GPU från NVIDIA Blackwell Ultra via Vera Rubin-plattformen men givit upp till 30 gånger högre agentiskt genomflöde per dollar i testarbetsuppgifter som SemiAnalysis AgentX.
Genom att angripa minnesbandbreddsbegränsningar — det så kallade minnesväggen — möjliggör NVIDIAs helintegrerade koddesign att AI-arbetslaster kan utföra fler användbara beräkningar per minnesbyte, vilket sänker energiförbrukning och kostnader. Denna holistiska minneshanteringsstrategi markerar ett skifte från att jaga rå minneskapacitet till att samordna effektivitet över hård- och mjukvarulager för AI:s växande krav.
För detaljerad teknisk insikt erbjuder NVIDIA en videoförklaring och djupdykning i hur helintegrerad koddesign minskar inferensminnestrycket och förbättrar AI-plattformens ekonomi.
Källor och ursprunglig rapportering
Läs den ursprungliga källan ↗
Kommentarer (0)
Inga kommentarer ännu. Börja diskussionen.
Skriv en kommentar
Kommentarer publiceras efter granskning. Ditt namn och kommentar syns offentligt. Konto