
NVIDIA uzlabo mākslīgā intelekta atmiņas efektivitāti ar pilna steka kopprojektēšanas pieeju
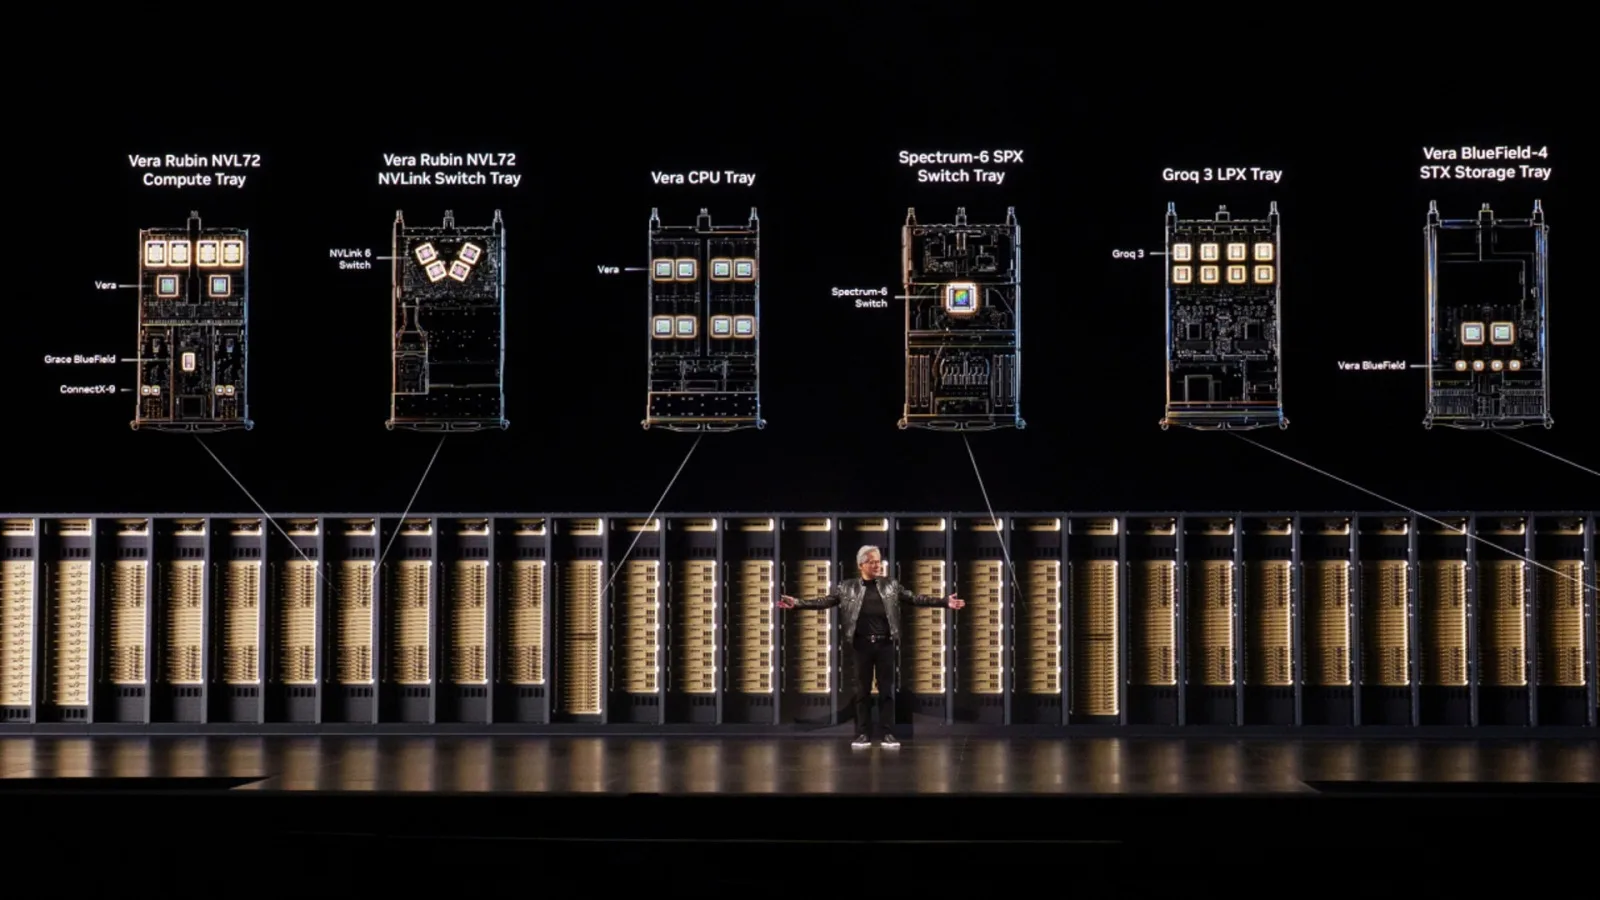
Attēls: NVIDIA · Avots
NVIDIA risina pieaugošās GPU atmiņas prasības mākslīgajā intelektā, izmantojot pilna steka kopprojektēšanu, optimizējot atmiņas izmantošanu gan aparatūrā, gan programmatūrā, lai palielinātu caurlaidību un efektivitāti, neskatoties uz ierobežotu ātras joslas atmiņas kapacitāti.
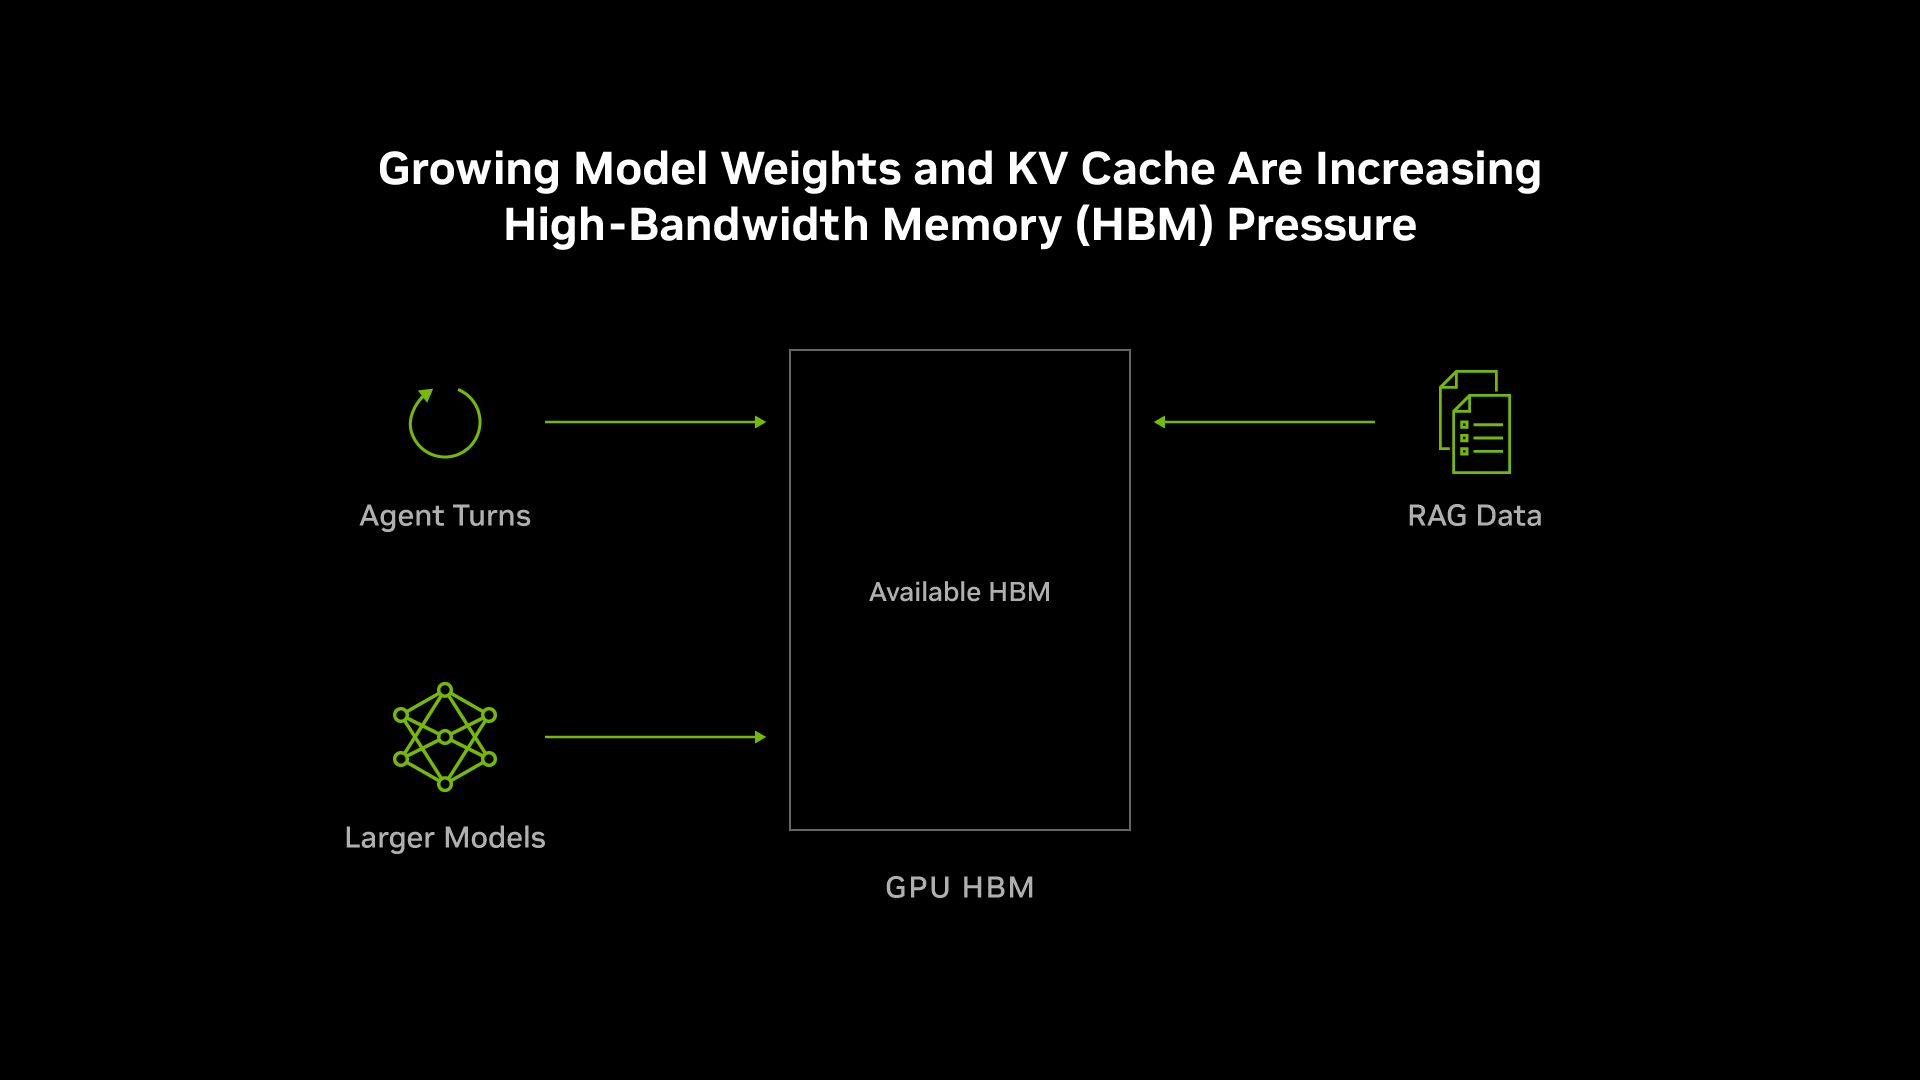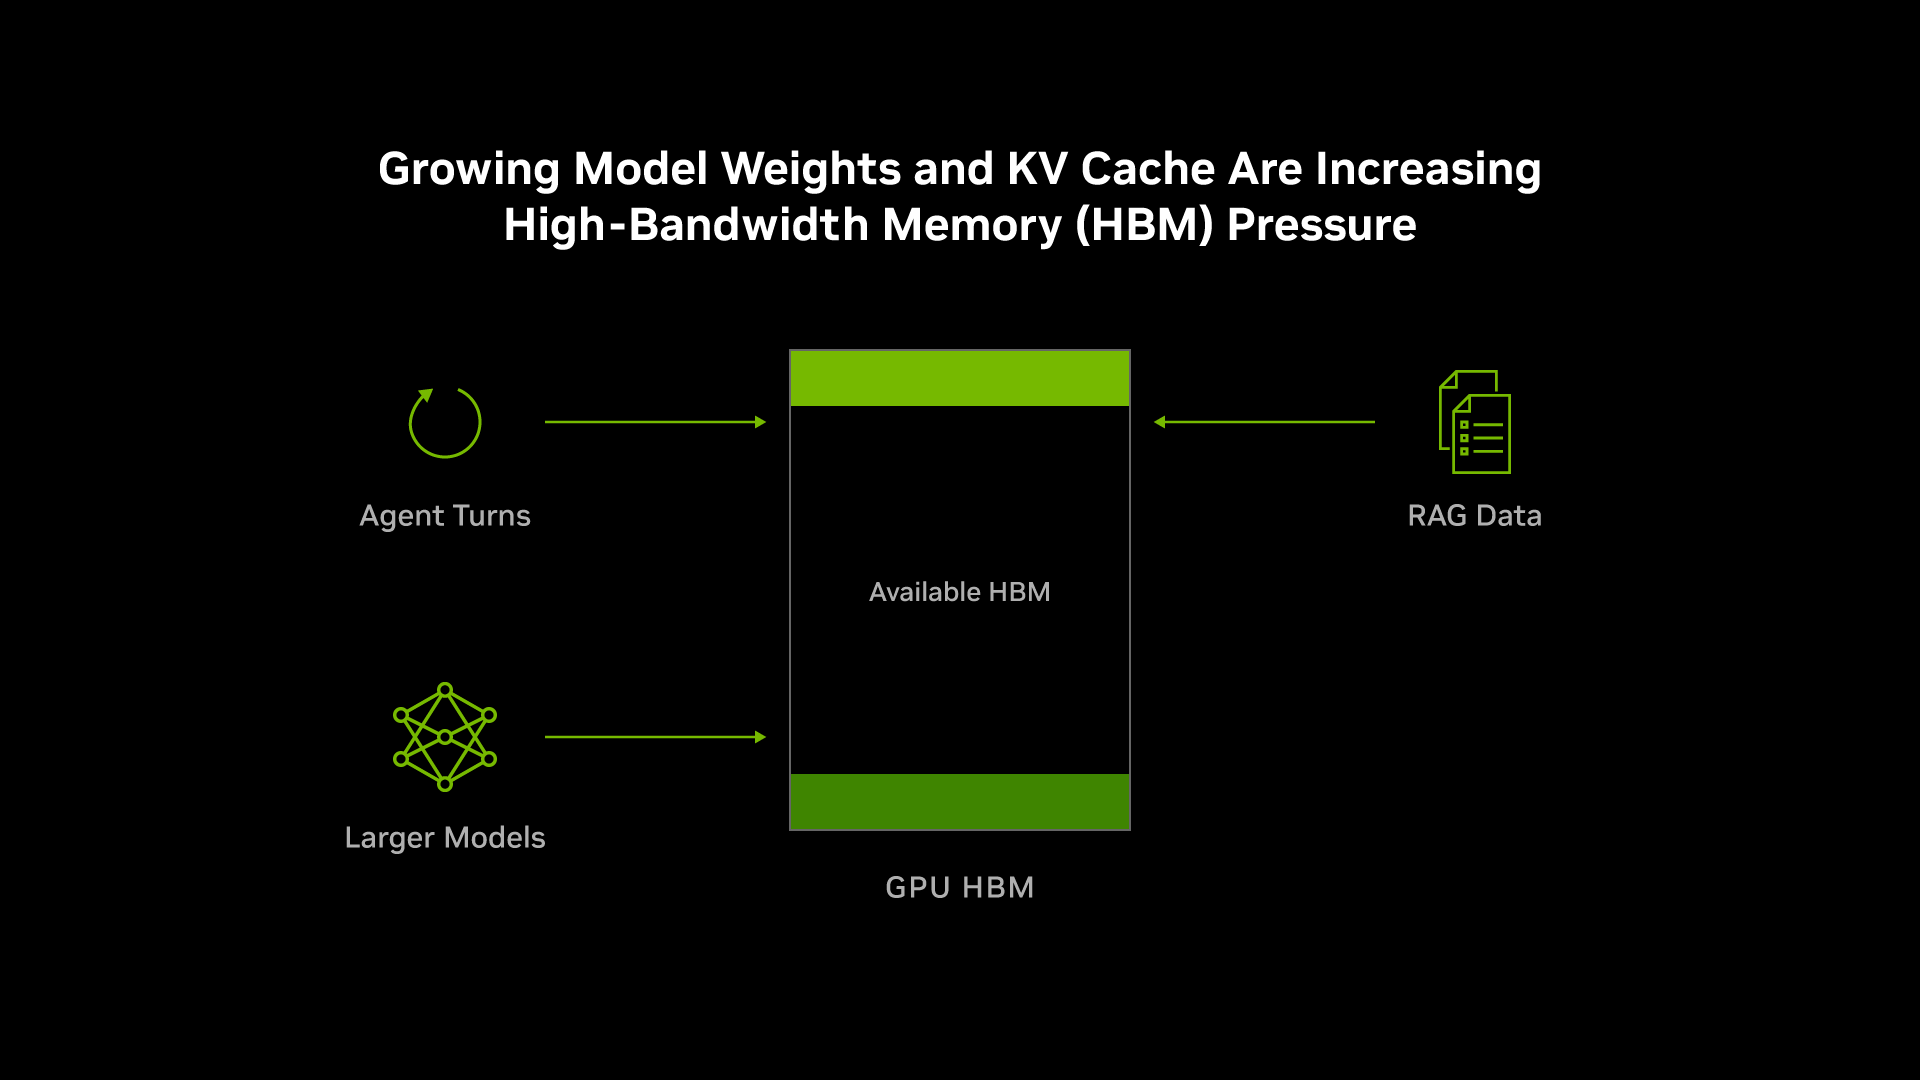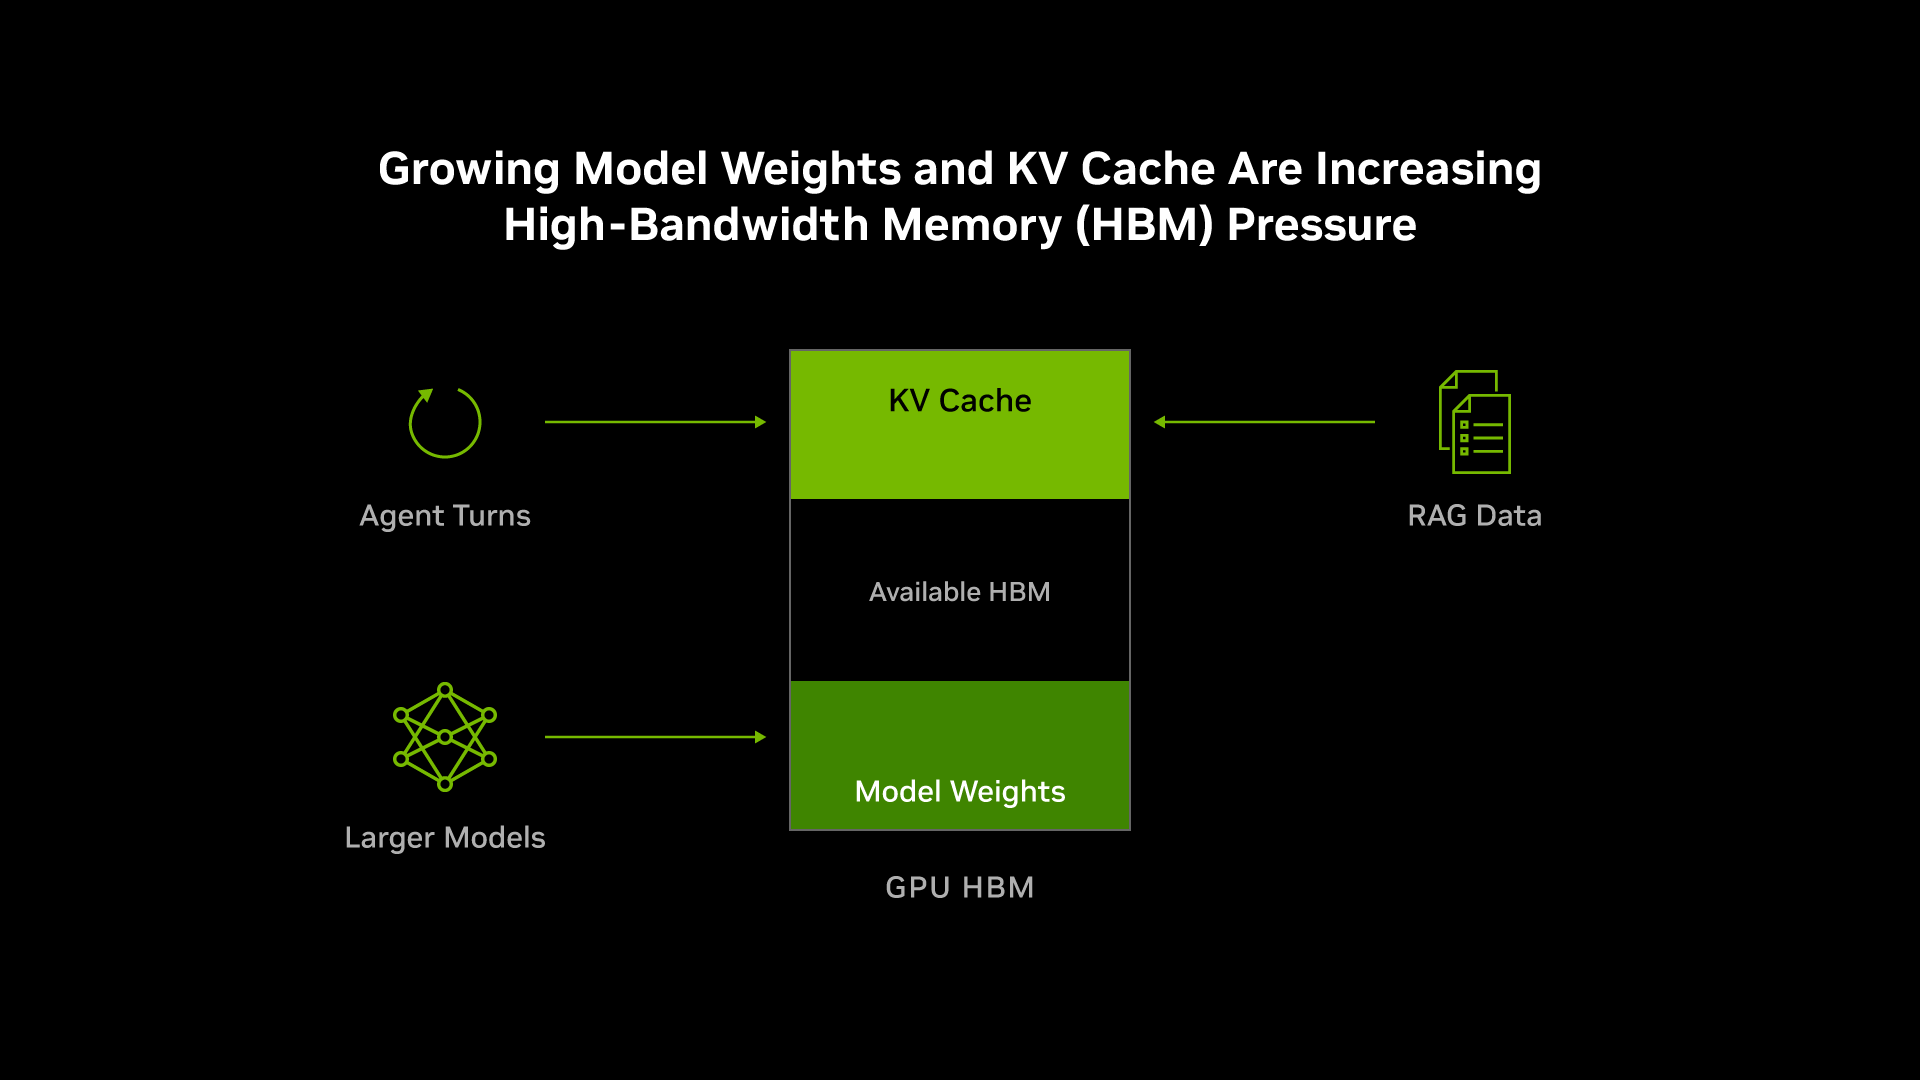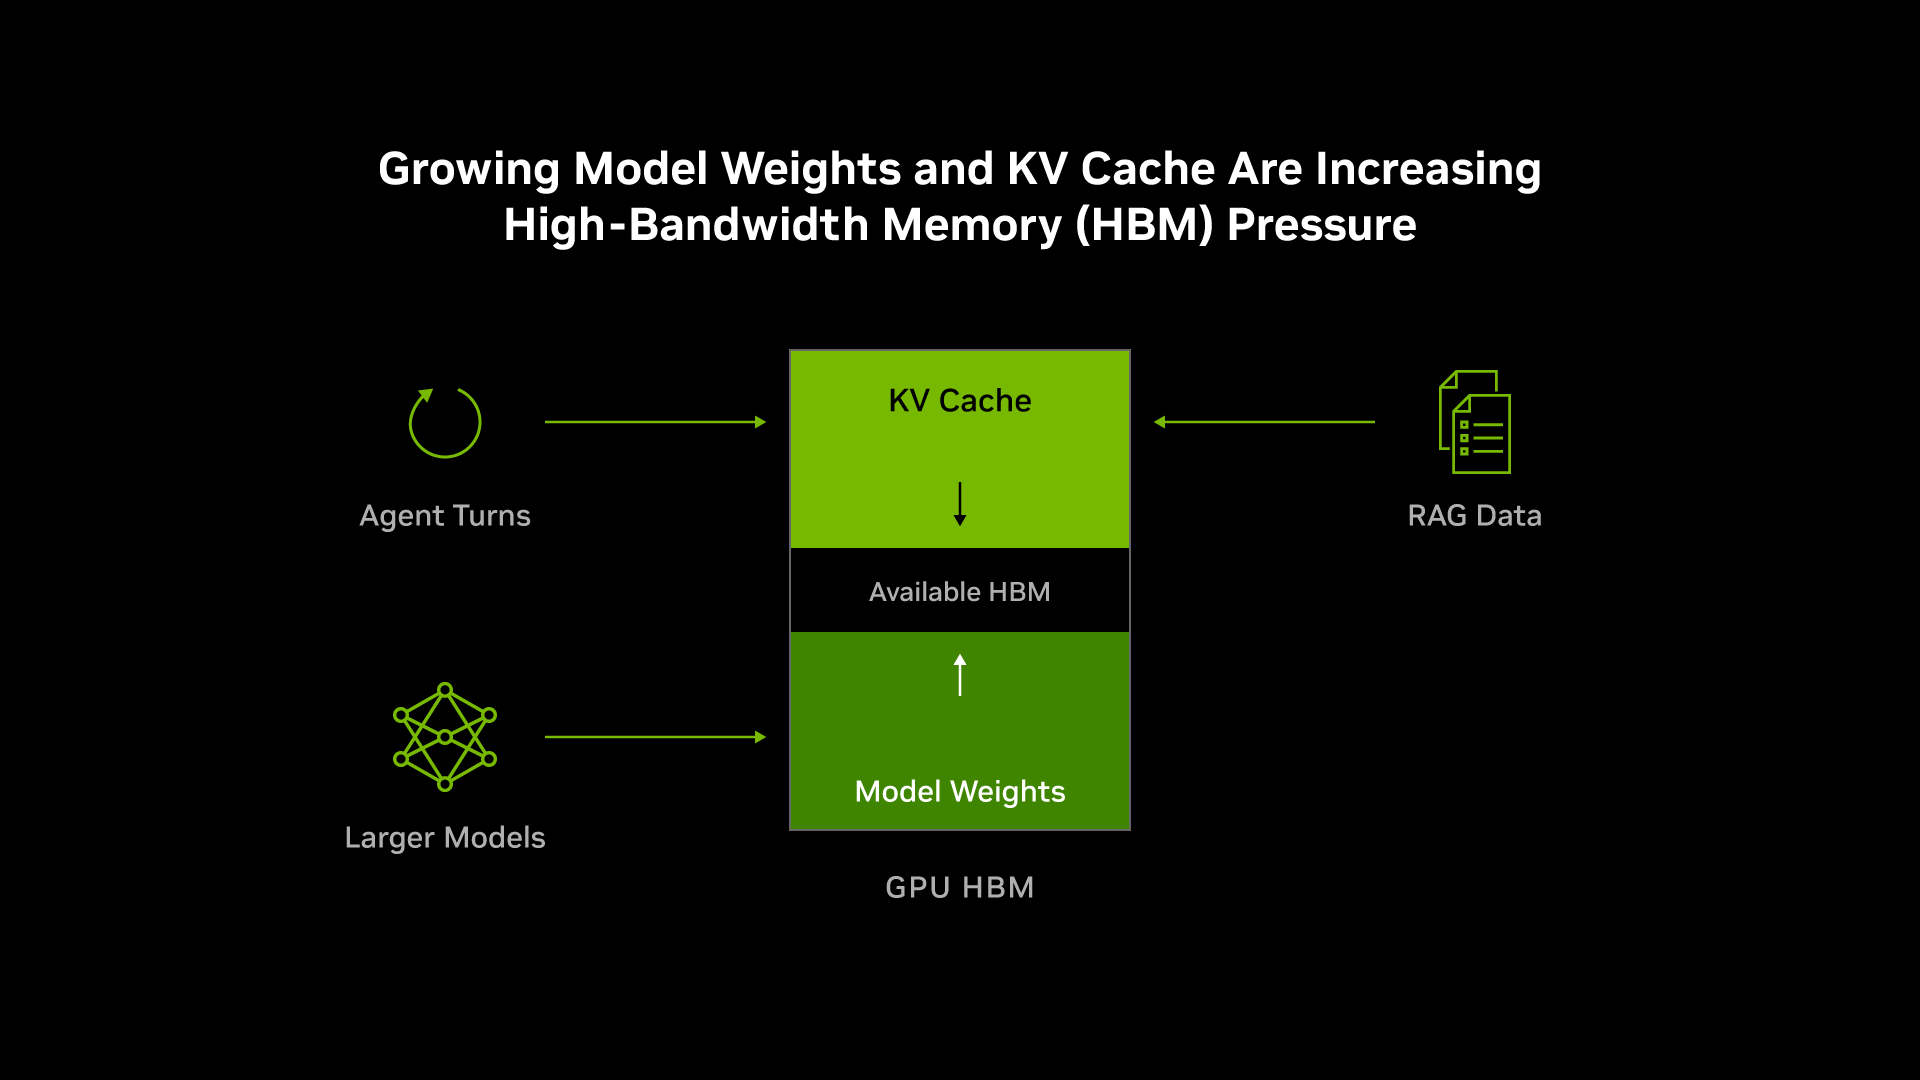
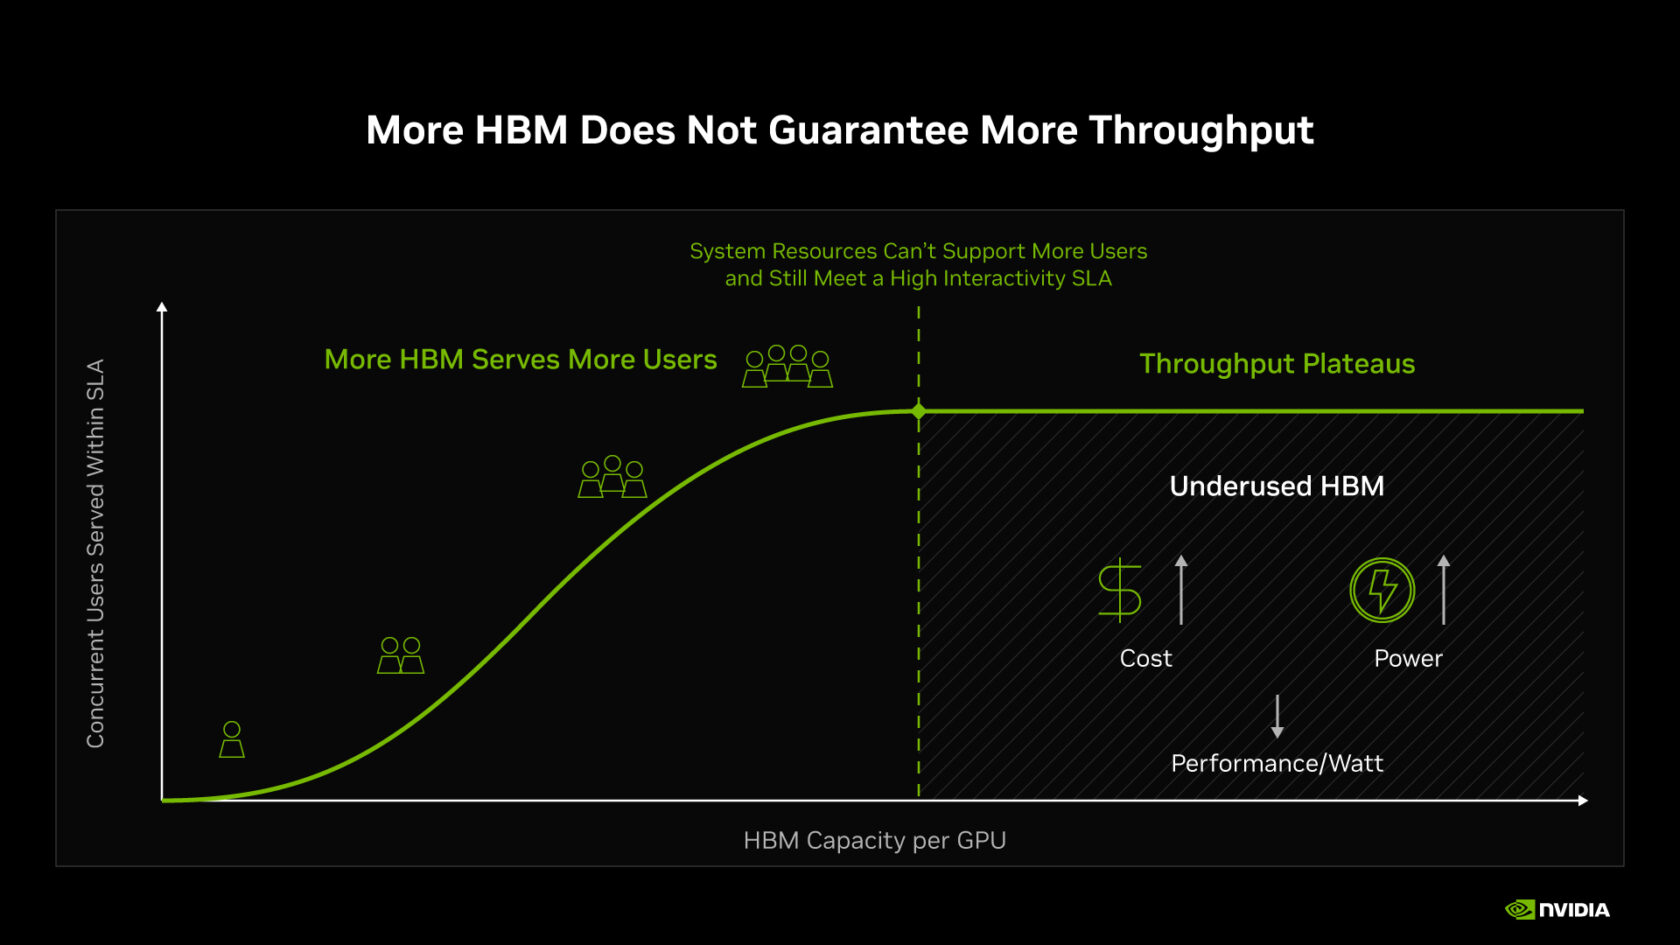
Kā mākslīgā intelekta (MI) modeļi kļūst sarežģītāki — ar triljoniem parametru, garākiem konteksta logiem un vairāk autonomām inferenču uzdevumu veikšanai — pieaug pieprasījums pēc ātras joslas atmiņas (HBM) GPU. NVIDIA norāda, ka šī pieaugošā slodze saskaras ar ierobežotu atmiņas pieejamību un augošām izmaksām, kas, kā prognozē, tuvākajā laikā saglabāsies aktuāls izaicinājums.
Tā vietā, lai vienkārši palielinātu HBM kapacitāti, kas ir ierobežota gan fiziski, gan izmaksu ziņā, NVIDIA fokusējas uz pilna steka kopprojektēšanu. Šī stratēģija ietver GPU aparatūras, CPU, tīklu, uzglabāšanas sistēmu un programmatūras vienotu izstrādi, lai maksimāli efektīvi izmantotu atmiņu visos līmeņos mākslīgā intelekta apstrādes procesā — tā dēvētajā MI rūpnīcā.
Šajās MI rūpnīcās pastāv atmiņas hierarhija: visātrākā un dārgākā ir GPU HBM, kas glabā modeļu svarus un atslēgas-vērtības (KV) kešu aktīvo kontekstu. Zemāk atrodas plaša, bet lēnāka CPU atmiņa, vietējie SSD un koplietojamā glabāšana — visi apmainot ātrumu pret apjomu un izmaksu efektivitāti. Mērķis ir samazināt datus, kas glabājas dārgākajā līmenī, pārvietot neaktīvos datus uz lētākiem slāņiem un ātri iepriekš ielādēt datus atpakaļ uz GPU, uzlabojot caurlaidību un samazinot latentumu.
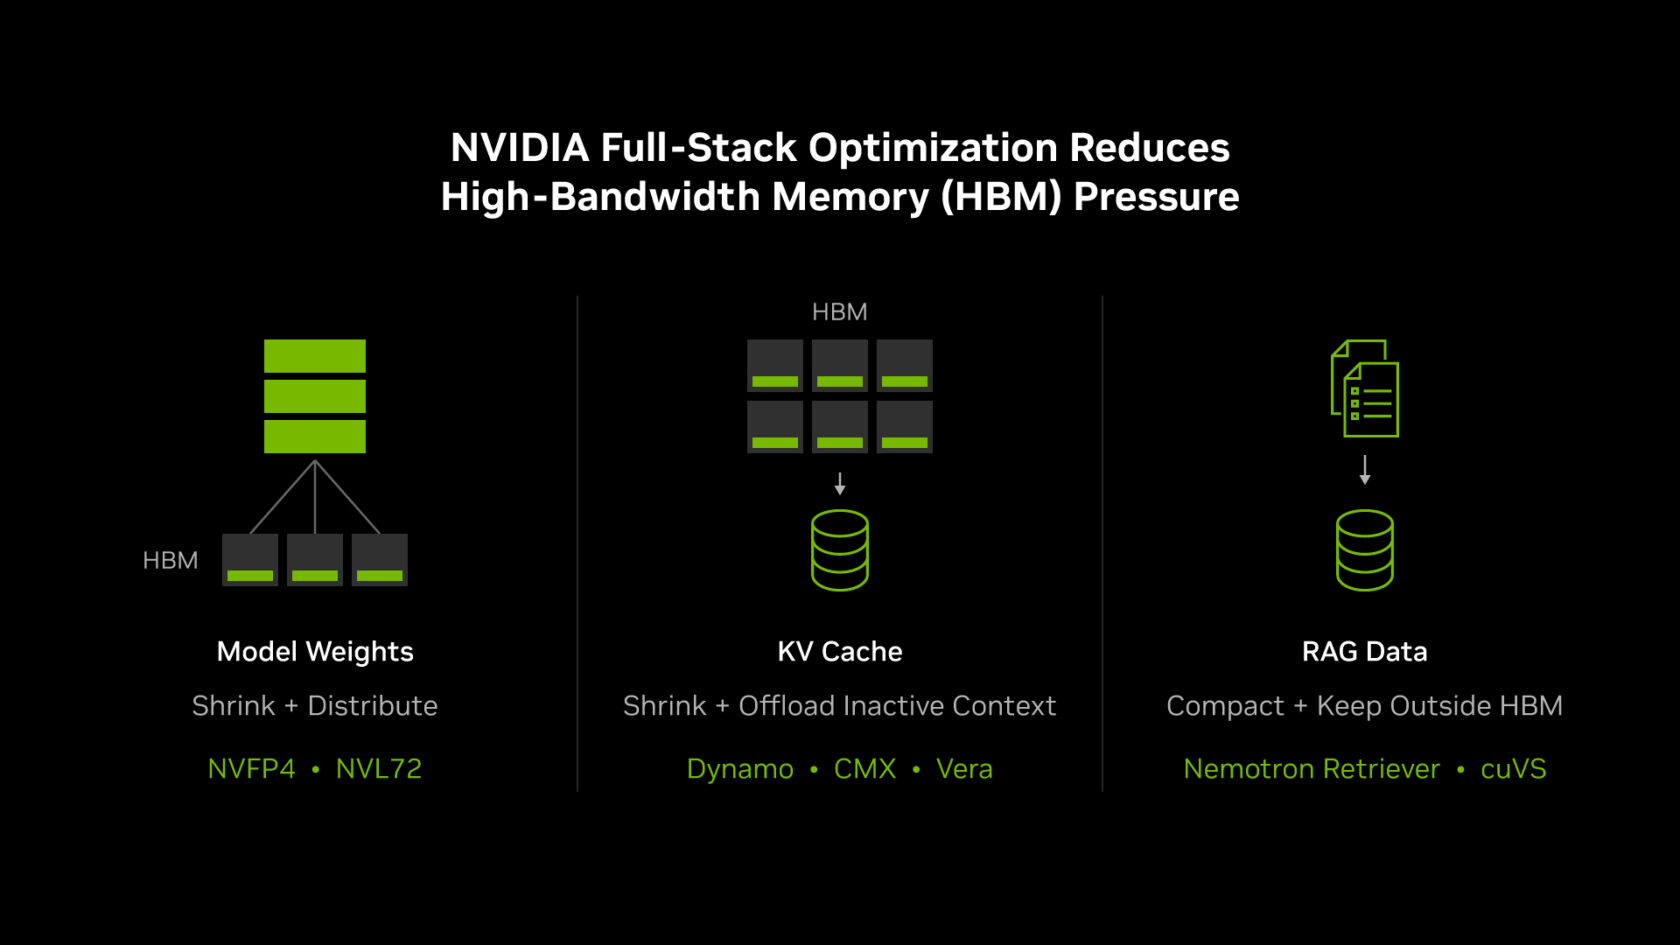
NVIDIA pieeja ietver vairākas inovācijas. Pirmkārt, 4 bitu peldošā komata formāta NVFP4 ieviešana palīdz samazināt modeļu svarus un KV kešus, samazinot atmiņas nospiedumu. Vēl vairāk — visa modeļa sadalīšana līdz pat 72 GPU NVL72 sistēmā atbrīvo HBM KV kešam un lietotāju konkurencei.
Otrkārt, neaktīvos KV keša kontekstus var pārvietot no dārgās HBM uz lielu CPU pieslēgtu atmiņu vai koplietojamās glabāšanas slāņiem, izmantojot jauno NVIDIA Dynamo inferenču programmatūru un CMX konteksta atmiņas risinājumus. Šī programmatūra pārvalda KV kešu starp GPU atmiņu, CPU atmiņu un krātuvi, lai ātri atkārtoti izmantotu datus bez nepieciešamības pastāvīgi turēt tos HBM.
Treškārt, izgūšanas pastiprinātas ģenerēšanas (RAG) paņēmieni samazina HBM slodzi, uzturot lielas uzņēmumu zināšanu bāzes ārpus GPU. Tā vietā NVIDIA Nemotron Retriever ģenerē kompaktus vektoru iemiesojumus, un cuVS bibliotēka pārvalda meklējamo indeksu starp CPU un glabāšanas slāņiem. Tikai attiecīgie fragmenti nonāk ātrajā GPU kontekstā.
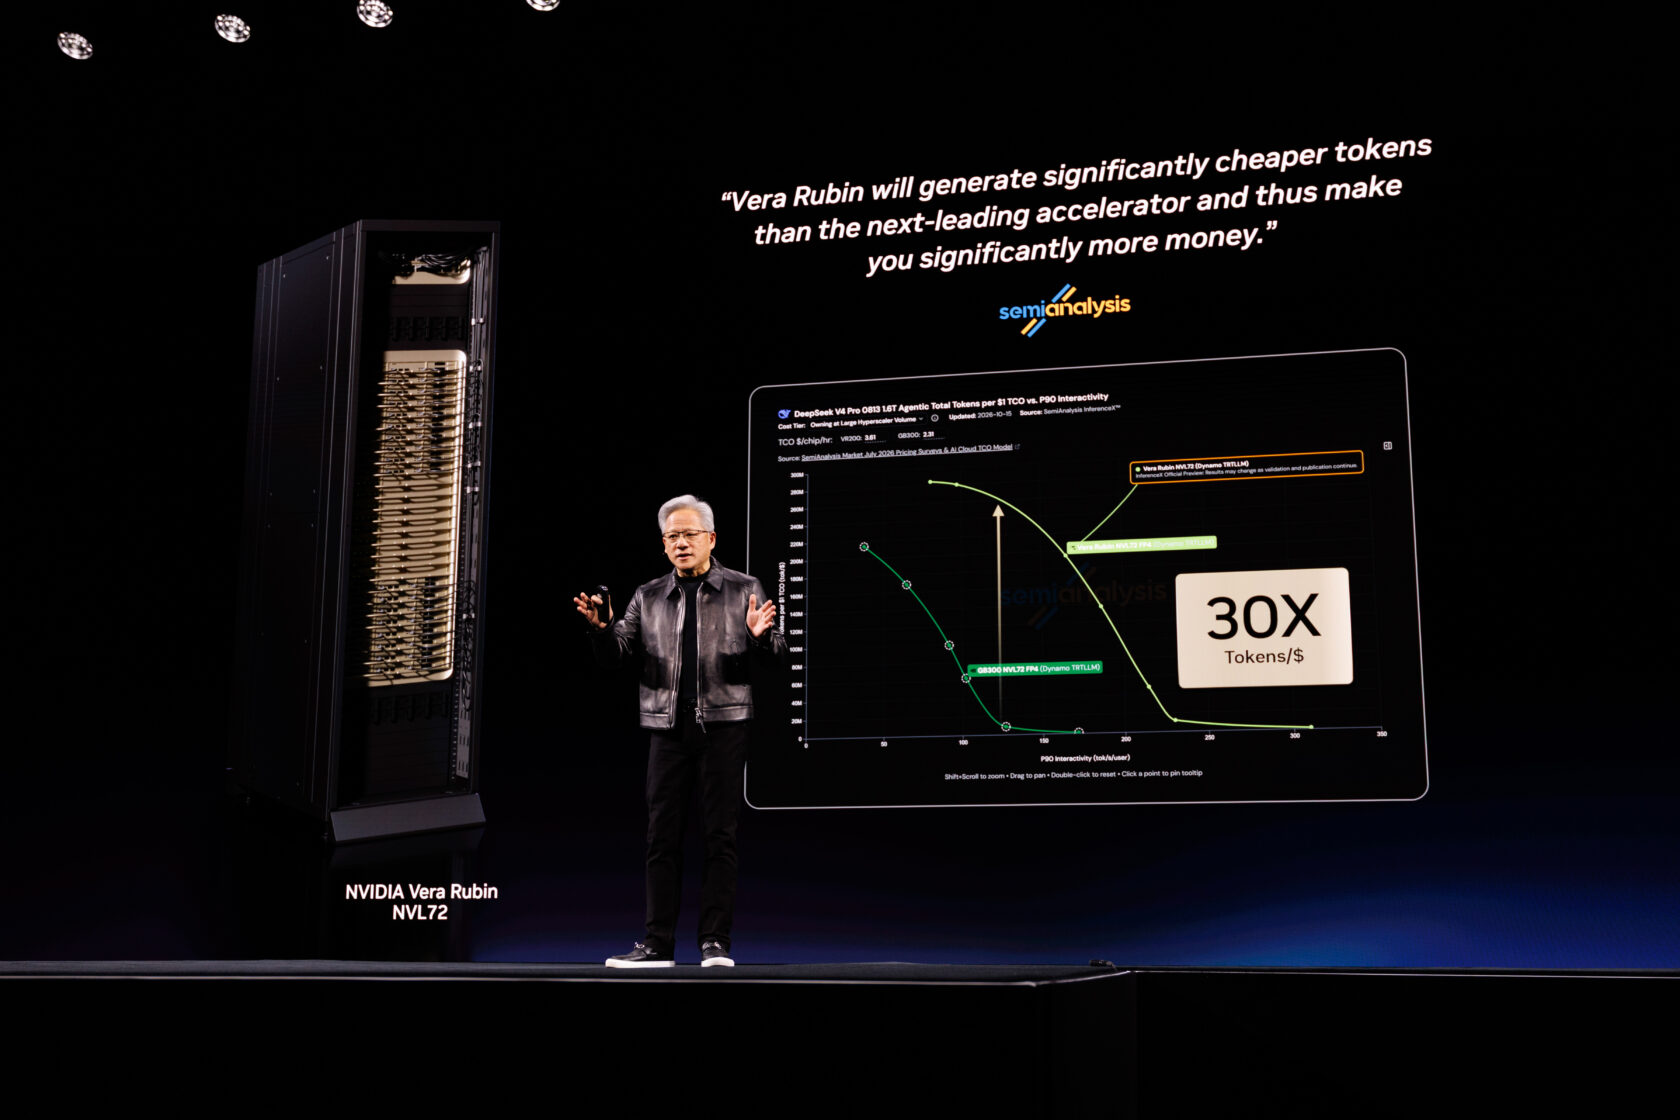
NVIDIA ziņo, ka šīs kombinētās optimizācijas palielinājušas HBM kapacitāti uz vienu GPU aptuveni par 3% no NVIDIA Blackwell Ultra līdz Vera Rubin platformai, taču izmēģinājuma darbslodzēs, piemēram, SemiAnalysis AgentX, palielinājušas autonomo caurlaidību uz dolāru līdz pat 30 reizēm.
Risinot atmiņas joslas platuma ierobežojumus — tā saukto "atmiņas sienu" — NVIDIA pilna steka kopprojektēšana ļauj MI darbiem veikt vairāk noderīgu aprēķinu uz katru atmiņas baitu, samazinot enerģijas patēriņu un izmaksas. Šī holistiskā atmiņas pārvaldības stratēģija iezīmē pāreju no tīras atmiņas kapacitātes meklējumiem uz efektivitātes organizēšanu aparatūras un programmatūras līmeņos, reaģējot uz mākslīgā intelekta pieaugošajām prasībām.
Sīkākiem tehniskiem ieskatiem NVIDIA piedāvā video skaidrojumu un dziļu analīzi par to, kā pilna steka kopprojektēšana samazina inferenču atmiņas spiedienu un uzlabo MI platformas ekonomiku.
Avoti un oriģinālziņas
Lasīt oriģinālo avotu ↗
Komentāri (0)
Komentāru vēl nav. Sāciet diskusiju.
Rakstīt komentāru
Komentāri tiek publicēti pēc moderēšanas. Jūsu vārds un komentārs būs redzami publiski. Konts