
NVIDIA zwiększa efektywność pamięci AI dzięki pełnej współprojektacji stosu
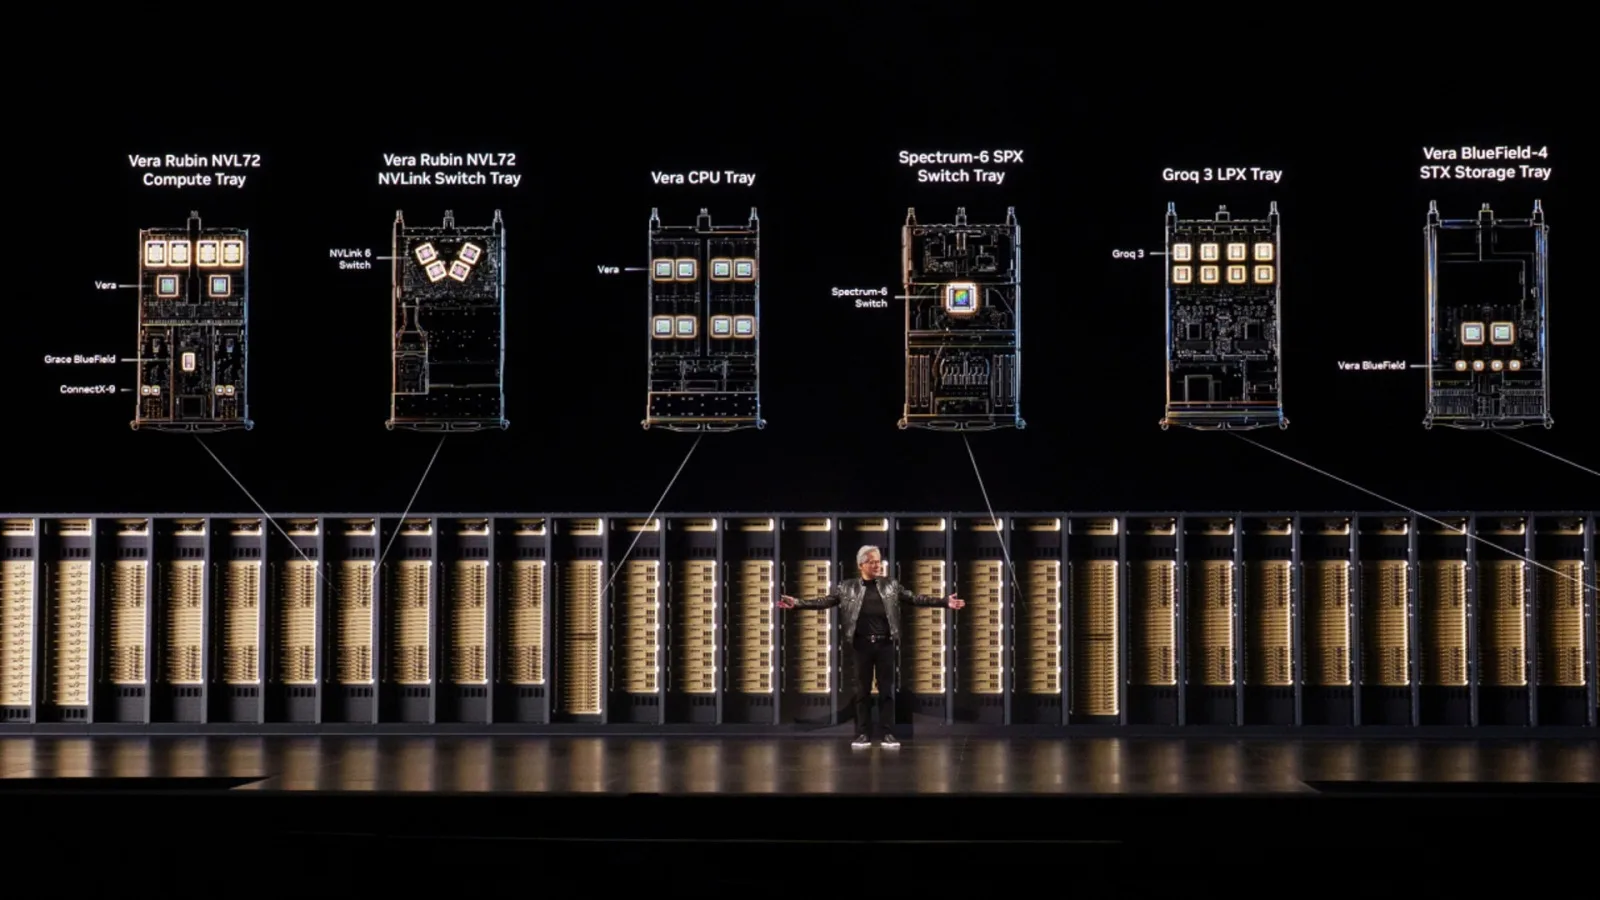
Image: NVIDIA · Source
NVIDIA odpowiada na rosnące wymagania dotyczące pamięci GPU w AI poprzez pełną współprojektację stosu, optymalizując wykorzystanie pamięci na poziomie sprzętu i oprogramowania, aby zwiększyć przepustowość i efektywność mimo ograniczonej pojemności pamięci o dużej przepustowości.
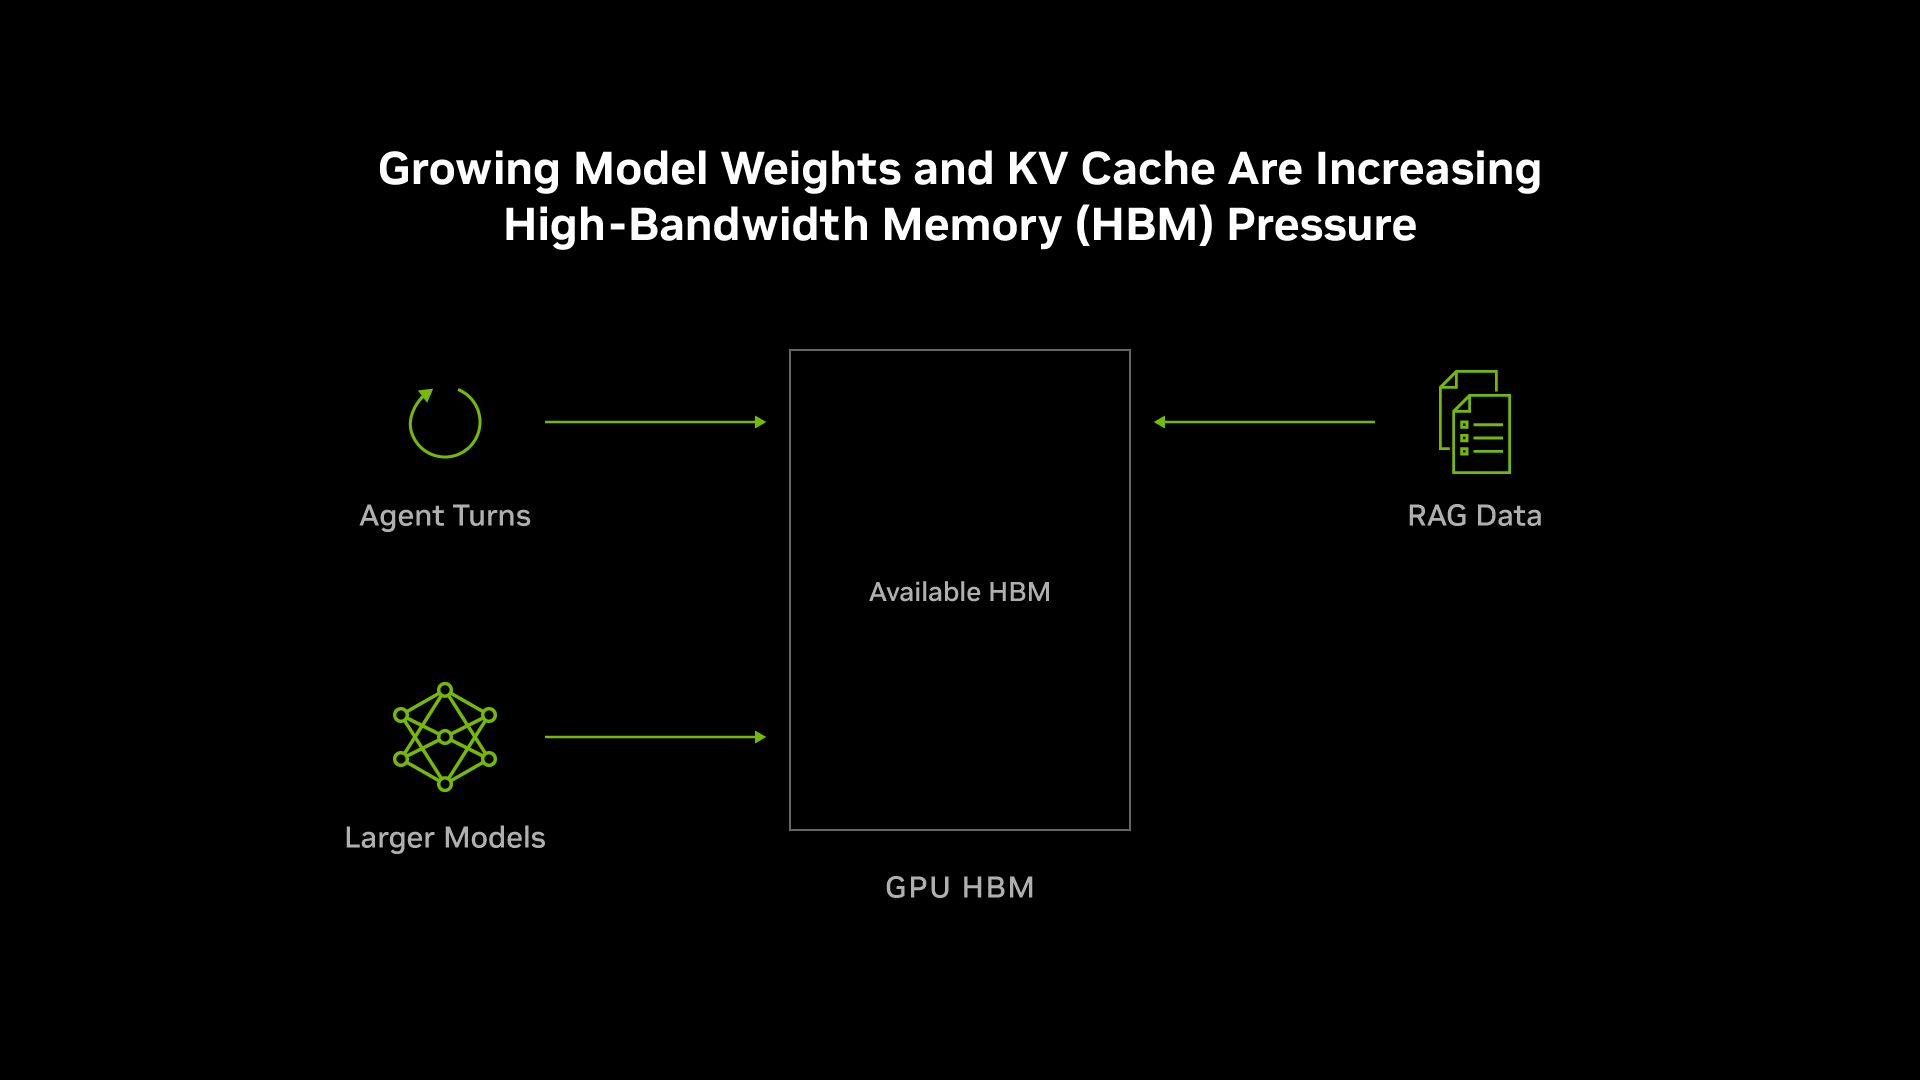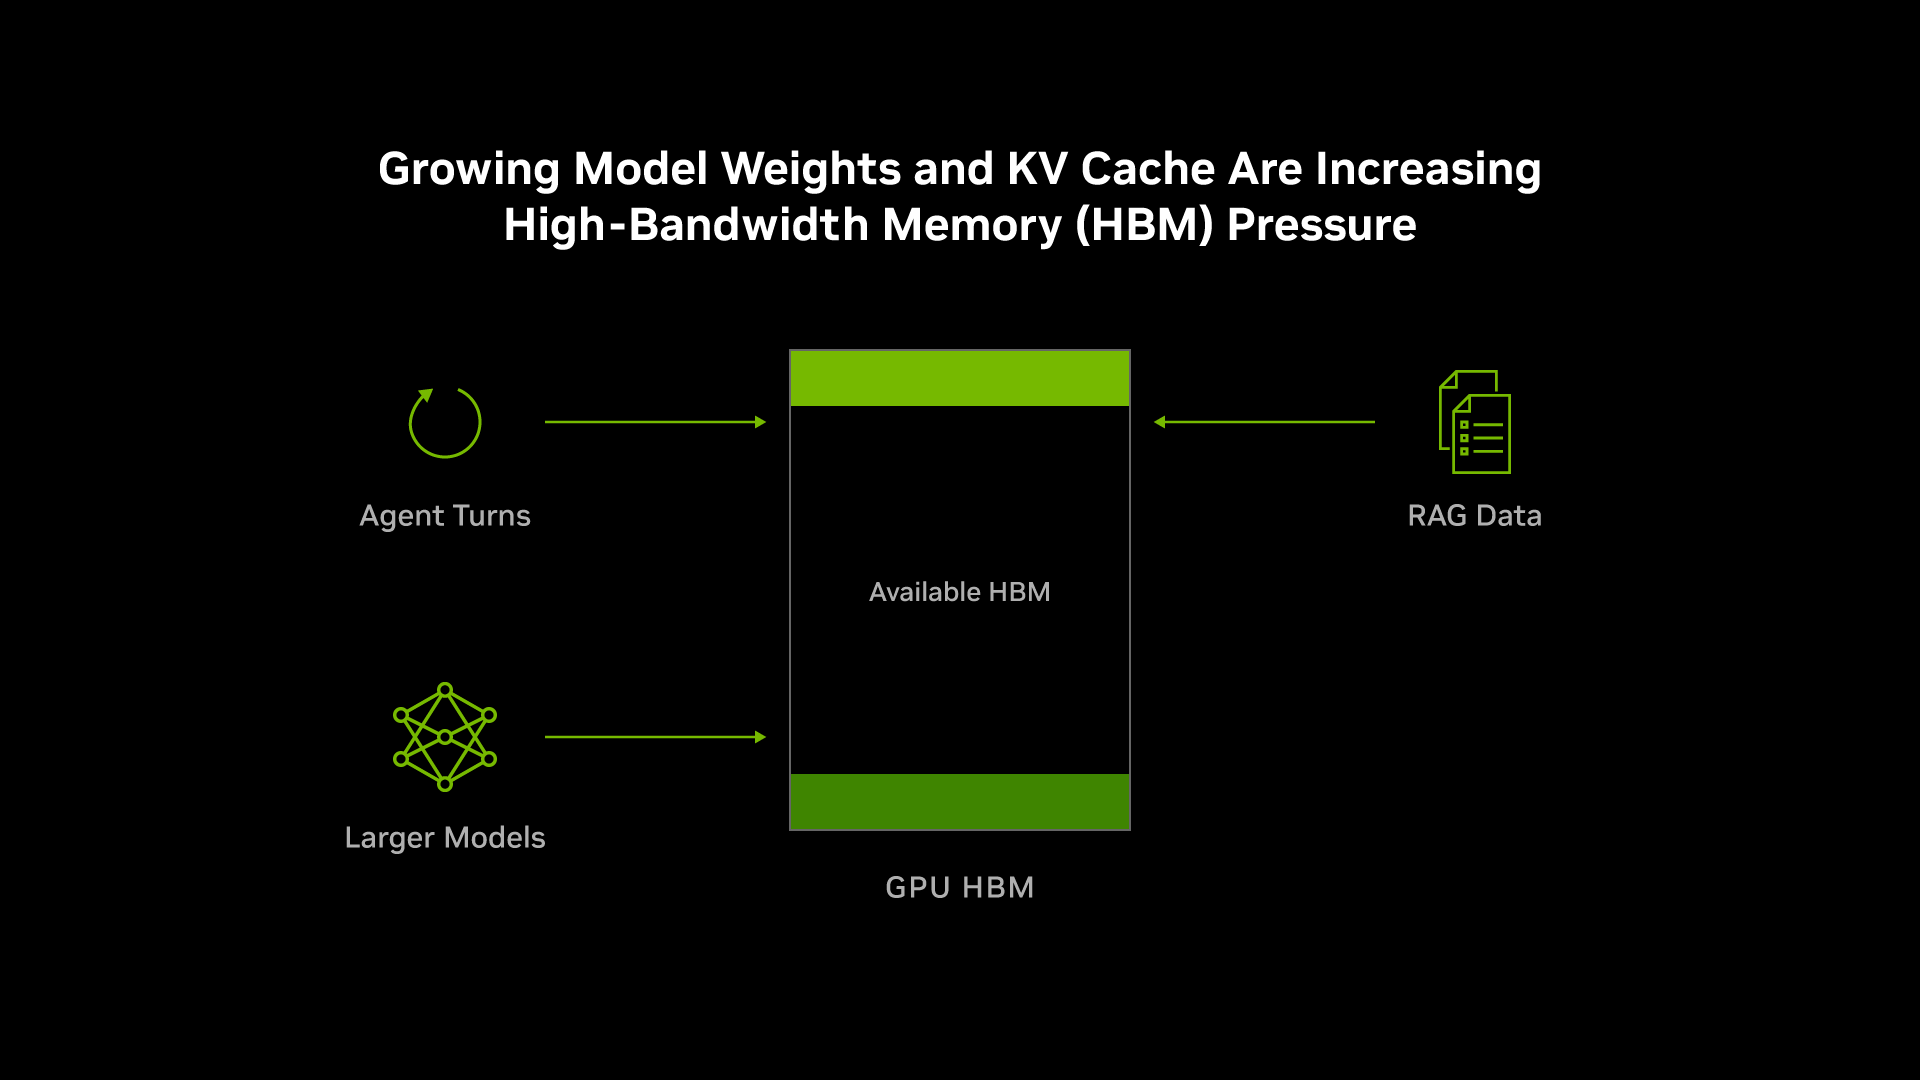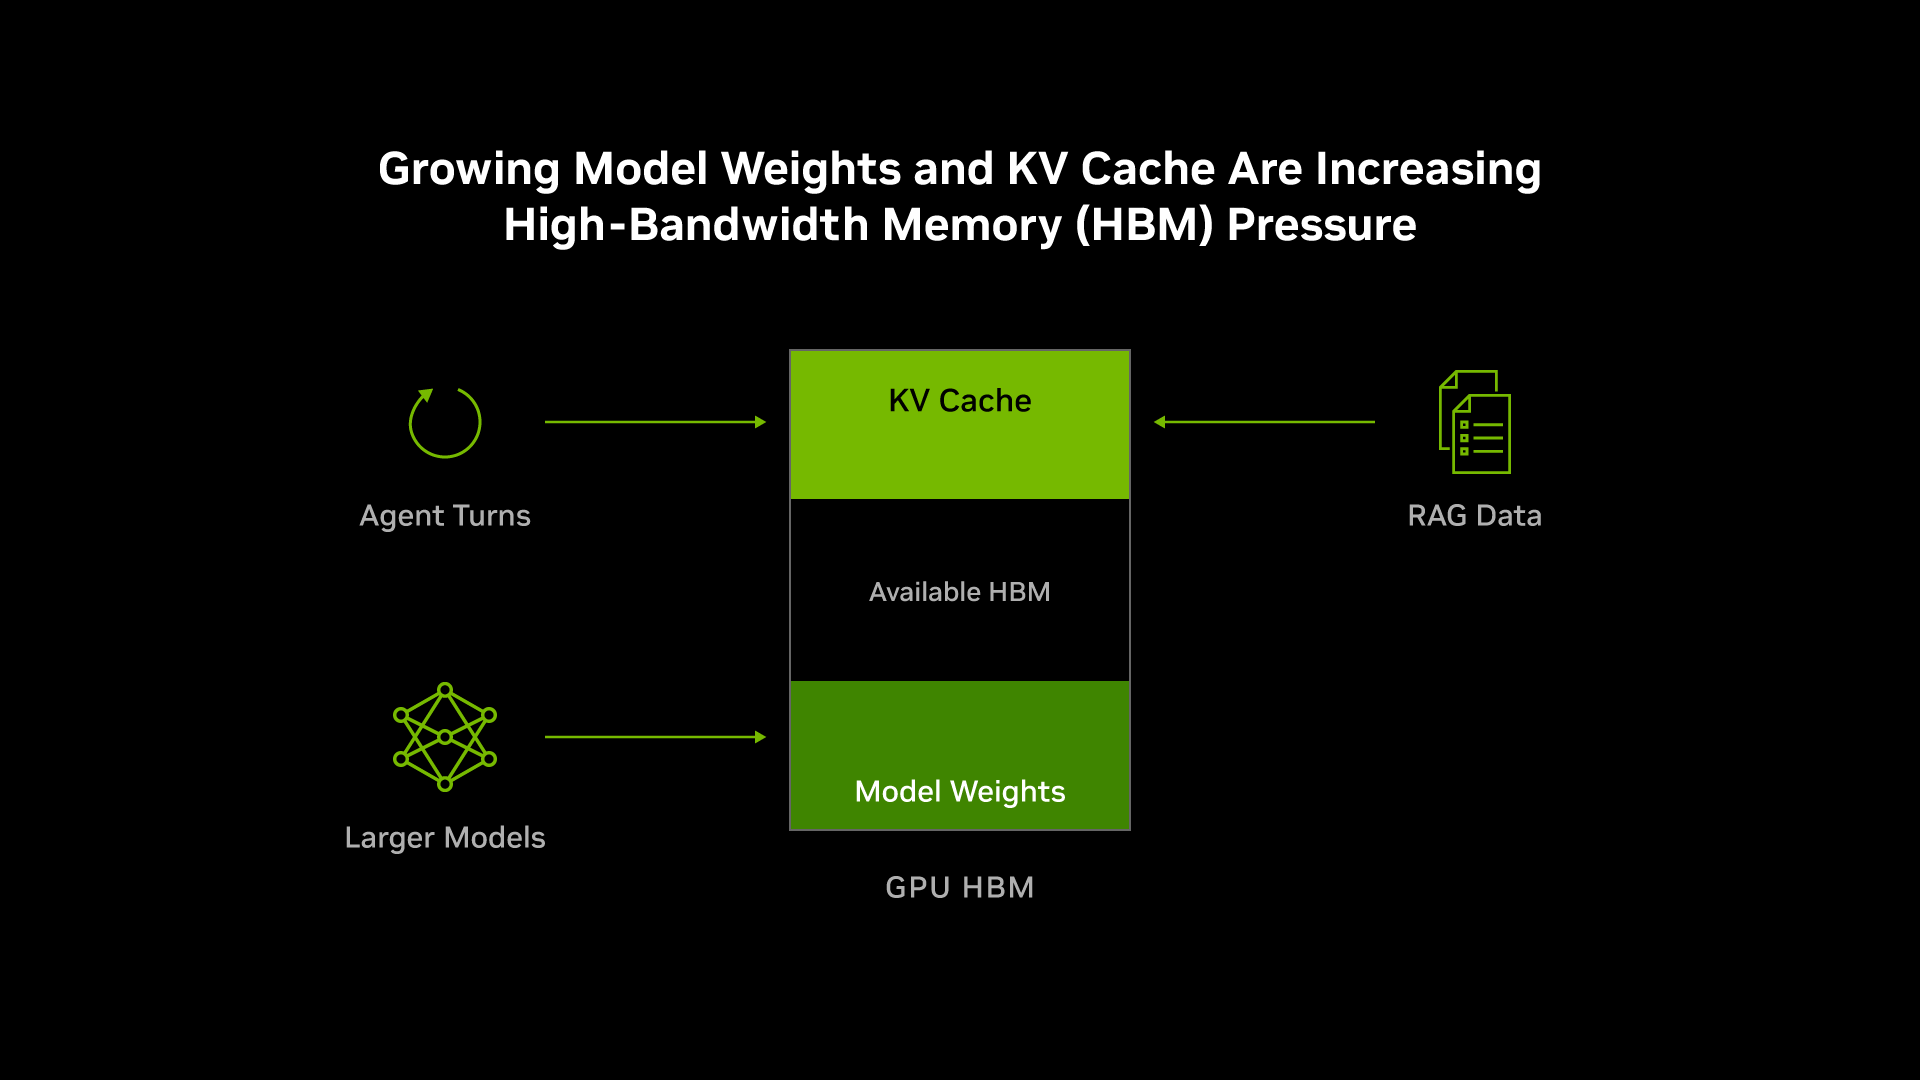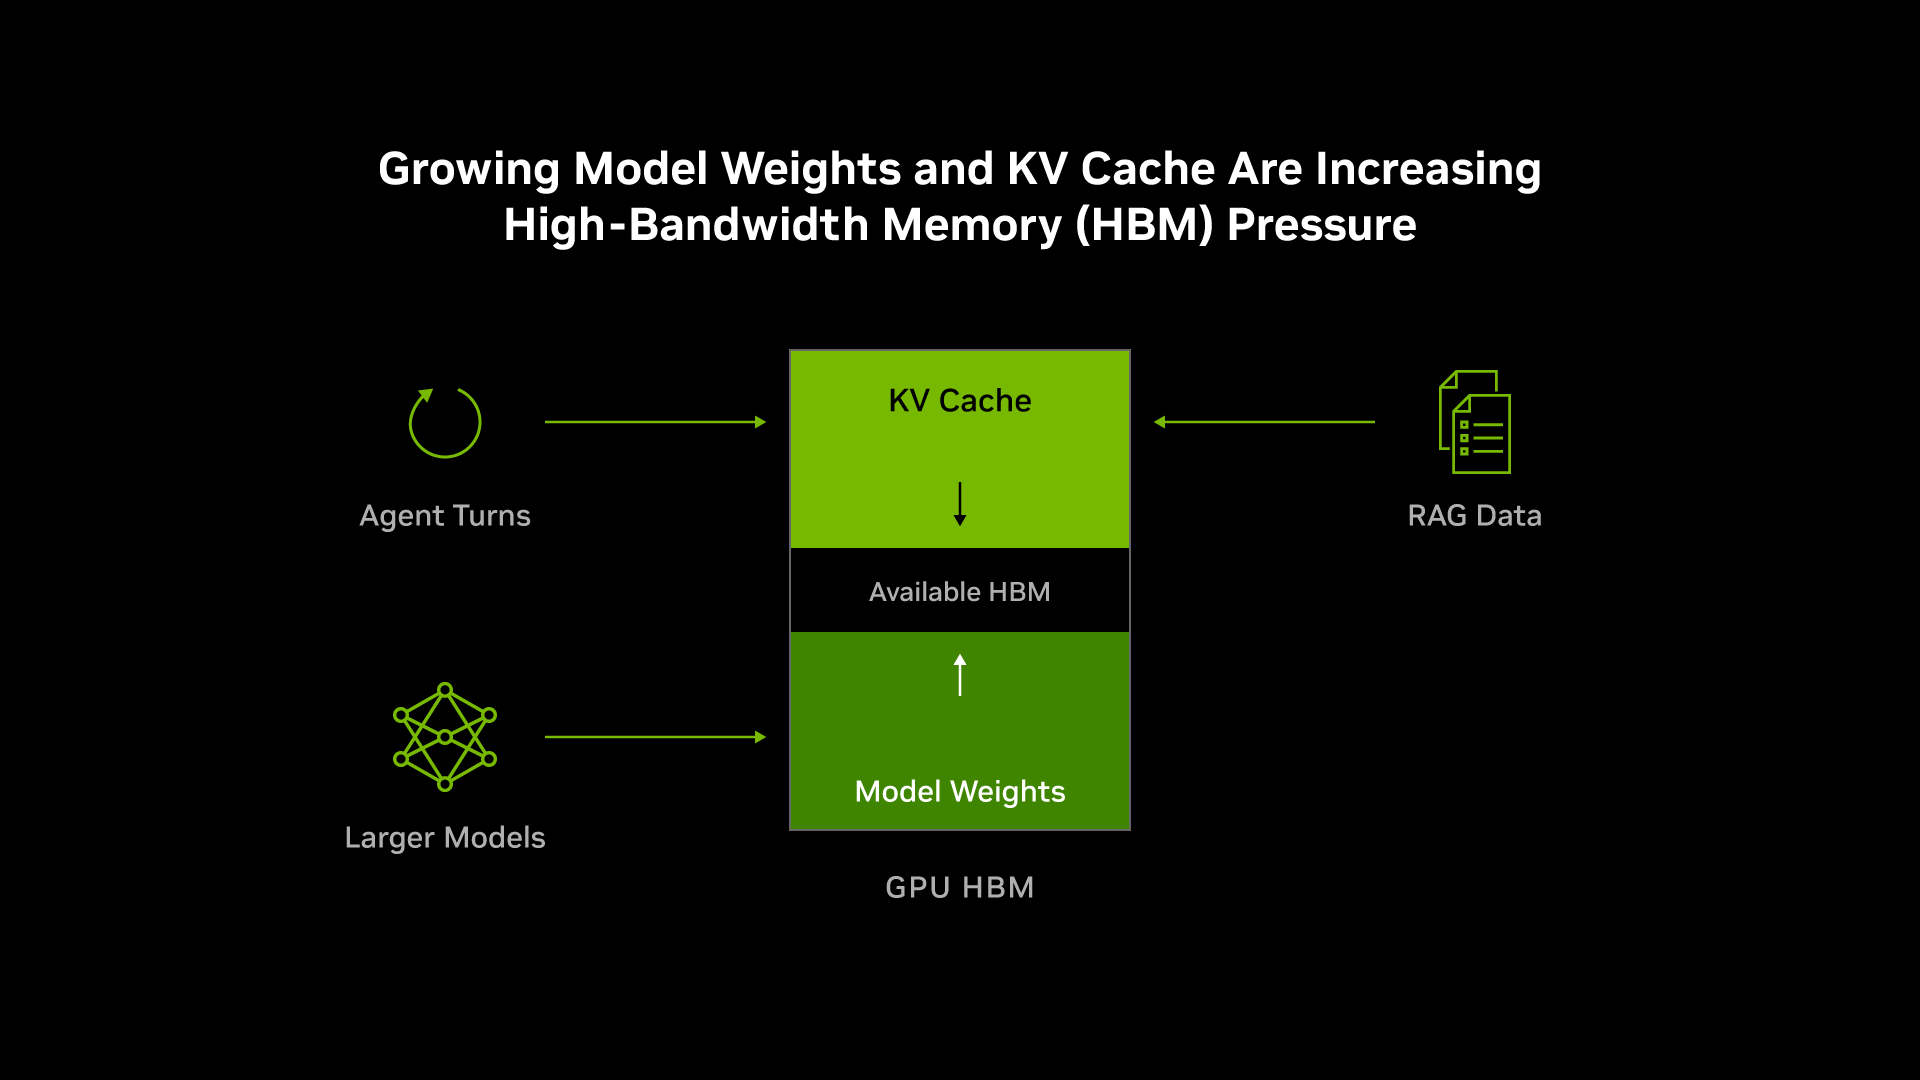
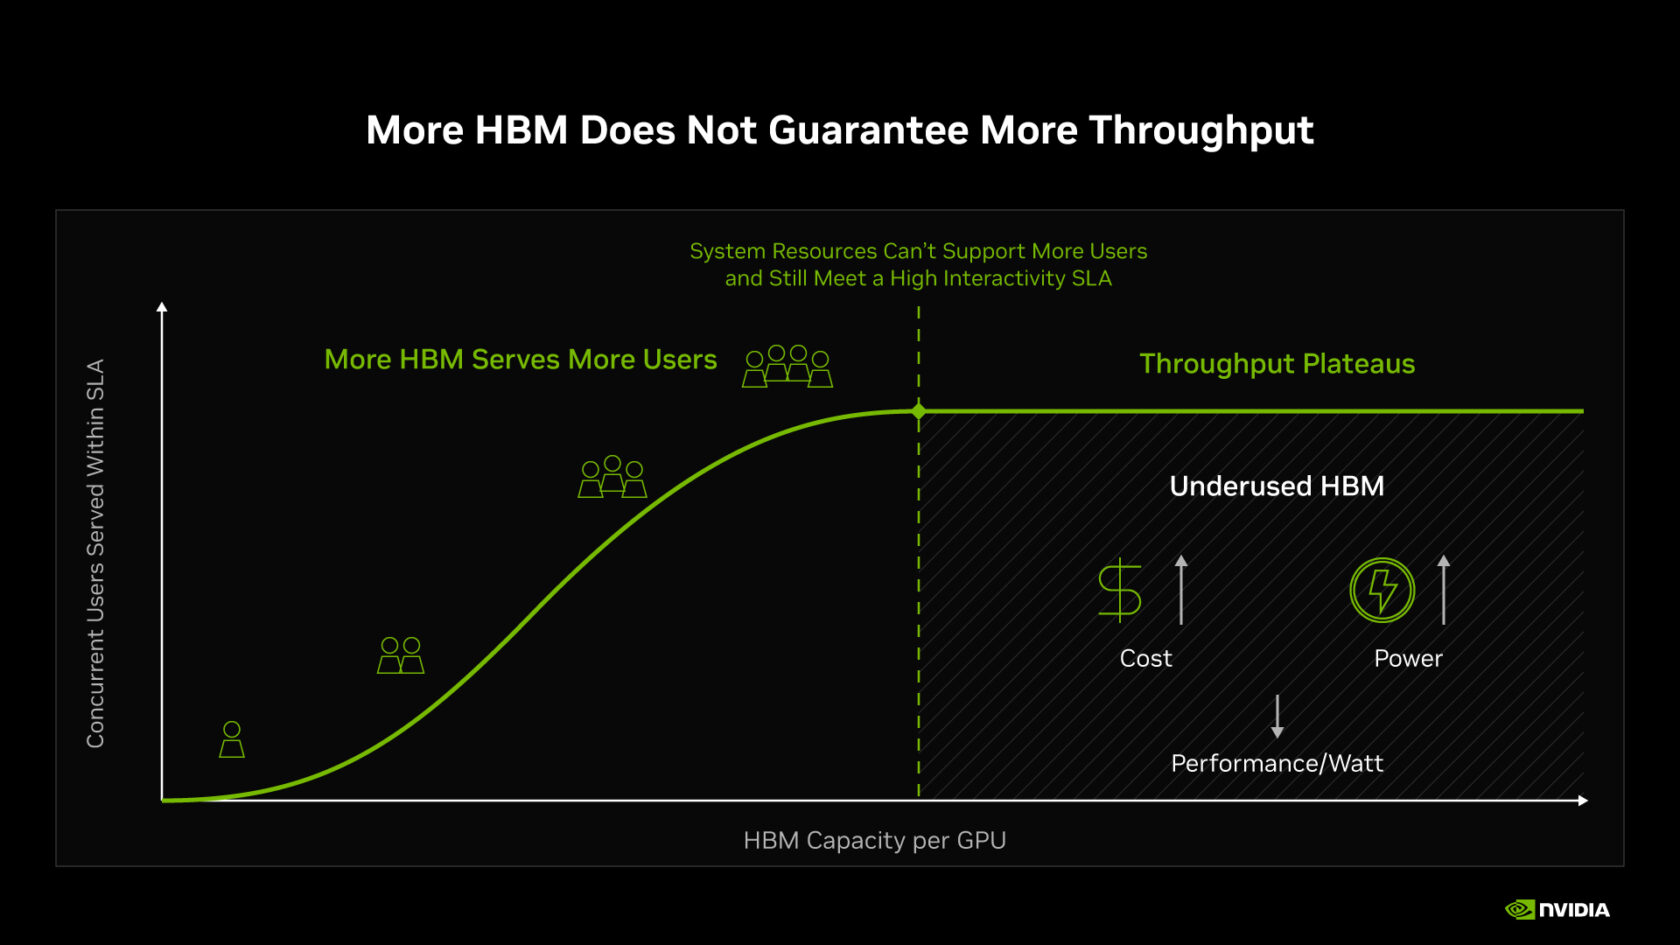
W miarę jak modele AI stają się coraz bardziej złożone — z bilionami parametrów, dłuższymi oknami kontekstowymi oraz bardziej złożonymi zadaniami inferencyjnymi — rośnie zapotrzebowanie na pamięć o wysokiej przepustowości (HBM) na GPU. NVIDIA podkreśla, że to narastające zapotrzebowanie koliduje z ograniczoną podażą pamięci oraz rosnącymi cenami, co jest wyzwaniem przewidywanym na najbliższy okres.
Zamiast jedynie zwiększać pojemność HBM, co napotyka na fizyczne i kosztowe ograniczenia, NVIDIA koncentruje się na pełnej współprojektacji stosu. Strategia ta polega na inżynierii sprzętu GPU, procesorów CPU, sieci, systemów magazynowania oraz oprogramowania w spójny sposób, aby maksymalizować efektywne wykorzystanie pamięci na wszystkich poziomach w ramach potoku przetwarzania AI — zwanego fabryką AI.
W tych fabrykach AI istnieje hierarchia pamięci: najszybsza i najdroższa warstwa to pamięć HBM GPU, która przechowuje wagi modeli oraz pamięć podręczną klucz-wartość (KV) aktywnego kontekstu. Poniżej znajdują się duże, lecz wolniejsze pamięci CPU, lokalne dyski SSD oraz wspólna pamięć masowa — wszystkie oferujące kompromis między prędkością, pojemnością i kosztami. Celem jest zmniejszenie ilości danych przechowywanych w najdroższej warstwie, przeniesienie nieaktywnych danych do tańszych poziomów oraz szybkie pobieranie danych z powrotem do GPU, co poprawia przepustowość i redukuje opóźnienia.
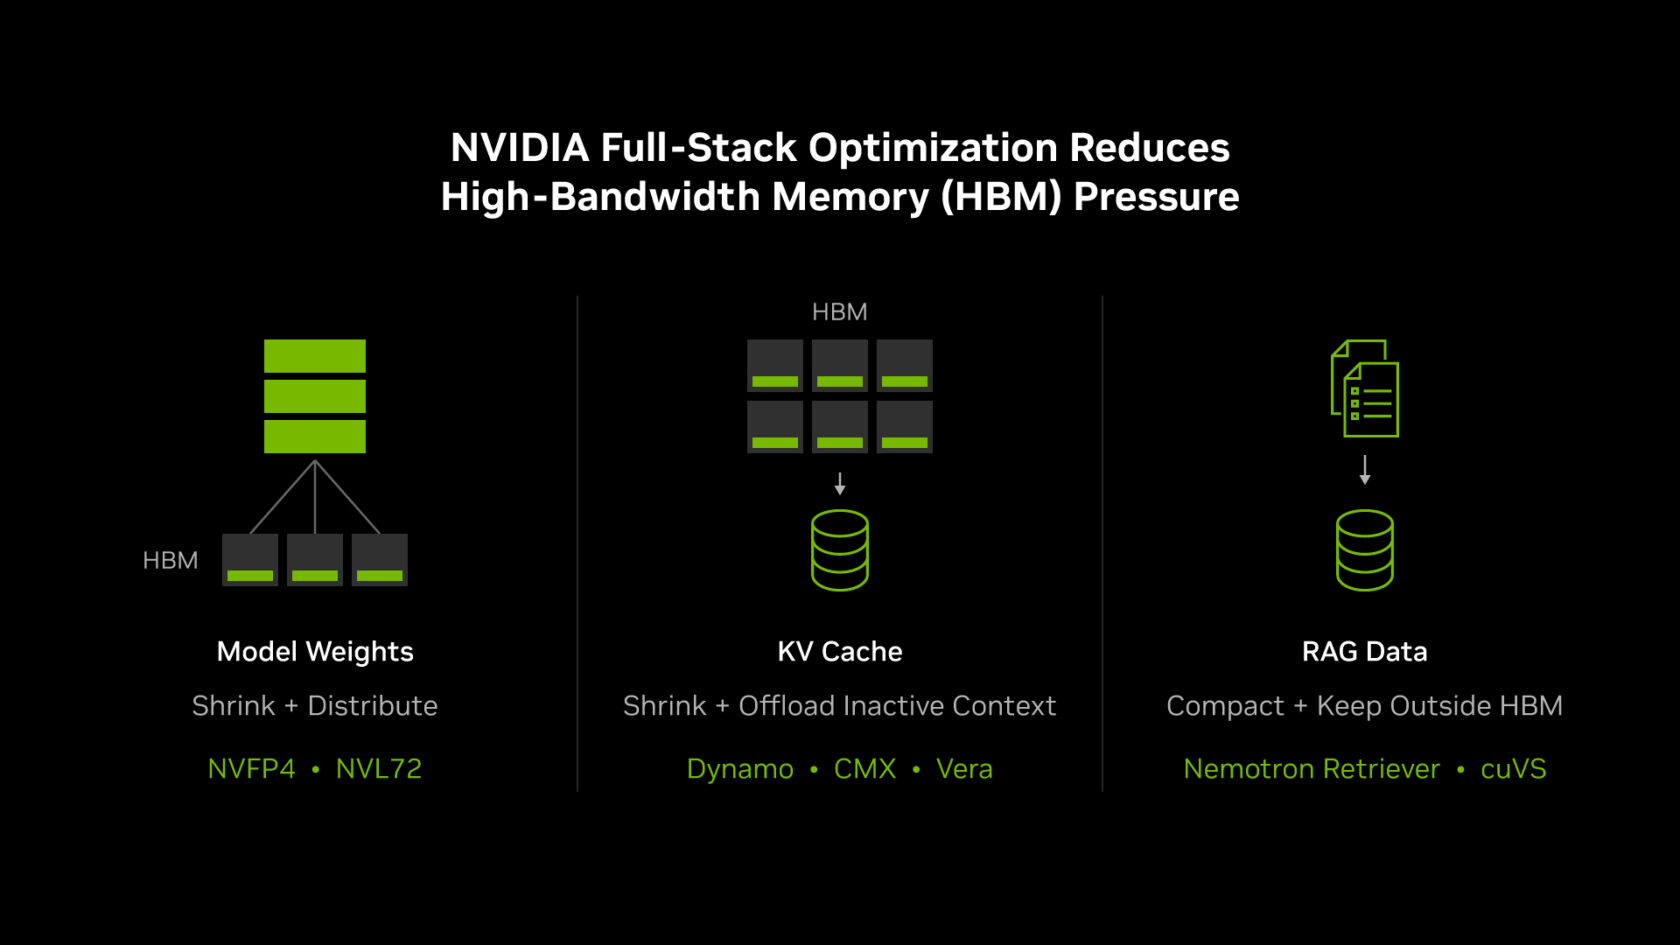
Podejście NVIDIA obejmuje kilka innowacji. Po pierwsze, zastosowanie 4-bitowego formatu zmiennoprzecinkowego o nazwie NVFP4 pomaga zmniejszyć wagi modelu i pamięć podręczną KV, ograniczając ślad pamięciowy. Dystrybucja całego modelu na nawet 72 GPU w systemie NVL72 dodatkowo uwalnia HBM dla pamięci KV oraz współbieżności użytkowników.
Po drugie, nieaktywna pamięć podręczna KV może być wyprowadzana z kosztownej HBM do dużej pamięci połączonej z CPU lub do wspólnej pamięci masowej z użyciem nowego oprogramowania NVIDIA Dynamo do inferencji oraz rozwiązań CMX dla pamięci kontekstowej. Oprogramowanie to zarządza pamięcią KV w GPU, CPU i warstwach magazynowania, umożliwiając szybkie ponowne użycie bez konieczności ciągłego utrzymywania całych danych w HBM.
Po trzecie, techniki generowania wspomaganego wyszukiwaniem (retrieval-augmented generation, RAG) zmniejszają obciążenie HBM, przechowując rozległe bazy wiedzy przedsiębiorstwa poza GPU. Zamiast tego, Nemotron Retriever firmy NVIDIA generuje kompaktowe osadzenia wektorowe, a biblioteka cuVS zarządza indeksami przeszukiwalnymi na procesorach CPU i w warstwach pamięci masowej. Tylko istotne fragmenty trafiają do wysokoprędkościowego kontekstu GPU.
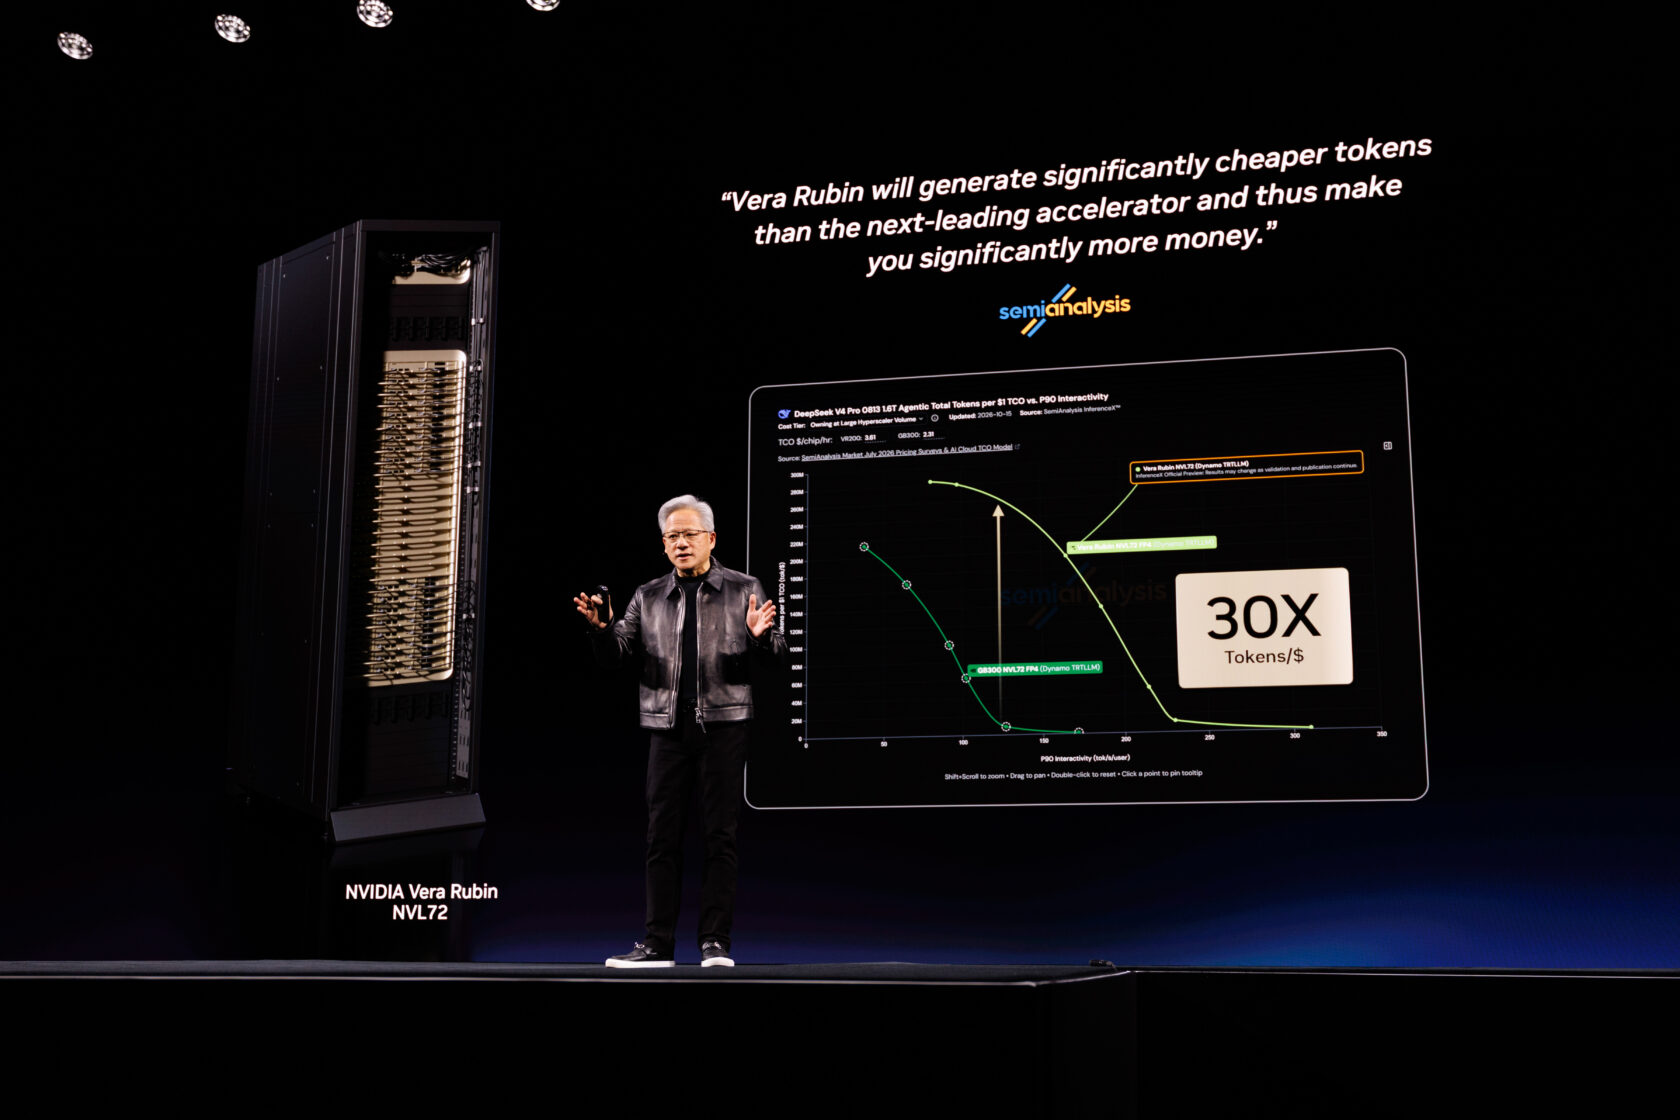
NVIDIA donosi, że te połączone optymalizacje skutkowały około 3% wzrostem pojemności HBM na GPU od NVIDIA Blackwell Ultra do platformy Vera Rubin, ale przyniosły nawet 30-krotnie wyższą przepustowość inferencyjną na dolar w testowych obciążeniach, takich jak SemiAnalysis AgentX.
Rozwiązując ograniczenia przepustowości pamięci — tzw. „ścianę pamięci” — pełna współprojektacja stosu NVIDIA pozwala obciążeniom AI na wykonywanie większej liczby użytecznych operacji na bajt pamięci, zmniejszając zużycie energii i koszty. Ta całościowa strategia zarządzania pamięcią oznacza odejście od dążenia wyłącznie do zwiększania surowej pojemności pamięci na rzecz harmonizacji efektywności pomiędzy warstwami sprzętu i oprogramowania, by sprostać rosnącym wymaganiom AI.
Dla szczegółowego wglądu technicznego NVIDIA udostępnia wyjaśniające wideo oraz szczegółową analizę, jak pełna współprojektacja stosu redukuje presję pamięci inferencyjnej i poprawia ekonomię platform AI.
Źródła i oryginalne doniesienia
Read the original source ↗
Komentarze (0)
Nie ma jeszcze komentarzy.
Napisz komentarz
Komentarze publikujemy po moderacji. Nazwa i komentarz będą publiczne. Konto