
NVIDIA pažengė AI atminties efektyvumo srityje su visa apimančiu kodų kūrimo požiūriu
Vaizdas: NVIDIA · Šaltinis
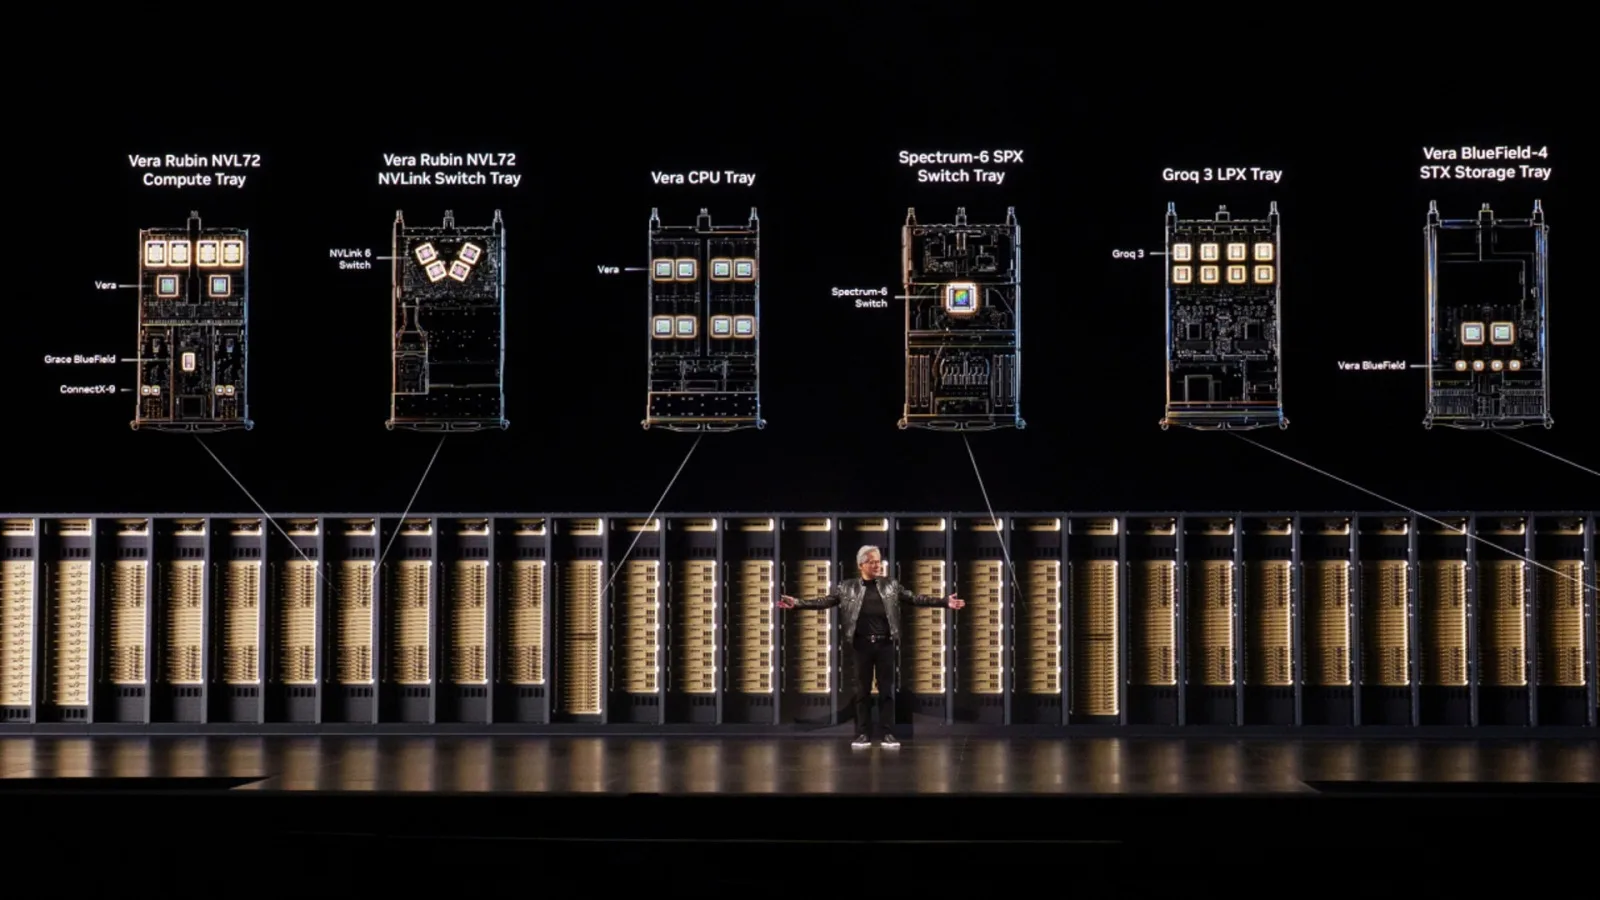
NVIDIA sprendžia augančius GPU atminties reikalavimus AI srityje per visos sistemos kodų kūrimą, optimizuodama atminties naudojimą tiek aparatūroje, tiek programinėje įrangoje, kad padidintų pralaidumą ir efektyvumą, nepaisant ribotos didelio pralaidumo atminties talpos.
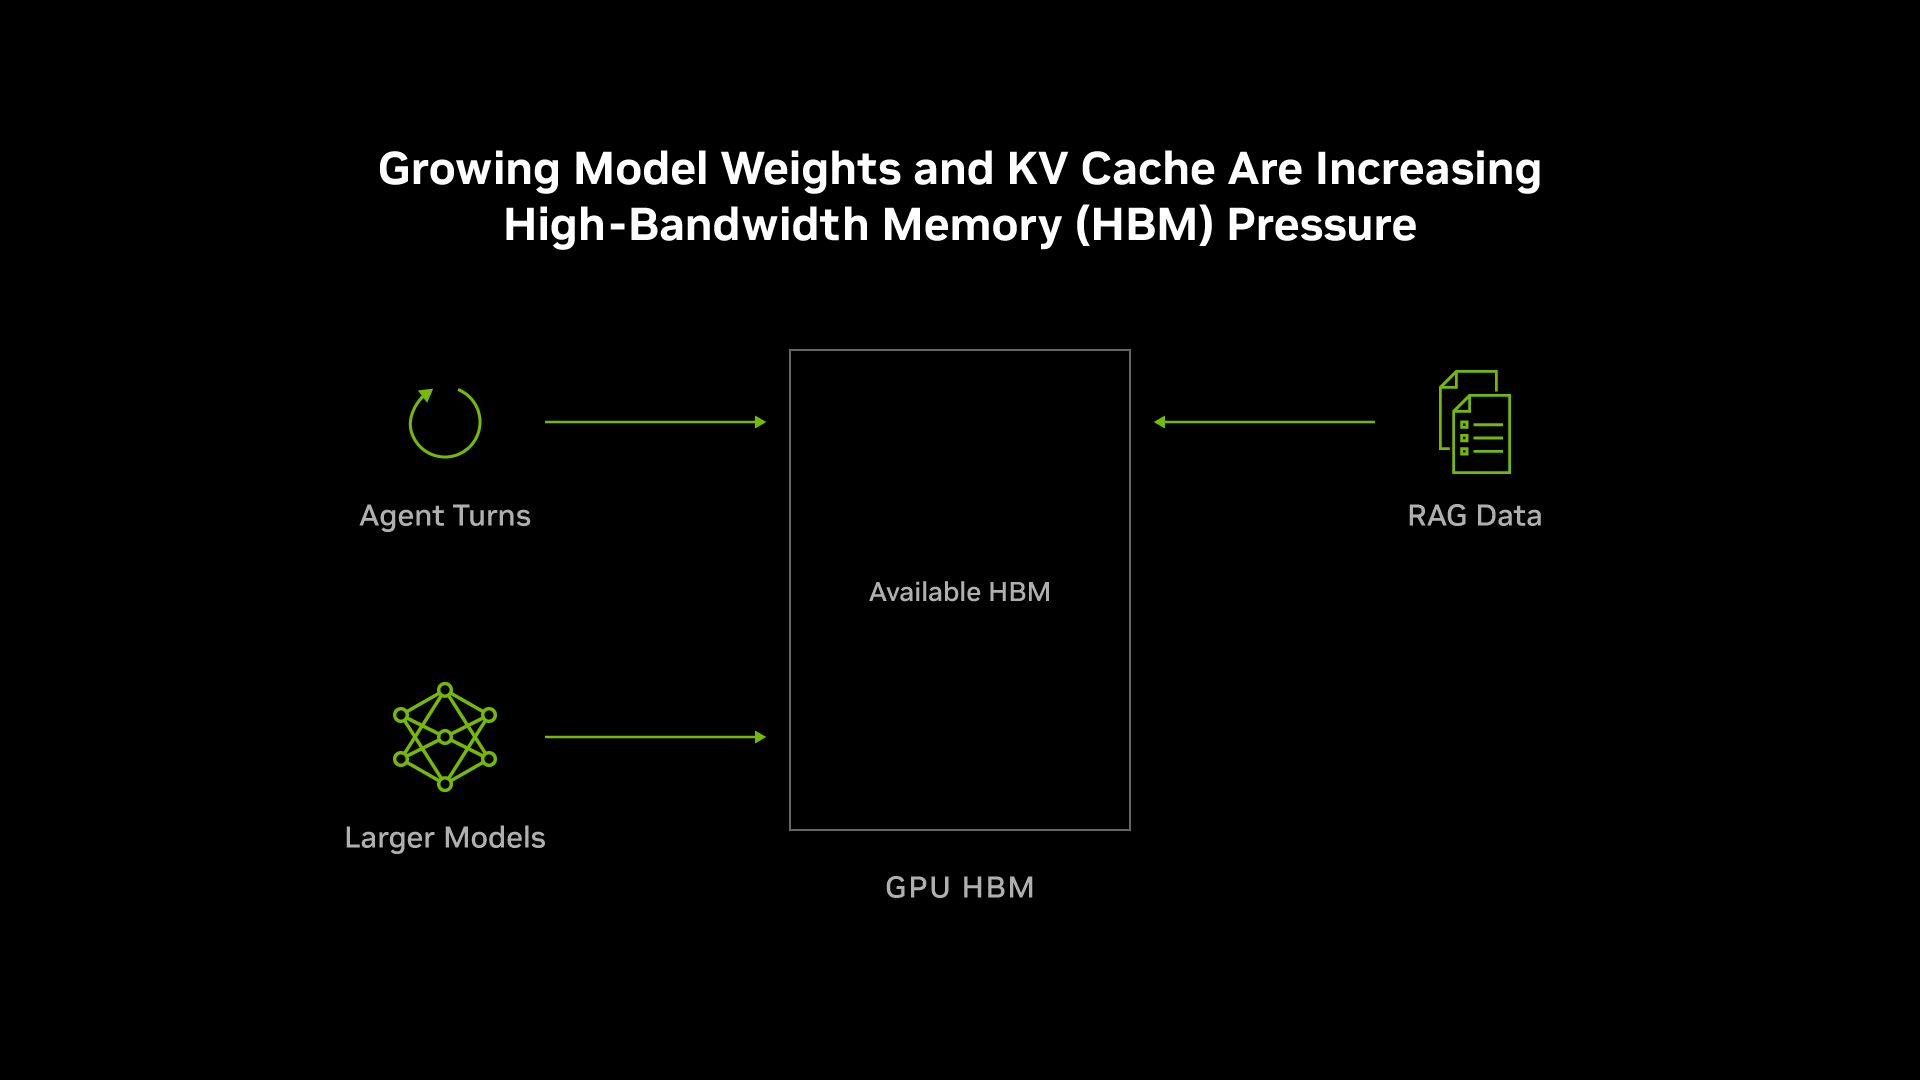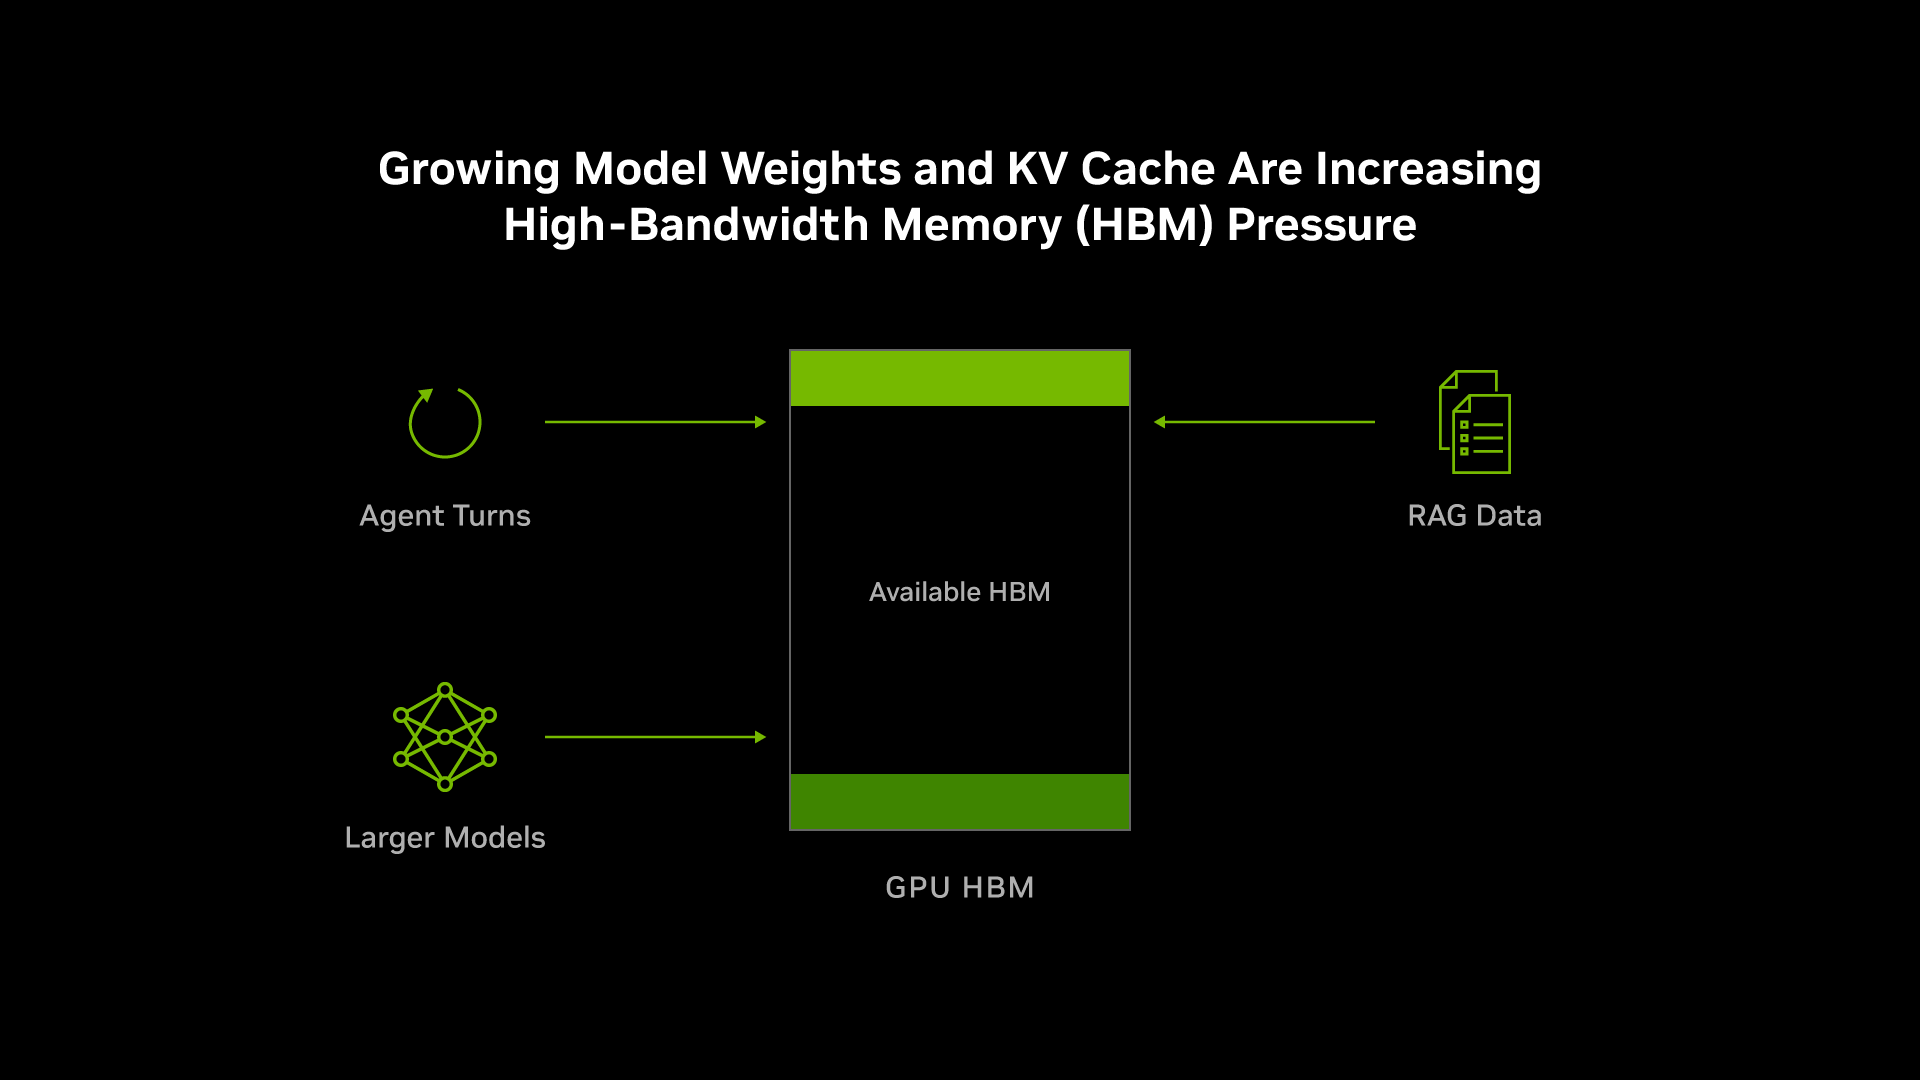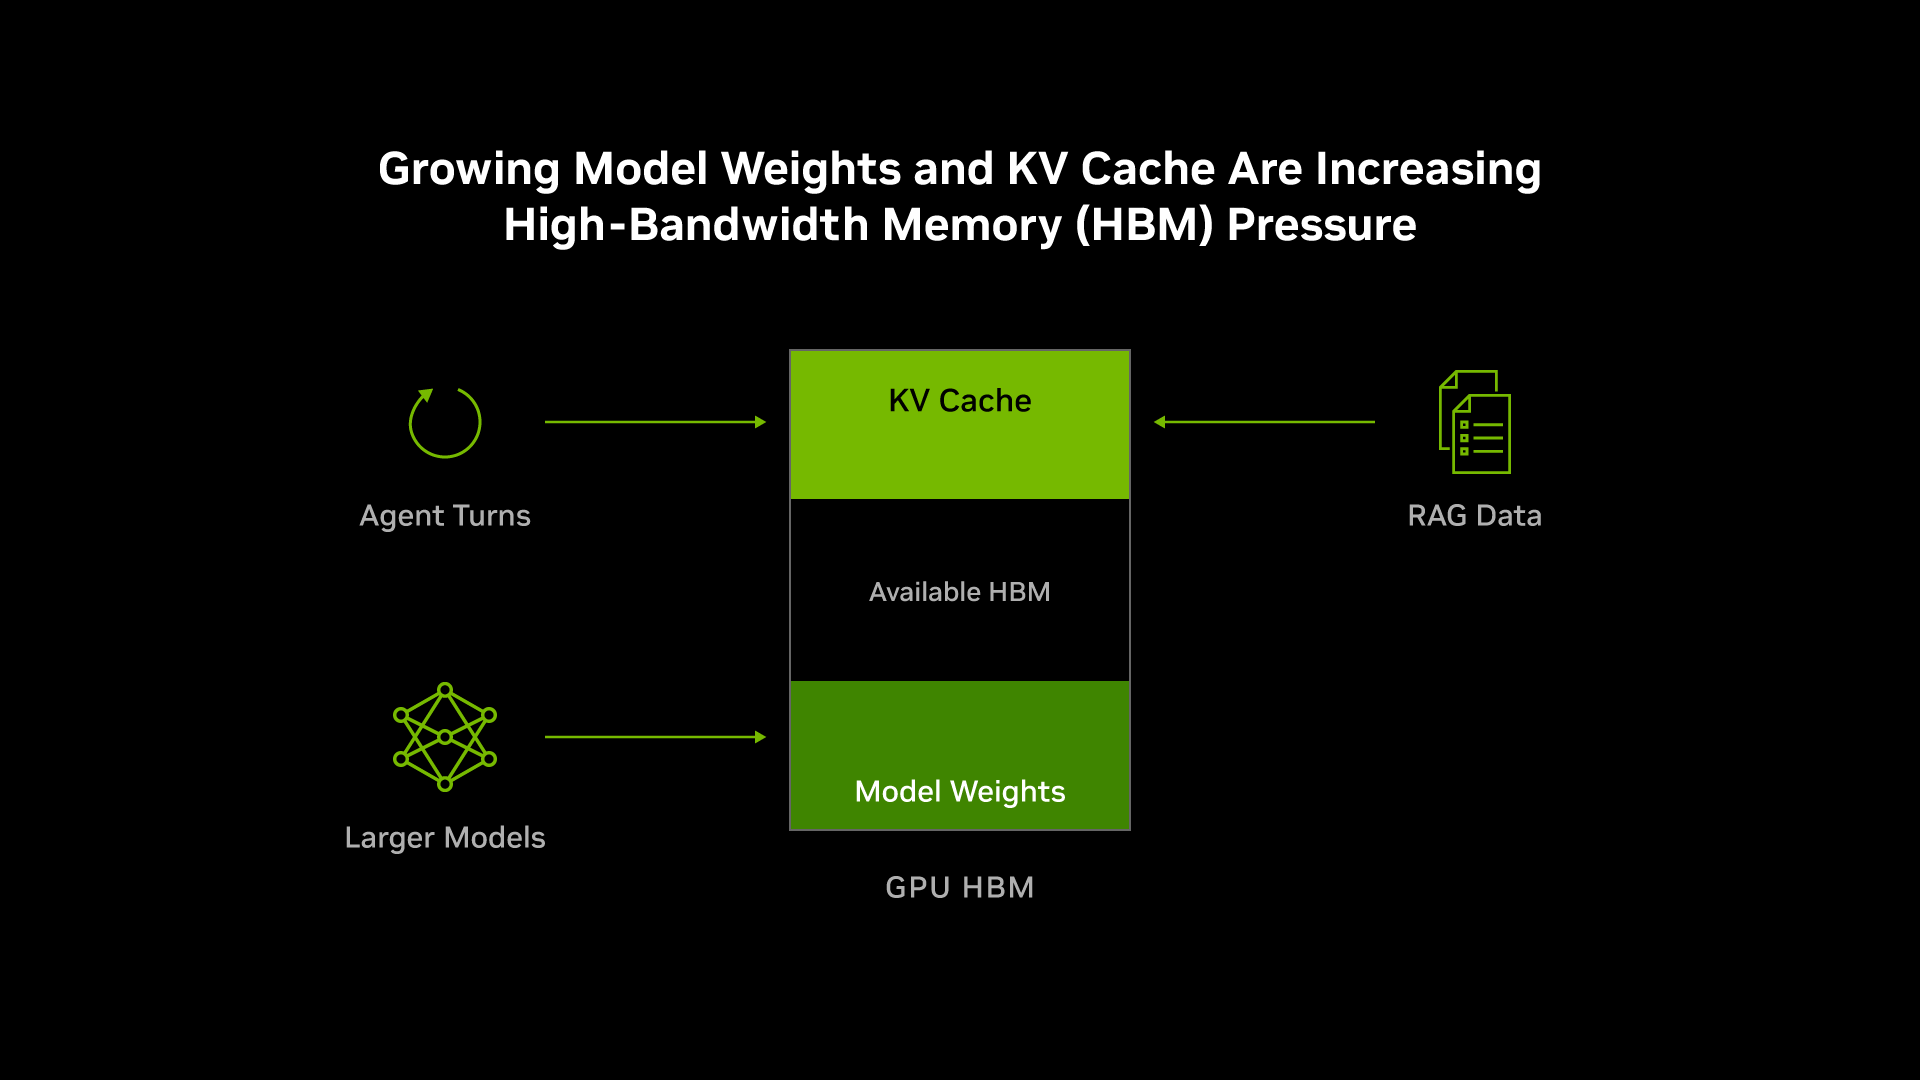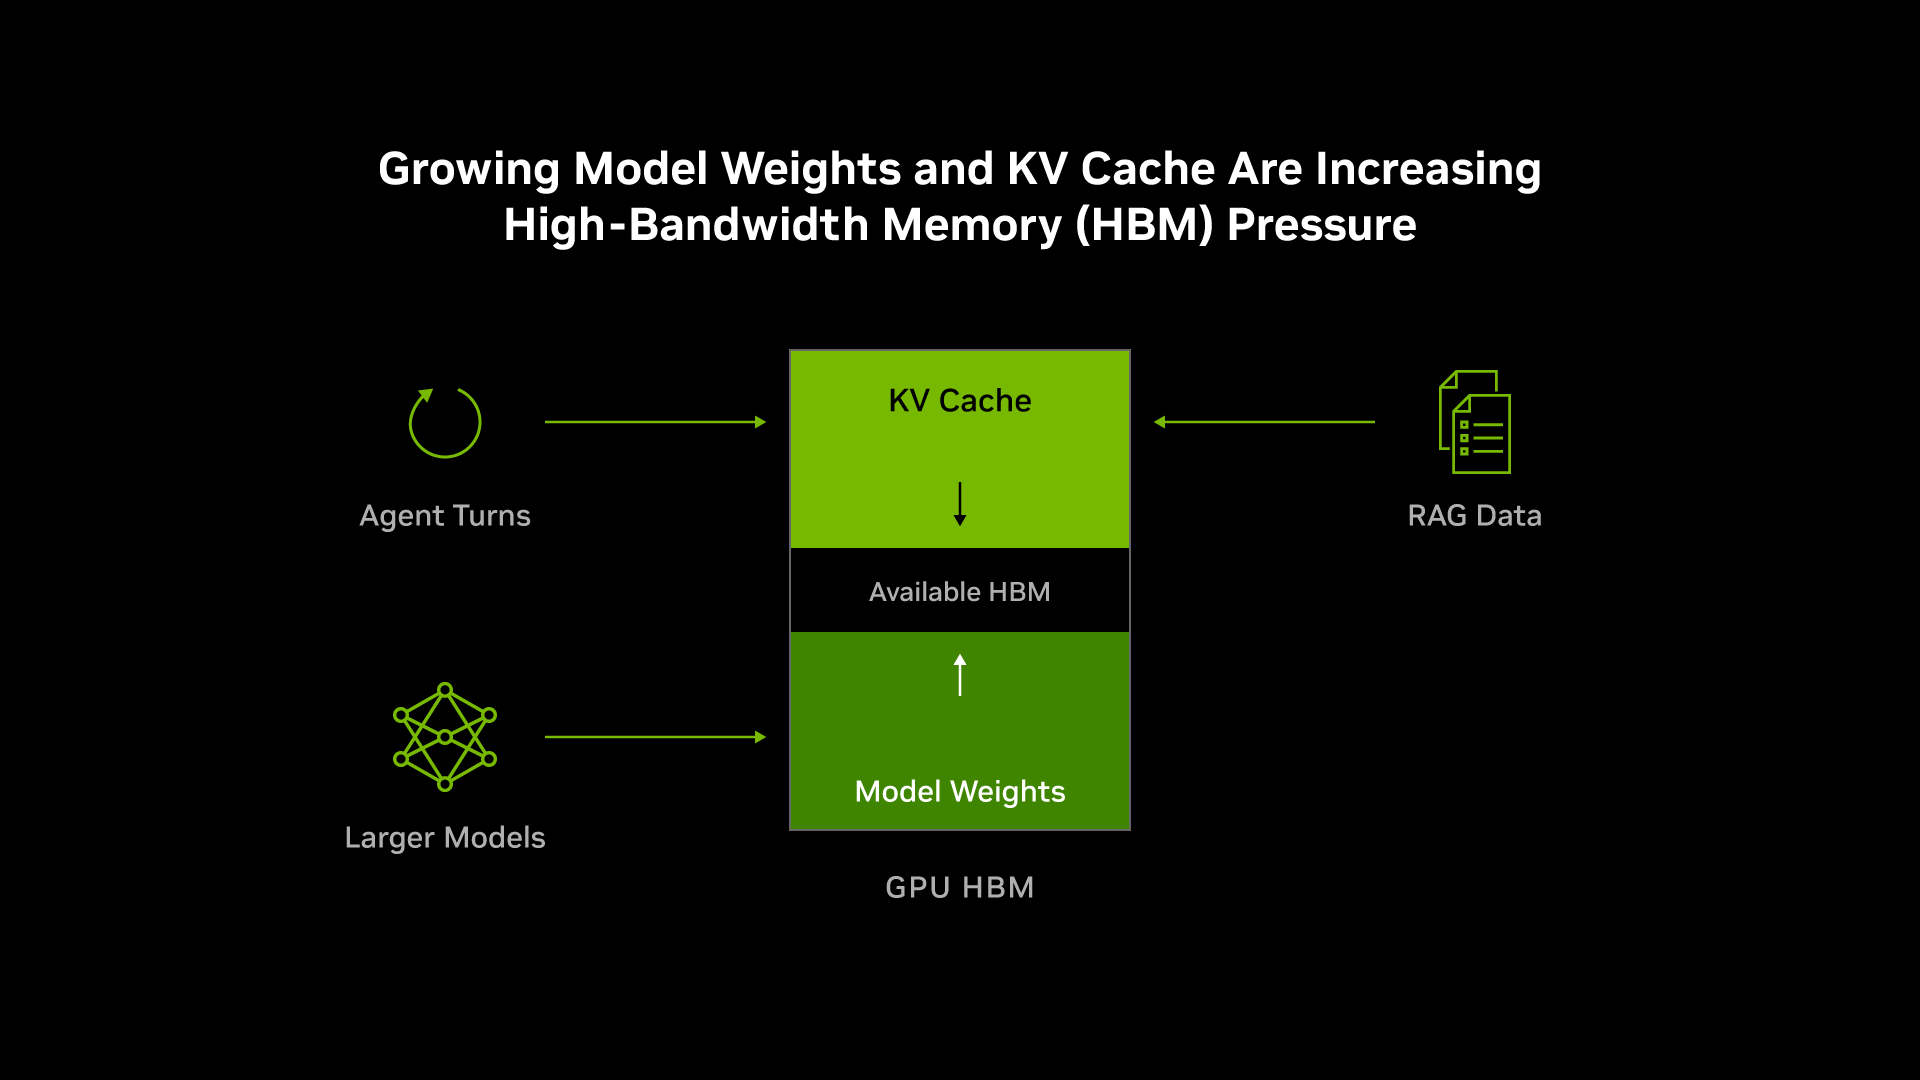
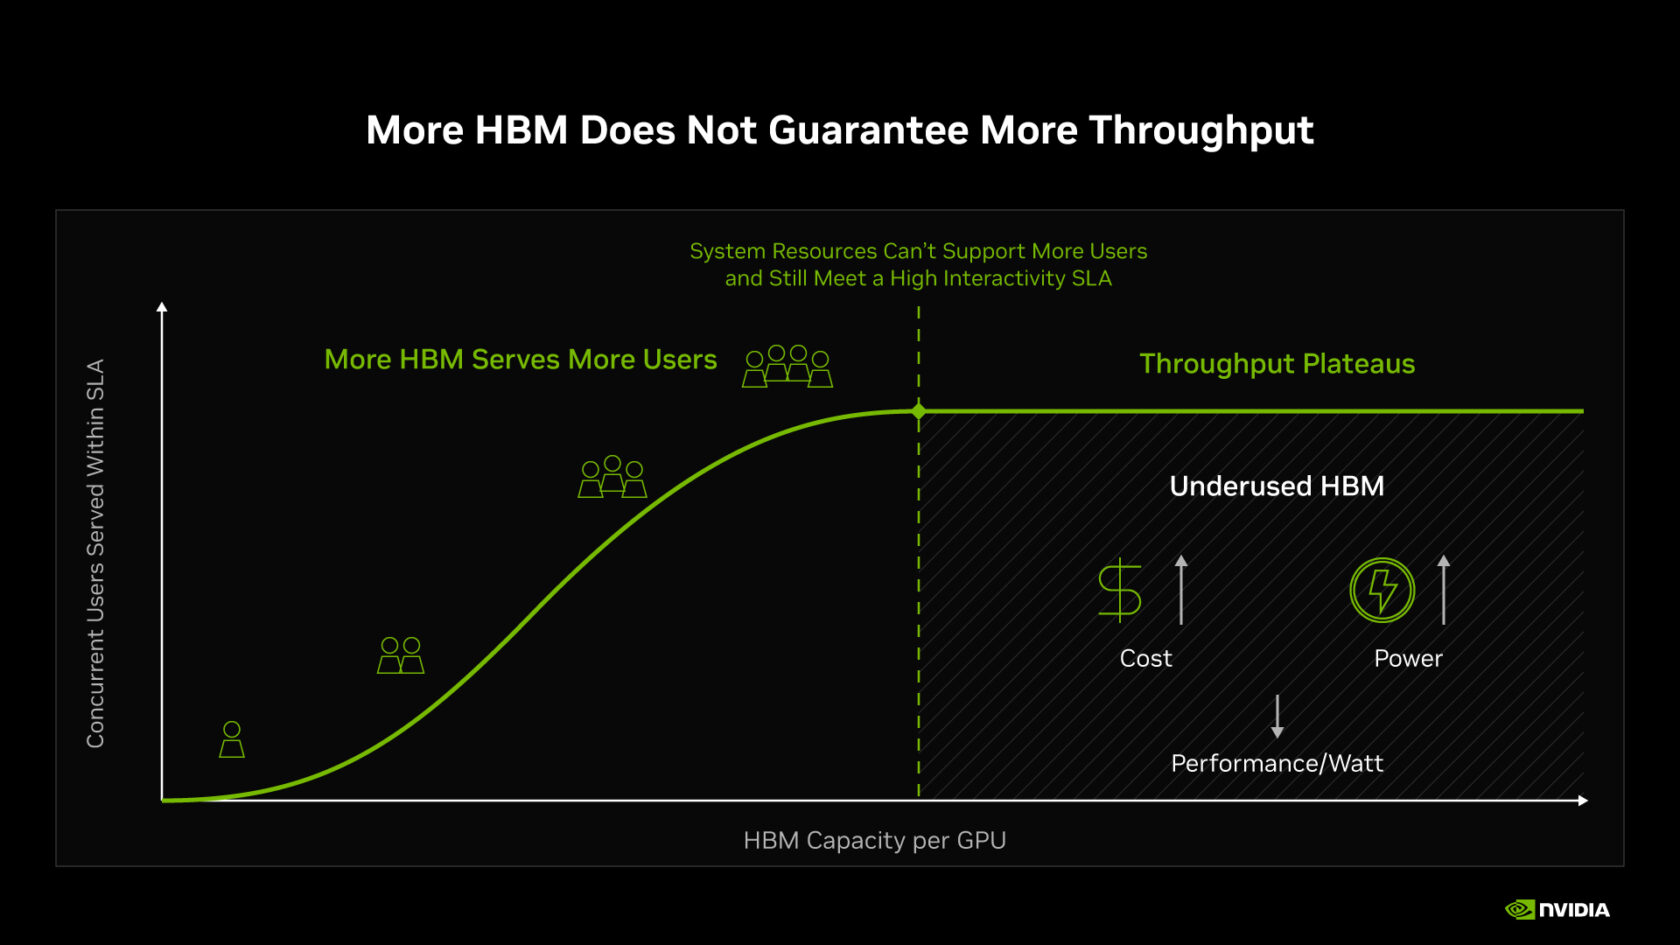
Kaip AI modeliai tampa sudėtingesni – turėdami trilijonus parametrų, ilgėjančias konteksto sritis ir sudėtingesnes agentiškas spėjimo užduotis – GPU didelio pralaidumo atminties (HBM) poreikis stiprėja. NVIDIA atkreipia dėmesį, kad didėjantis spaudimas susiduria su ribota atminties pasiūla ir kylantiomis kainomis, o šis iššūkis numatomas išlikti artimiausiu metu.
Užuot tiesiog didinusi HBM talpą, kuri susiduria su fizinėmis ir sąnaudų ribomis, NVIDIA orientuojasi į visos sistemos kodų kūrimą. Ši strategija apima GPU aparatūros, CPU, tinklo, saugyklų sistemų ir programinės įrangos inžineriją, dirbant kartu, kad būtų maksimaliai išnaudota atmintis visuose lygiuose AI apdorojimo grandinėje – vadinamoje AI fabriku.
Šiuose AI fabrikuose egzistuoja atminties hierarchija: greičiausias ir brangiausias sluoksnis yra GPU HBM, kuriame saugomi modelio svoriai ir raktas-reikšmė (KV) talpykla, turinti aktyvų kontekstą. Žemiau yra didelės, bet lėtesnės CPU atmintys, vietinės SSD ir bendros saugyklos – mainais už greitį jos pasižymi talpa ir kaštų efektyvumu. Tikslas – sumažinti duomenų kiekį brangiausiame sluoksnyje, perkelti neaktyvius duomenis į pigesnius lygius ir laiku iš anksto pakrauti duomenis atgal į GPU, gerinant pralaidumą ir mažinant vėlavimą.
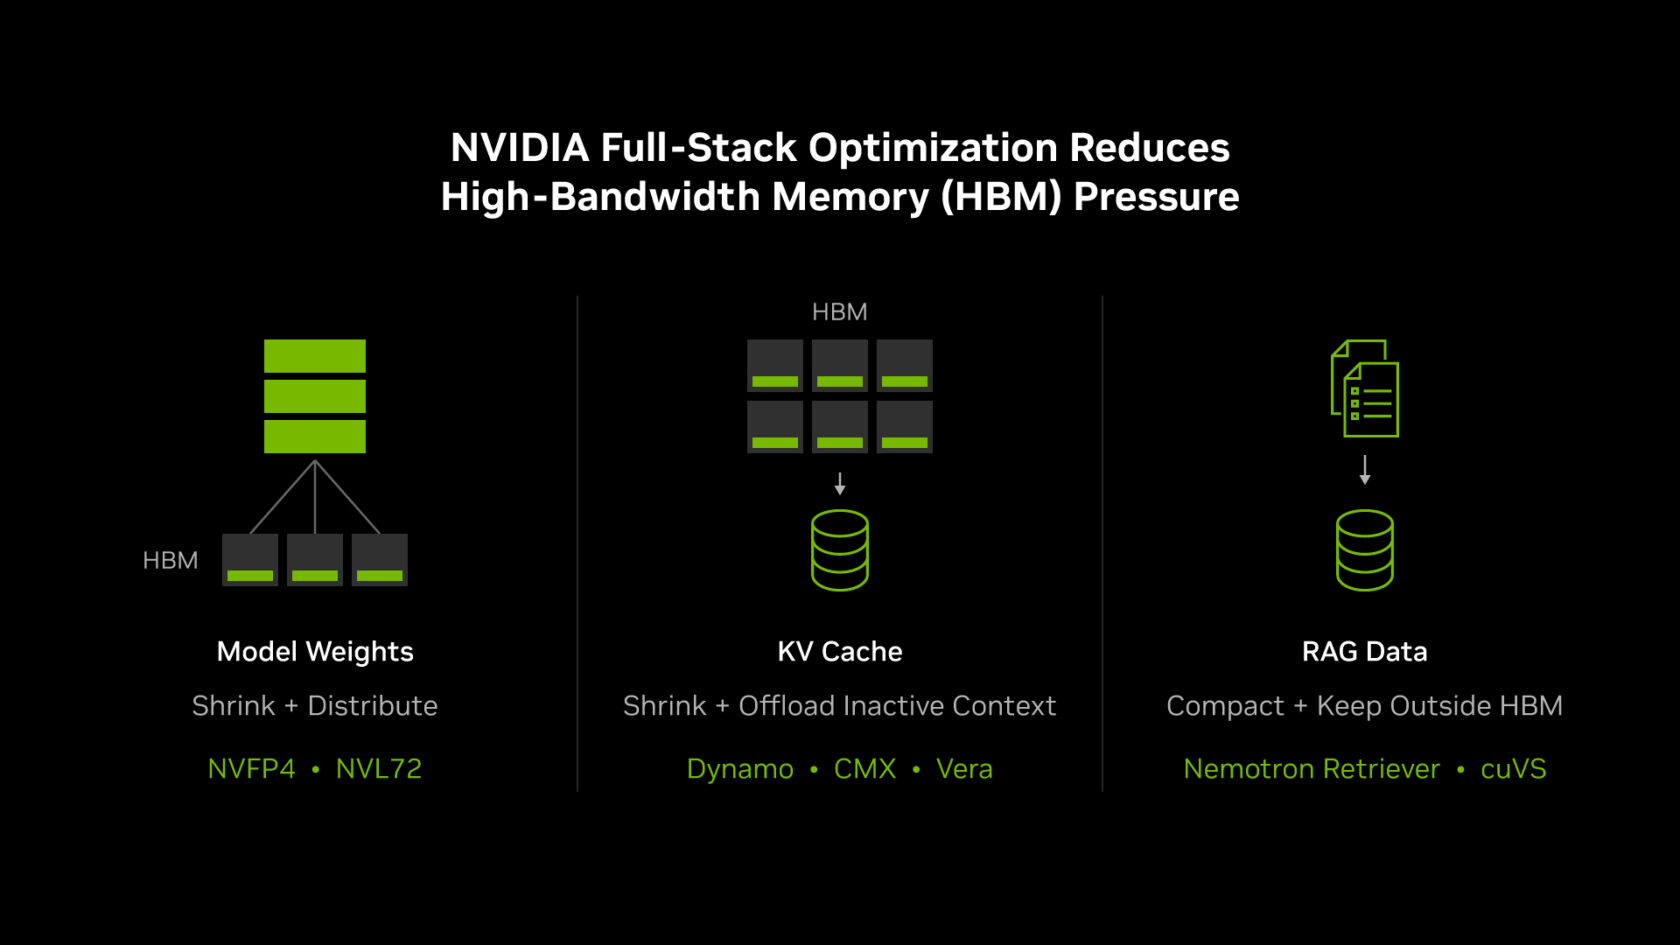
NVIDIA požiūris apima kelias naujoves. Pirma, NVFP4 4 bitų plūduriuojančio kablelio formatas padeda sumažinti modelių svorius ir KV talpyklą bei sumažina atminties vietos poreikį. Visą modelį paskirstant iki 72 GPU NVL72 sistemoje, daugiau HBM paskiriama KV talpyklai ir naudotojų lygiagrečiam darbui.
Antra, neaktyvų KV talpyklos kontekstą galima perkelti iš brangios HBM į didelę CPU prijungtą atmintį arba bendrus saugojimo lygius naudojant naują NVIDIA Dynamo spėjimo programinę įrangą ir CMX kontekstinės atminties sprendimus. Ši programinė įranga valdo KV talpyklą per GPU atmintį, CPU atmintį ir saugyklą, leidžiant greitai pakartotinai naudoti duomenis nenuolat laikant jų visuose HBM.
Trečia, paieškos papildyta generacija (RAG) sumažina HBM apkrovą, laikant dideles įmonių žinių bazes už GPU ribų. Vietoje to, NVIDIA Nemotron Retriever gamina kompaktiškus vektorių embedingus, o cuVS biblioteka valdo paieškos indeksą CPU ir saugojimo lygiuose. Tik atitinkami tekstai patenka į didelio greičio GPU kontekstą.
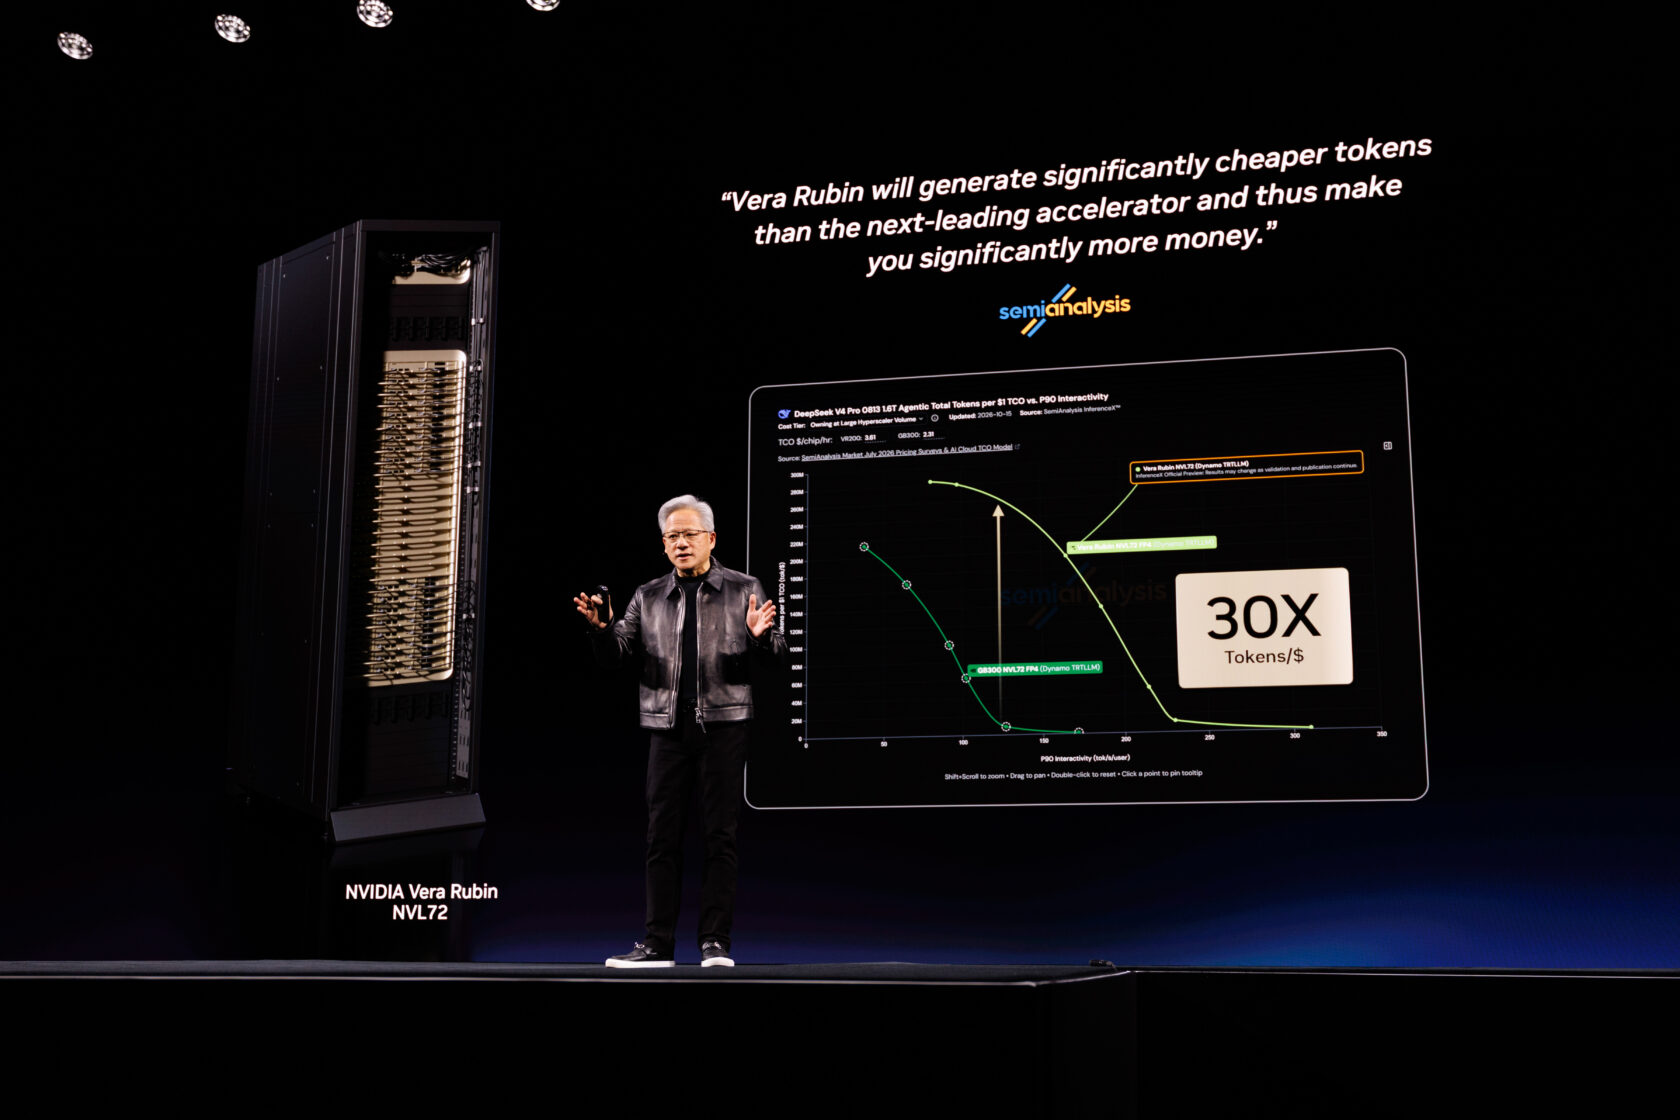
NVIDIA praneša, kad šie kombinacijos optimizacijos padidino HBM talpą apie 3 % kiekvienam GPU nuo NVIDIA Blackwell Ultra iki Vera Rubin platformos, o bandymuose kaip SemiAnalysis AgentX pasiekta iki 30 kartų didesnė agentiško pralaidumo našta vienam doleriui.
Sprendžiant atminties pralaidumo apribojimus – vadinamąją atminties sieną – NVIDIA visa apimanti kodų kūrimo strategija leidžia AI darbų krūviams atlikti daugiau naudingų skaičiavimų vienam atminties baitui, mažindama energijos suvartojimą ir sąnaudas. Ši holistinė atminties valdymo strategija žymi perėjimą nuo gryno atminties talpos didinimo prie efektyvumo koordinavimo tarp aparatūros ir programinės įrangos sluoksnių, atsižvelgiant į didėjančius AI poreikius.
Išsamiai techninei informacijai NVIDIA pateikia video paaiškinimą ir gilų panardinimą į tai, kaip visa apimanti kodų kūrimo požiūris mažina spėjimo metu kylančią atminties apkrovą ir gerina AI platformos ekonomikumą.
Šaltiniai ir originalūs pranešimai
Skaityti originalų šaltinį ↗
Komentarai (0)
Komentarų dar nėra. Pradėkite diskusiją.
Rašyti komentarą
Komentarai publikuojami po moderavimo. Jūsų vardas ir komentaras bus vieši. Paskyra