
NVIDIA parandab tehisintellekti mälu efektiivsust täisvirna üheskoos kujundamise lähenemisega
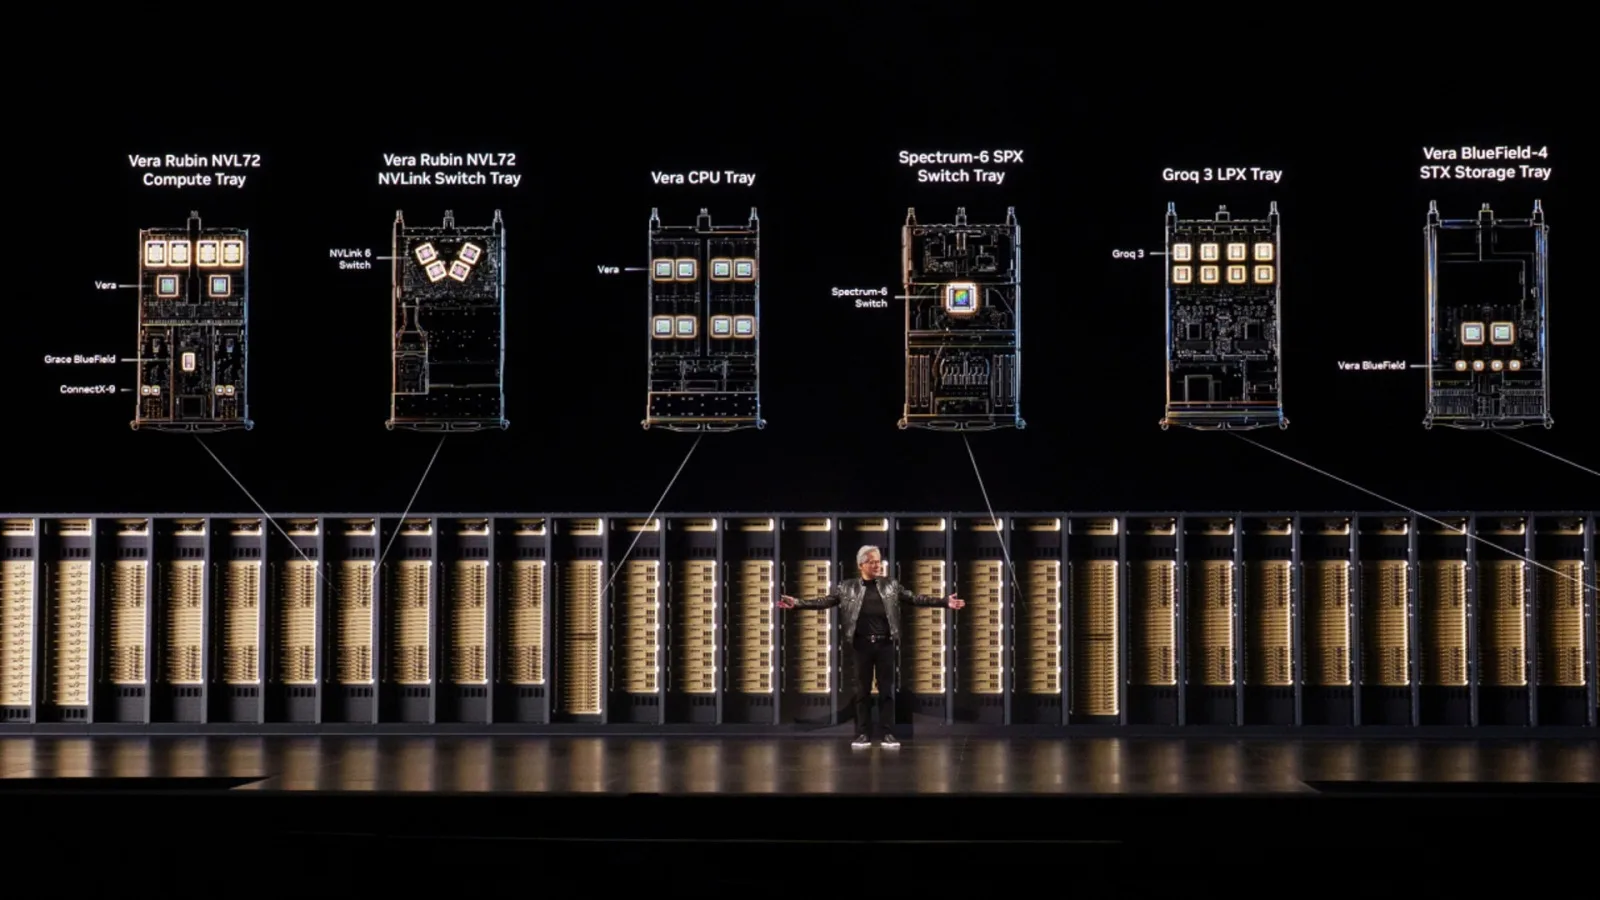
Pilt: NVIDIA · Allikas
NVIDIA lahendab suurenevad GPU mälu nõudmised tehisintellektis täisvirna üheskoos kujundamise abil, optimeerides mälu kasutust riistvara ja tarkvara tasandil, et tõsta läbilaskevõimet ja efektiivsust hoolimata piiratud suure läbilaskvusega mälu mahust.
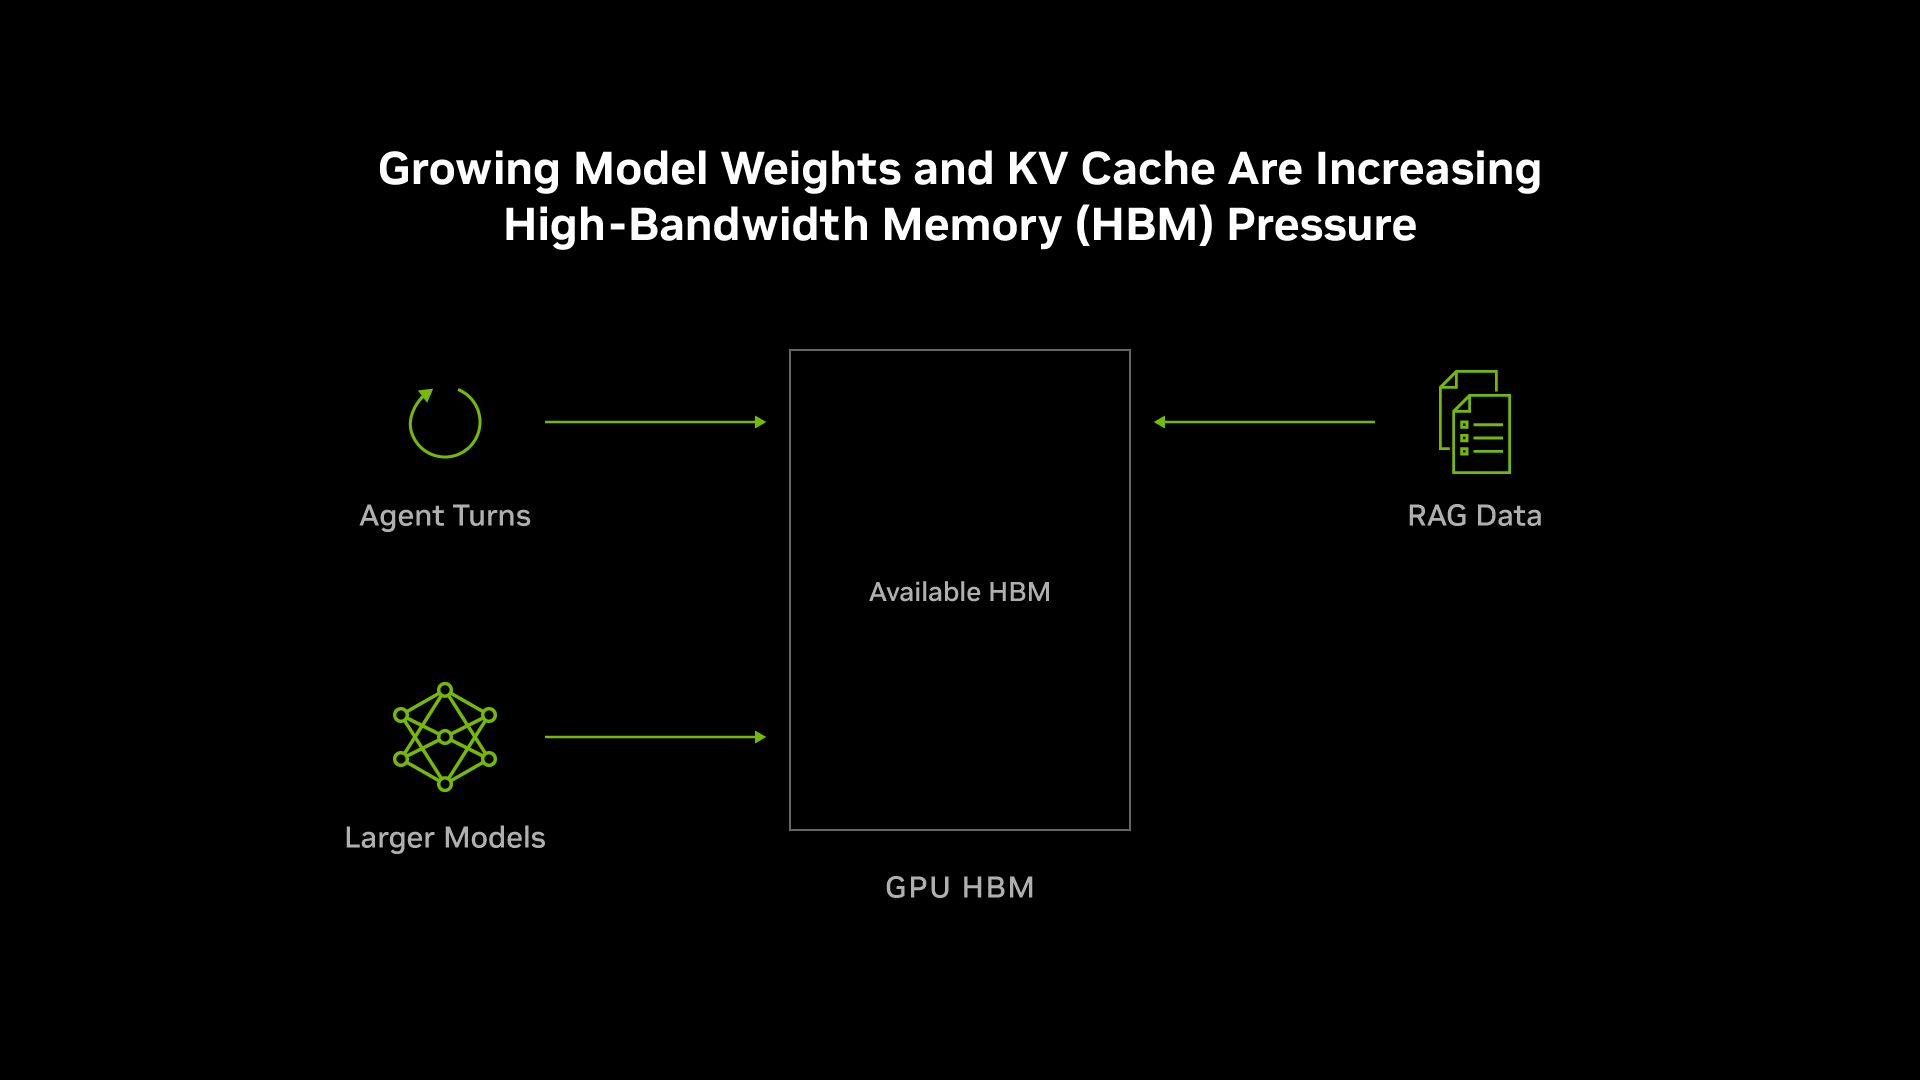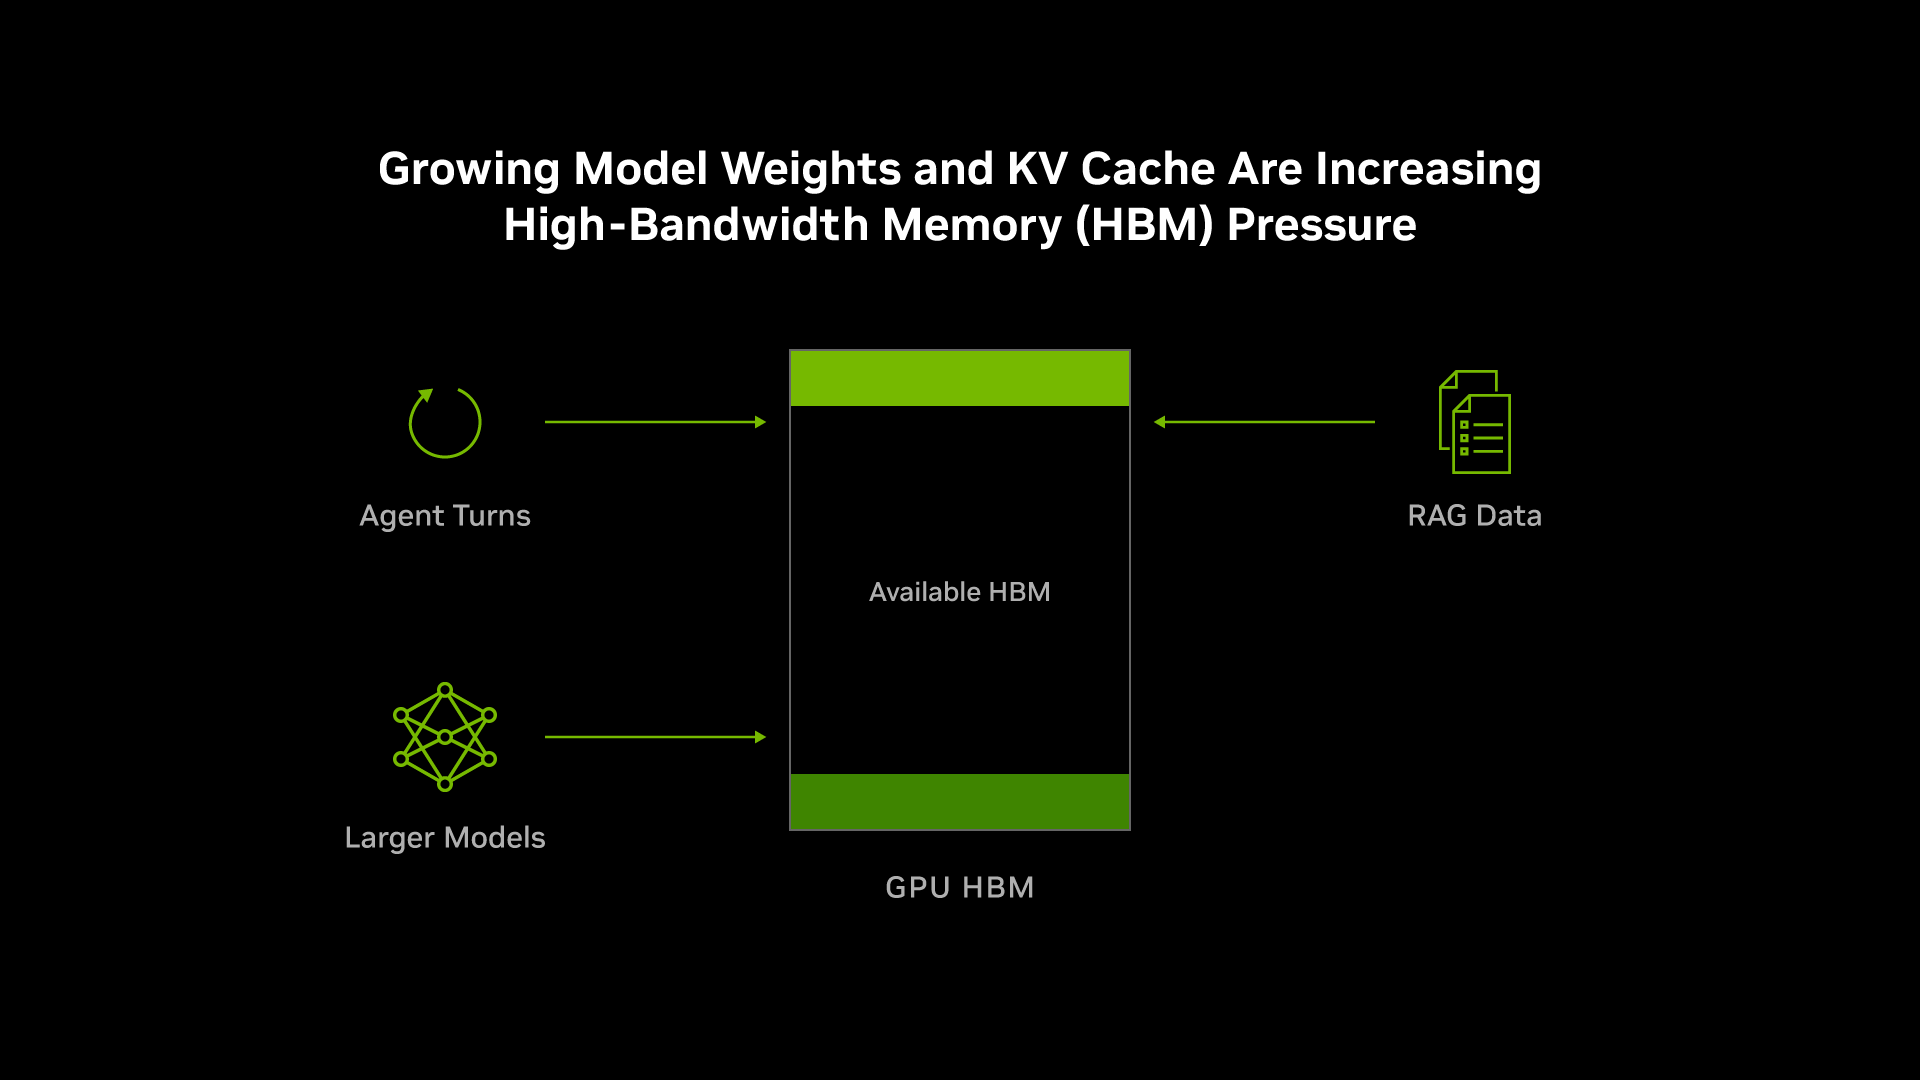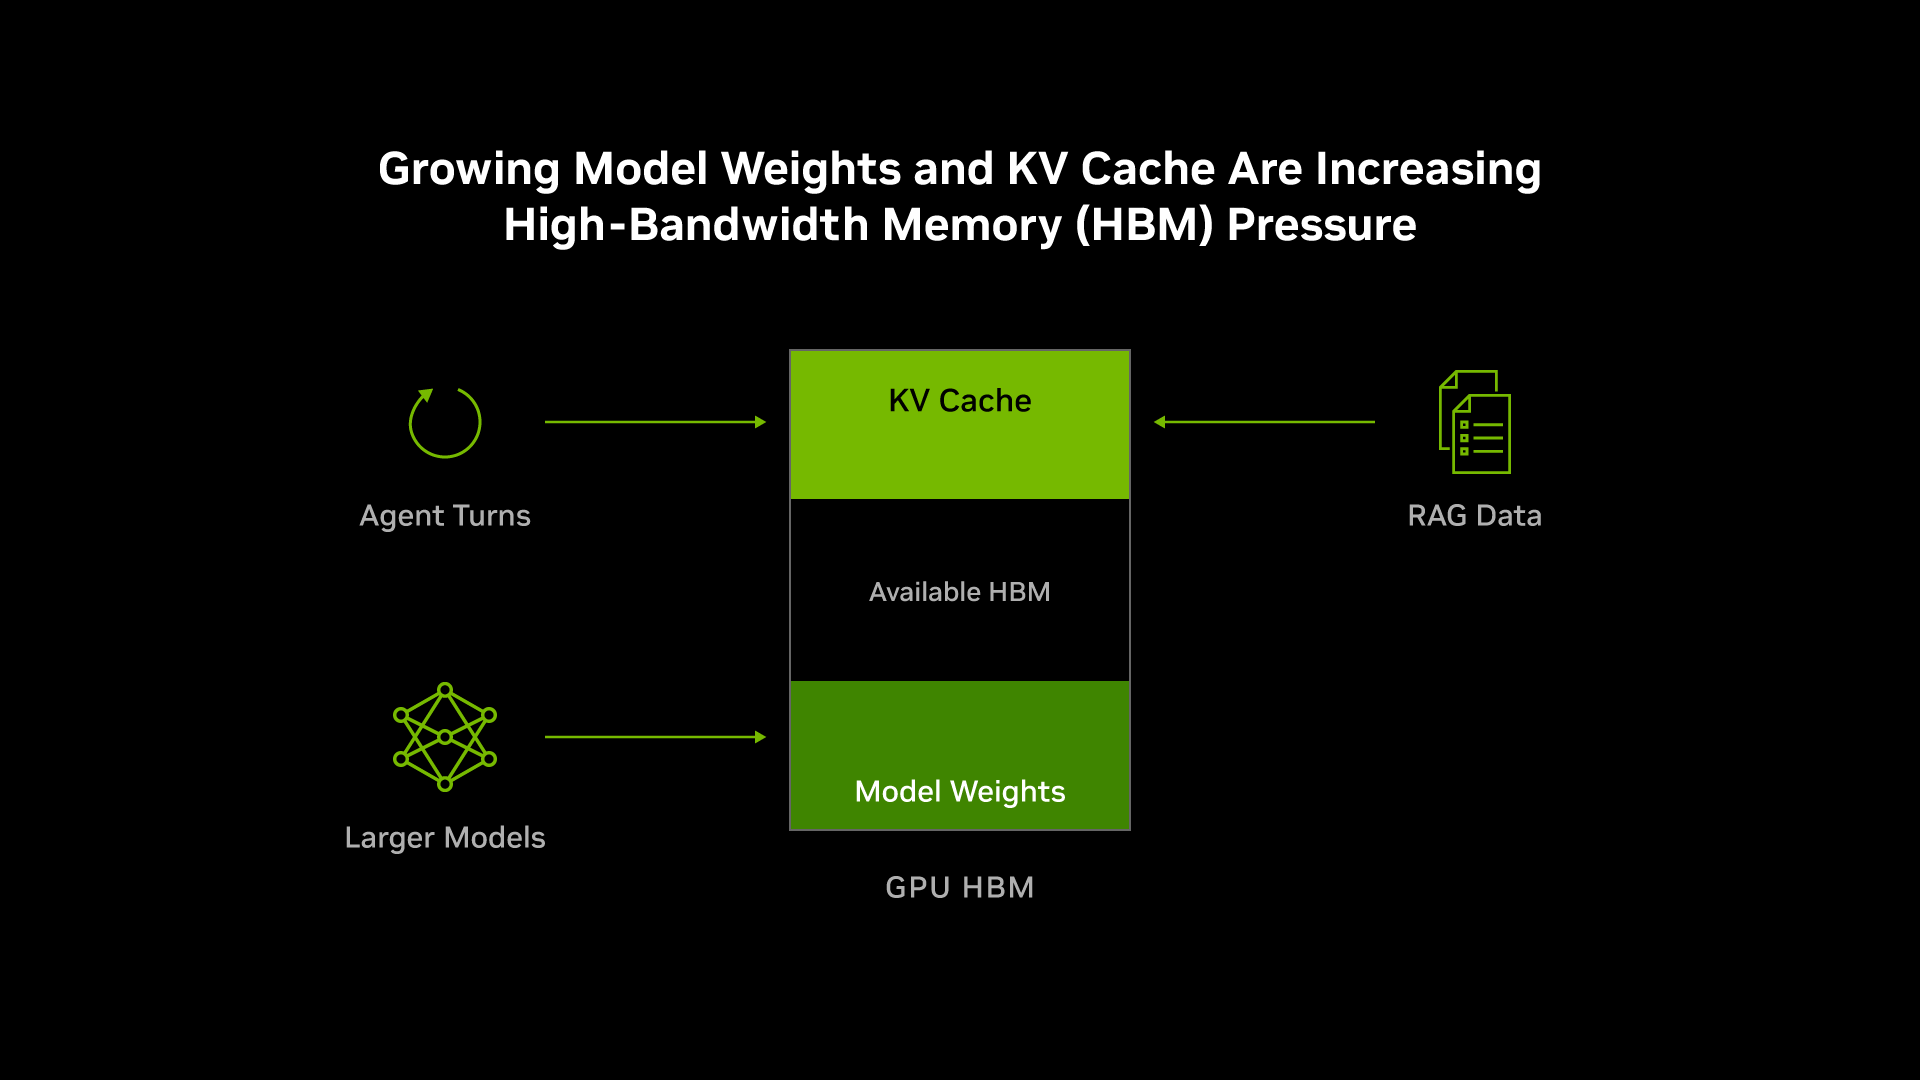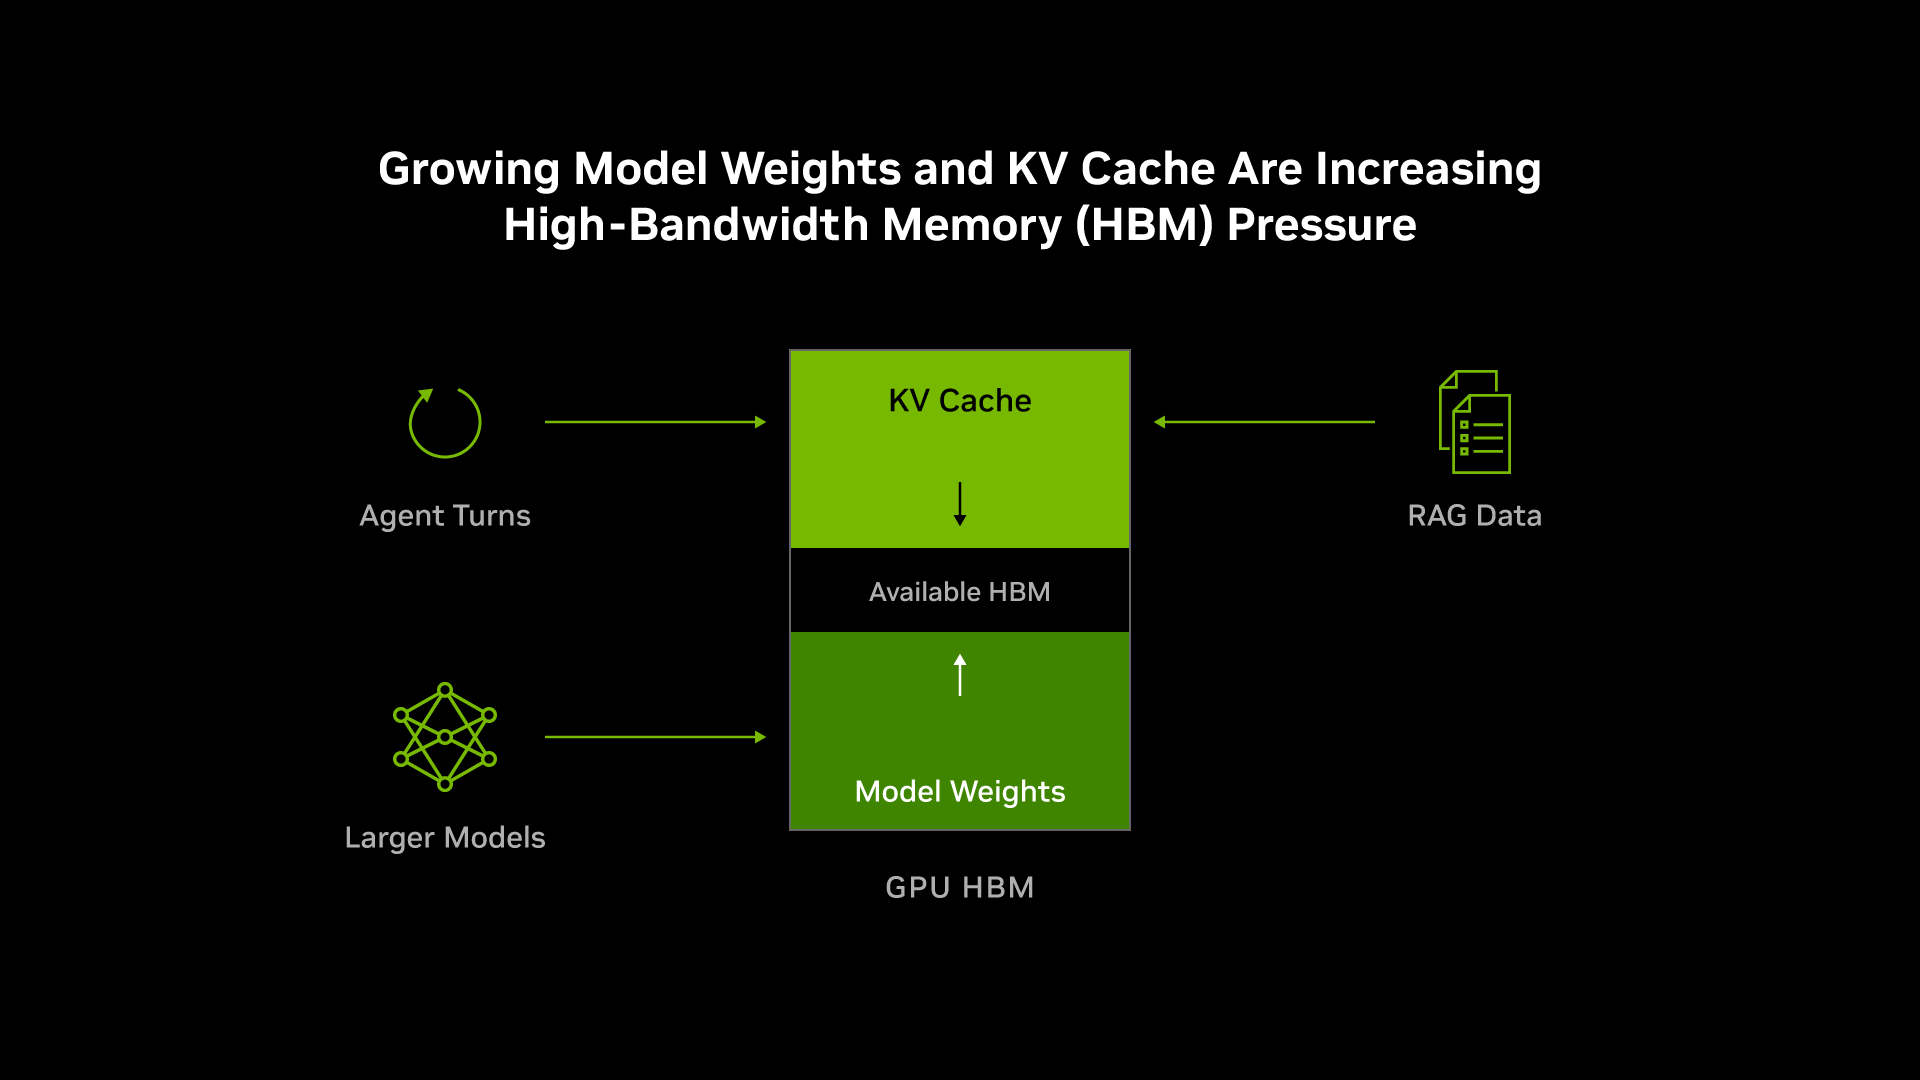
Nagu tehisintellekti mudelid muutuvad keerukamaks — triljonite parameetritega, pikemate kontekstiväljade ja rohkem agentuuripõhiste järeldustsüklitega — kasvab nõudlus GPU-de suure läbilaskvusega mälu (HBM) järele. NVIDIA rõhutab, et see surve kasvab vastu piiratud mälumahtu ja tõusvaid hindu, mis on prognooside järgi lähiajal püsiv väljakutse.
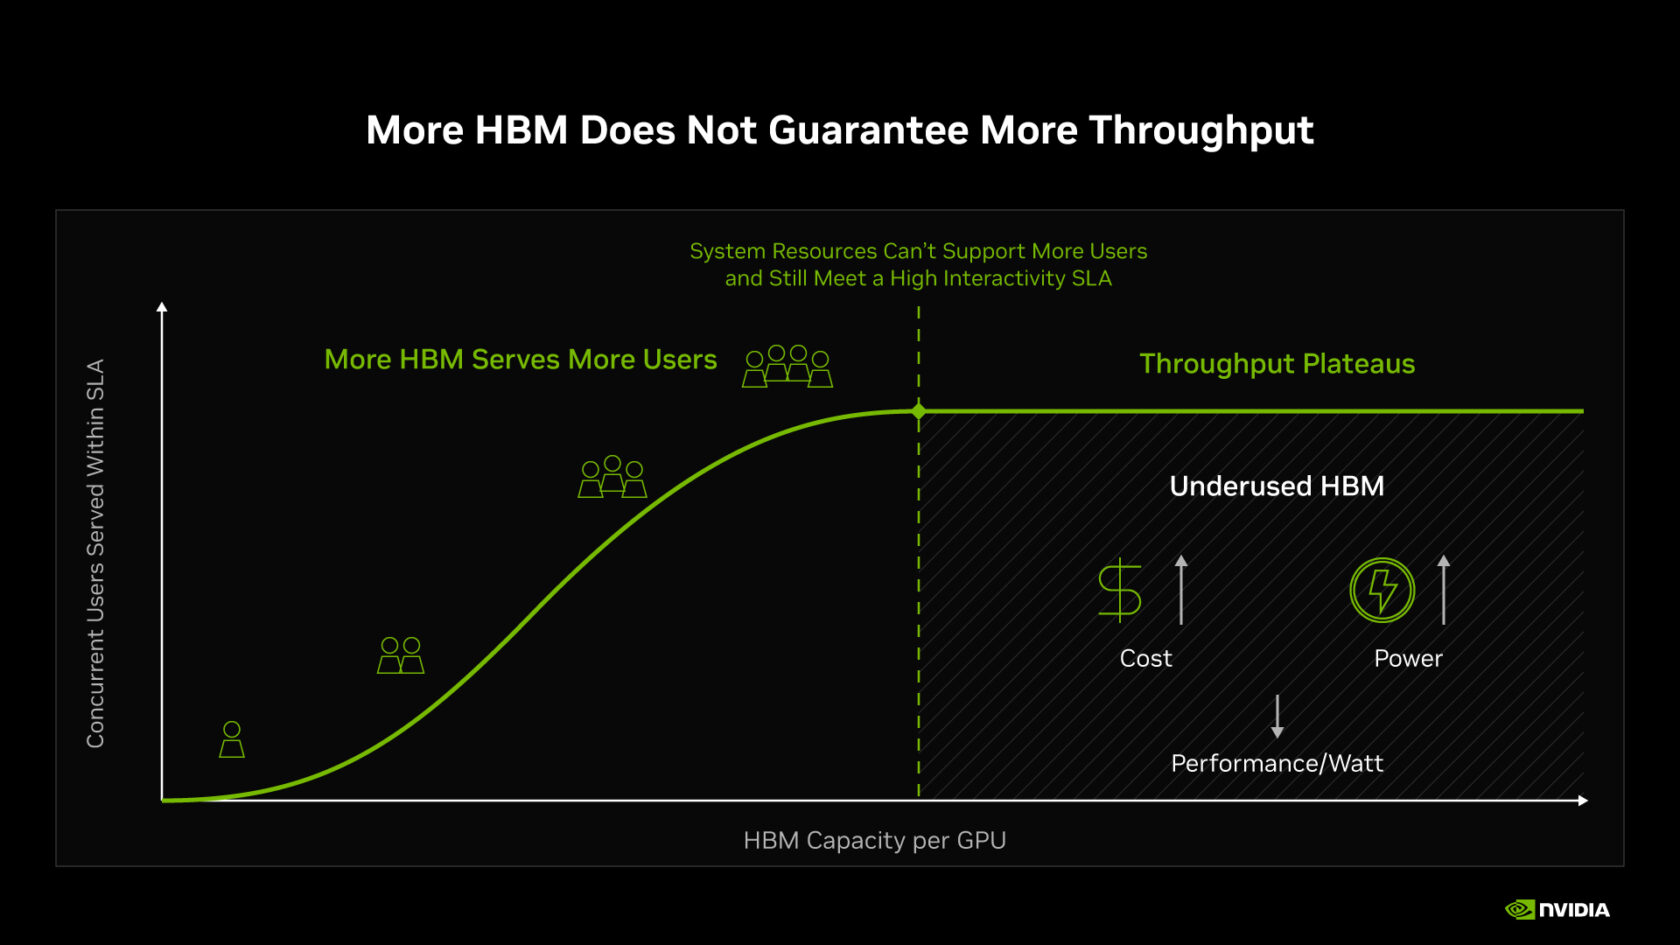
Selle asemel, et lihtsalt suurendada HBM mahtu, mis on füüsiliste ja kulupiirangutega, keskendub NVIDIA täisvirna üheskoos kujundamisele. See strateegia hõlmab GPU riistvara, protsessorite, võrgunduse, salvestussüsteemide ja tarkvara koordineeritud kavandamist, et maksimeerida mälukasutust tehisintellekti töötlustorul ehk AI tehases kõigil tasanditel.
Neis AI tehastes eksisteerib mäluhierarhia: kõige kiirem ja kallim kiht on GPU HBM, mis hoiab mudeli kaalusid ja võtme-väärtuse (KV) vahemälu aktiivse konteksti jaoks. Selle all asuvad mahukad, kuid aeglasemad protsessori mälud, kohalikud SSD-d ja jagatud salvestus — kõik vahetades kiirust mahu ja kulutõhususe vastu. Eesmärgiks on vähendada andmete mahtu kõige kallimas kihis, teisaldada passiivsed andmed odavamatesse kihtidesse ning laadida andmeid kiiresti tagasi GPU-des tagasi, parandades läbilaskevõimet ja vähendades latentsust.
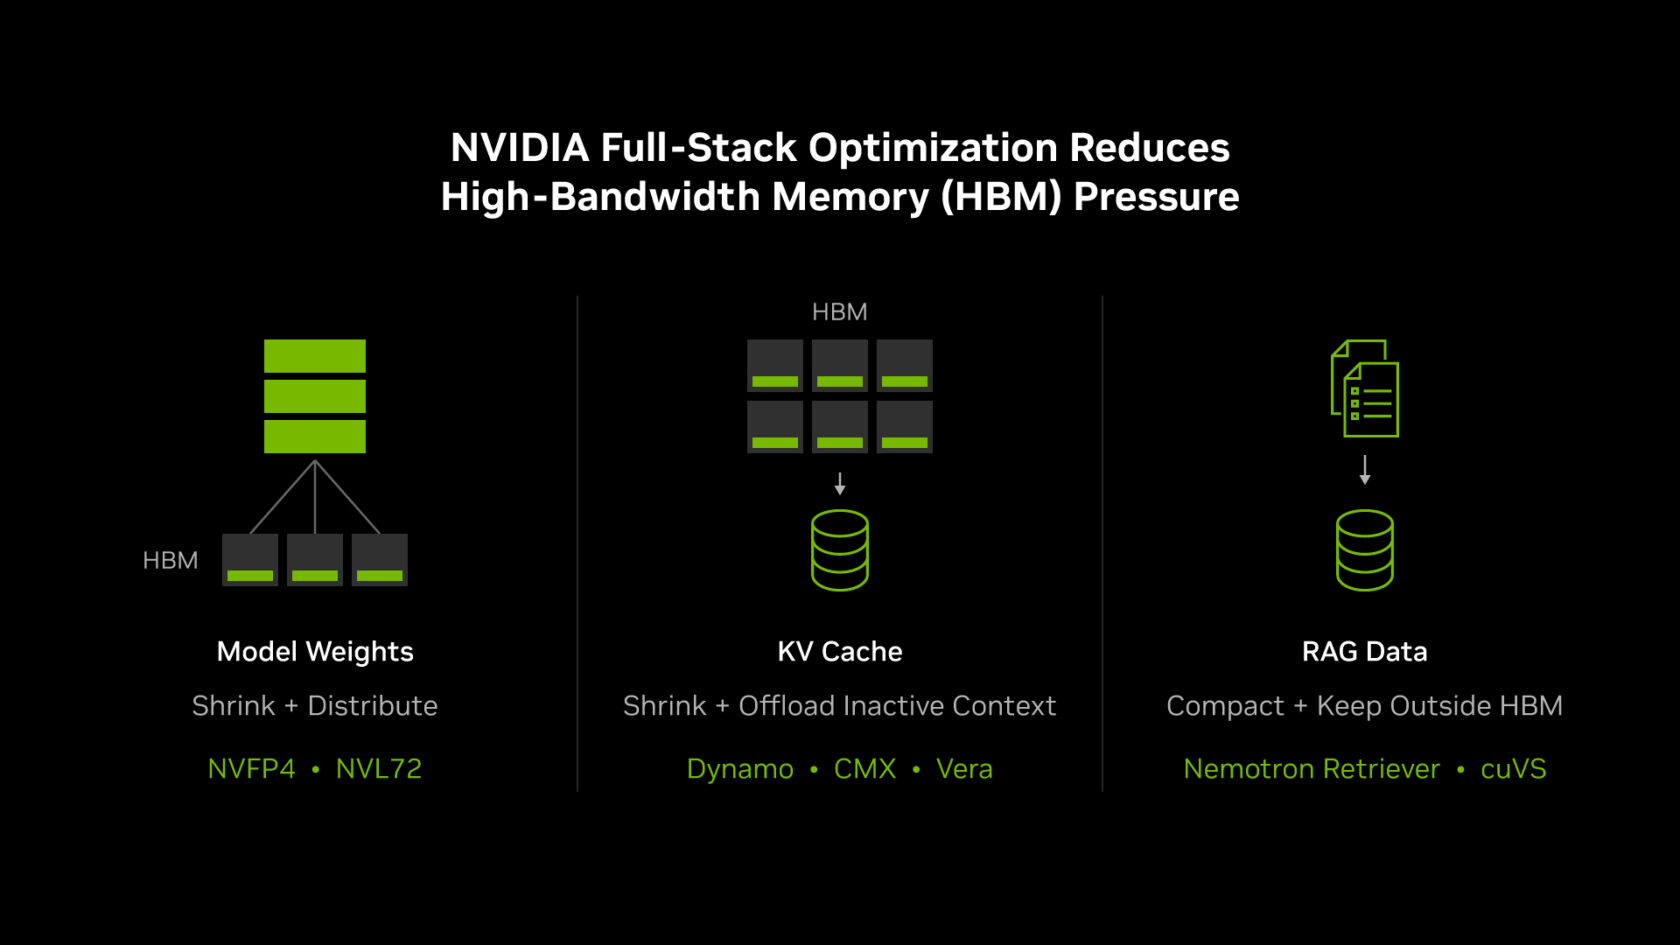
NVIDIA lähenemine hõlmab mitmeid uuendusi. Esiteks aitab 4-bitisel ujukomaga andmeformaadil NVFP4 kokku hoida mudeli kaalusid ja KV vahemälu, vähendades mälu jalajälge. Kogu mudeli jaotamine kuni 72 GPU vahel NVL72 süsteemis vabastab veelgi HBM-i KV vahemälu ja kasutajate samaaegseks tööks.
Teiseks saab passiivse KV vahemälu konteksti kallist HBM-ist välja viia suurtesse protsessoriga ühendatud mälukihtidesse või jagatud salvestusse, kasutades uut NVIDIA Dynamo järeldustarkvara ja CMX kontekstimälu lahendusi. See tarkvara haldab KV vahemälu GPU mälu, protsessori mälu ja salvestuse vahel, võimaldades kiiret taaskasutust ilma kõiki andmeid pidevalt HBM-is hoidmata.
Kolmandaks vähendavad päringu-augmenteeritud generatsiooni (RAG) tehnikad HBM koormust, hoides suuri ettevõtte teadmiste baase GPU-st eemal. Selle asemel toodab NVIDIA Nemotron Retriever kompaktsed vektoritega esitusviisid ning cuVS teek haldab otsitavat indeksit protsessorite ja salvestuskihtide vahel. Ainult olulised tekstilõigud jõuavad suure kiirusega GPU konteksti.
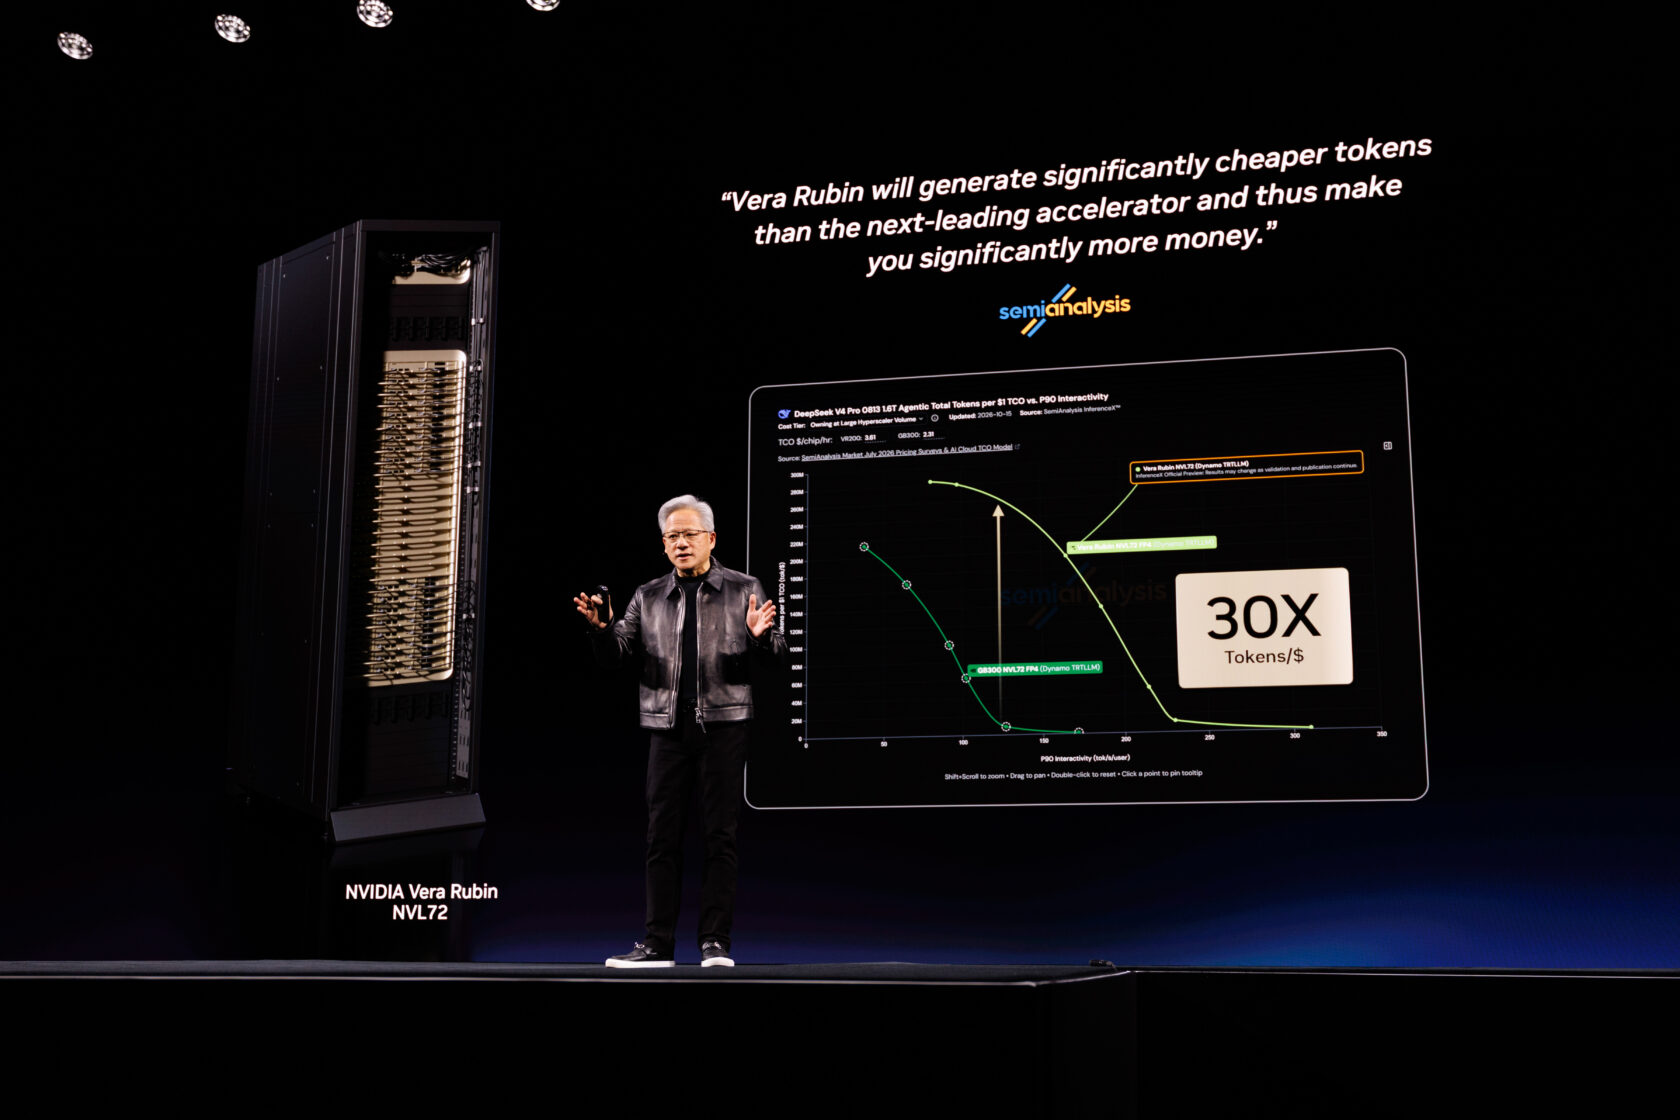
NVIDIA teatab, et need kombineeritud optimeerimised on tõstnud HBM mahtu GPU kohta umbes 3% alates NVIDIA Blackwell Ultra platvormist kuni Vera Rubin platvormini, kuid tõstnud teatud testtöökoormates, nagu SemiAnalysis AgentX, agentuurset läbilaskevõimet dollarihinna kohta kuni 30 korda.
Lahendades mäluläbilaskvuse piiranguid — nn mäluseina — võimaldab NVIDIA täisvirna üheskoos kujundamine tehisintellekti töökoormustel teha kasulikumaid arvutusi ühe mälbaiti kohta, vähendades energiatarbimist ja kulusid. See terviklik mäluhalduse strateegia tähistab nihet, kus ei püütagi ainult puhtaid mälumahte, vaid korraldatakse efektiivsust riistvara ja tarkvara tasandite vahel vastavalt tehisintellekti kasvavatele nõudmistele.
Lisatehnilise süvainteressiga pakub NVIDIA video selgitaja ja põhjaliku ülevaate täisvirna üheskoos kujundamisest, mis vähendab järelduste mälu survet ja parandab AI platvormi majandust.
Allikad ja originaaluudised
Loe originaali allikat ↗
Kommentaarid (0)
Kommentaare veel pole. Alusta arutelu.
Kirjuta kommentaar
Kommentaarid avaldatakse pärast modereerimist. Sinu nimi ja kommentaar on avalikult nähtavad. Konto