
NVIDIA edistää tekoälyn muistin tehokkuutta koko pinon koodisuunnittelulla
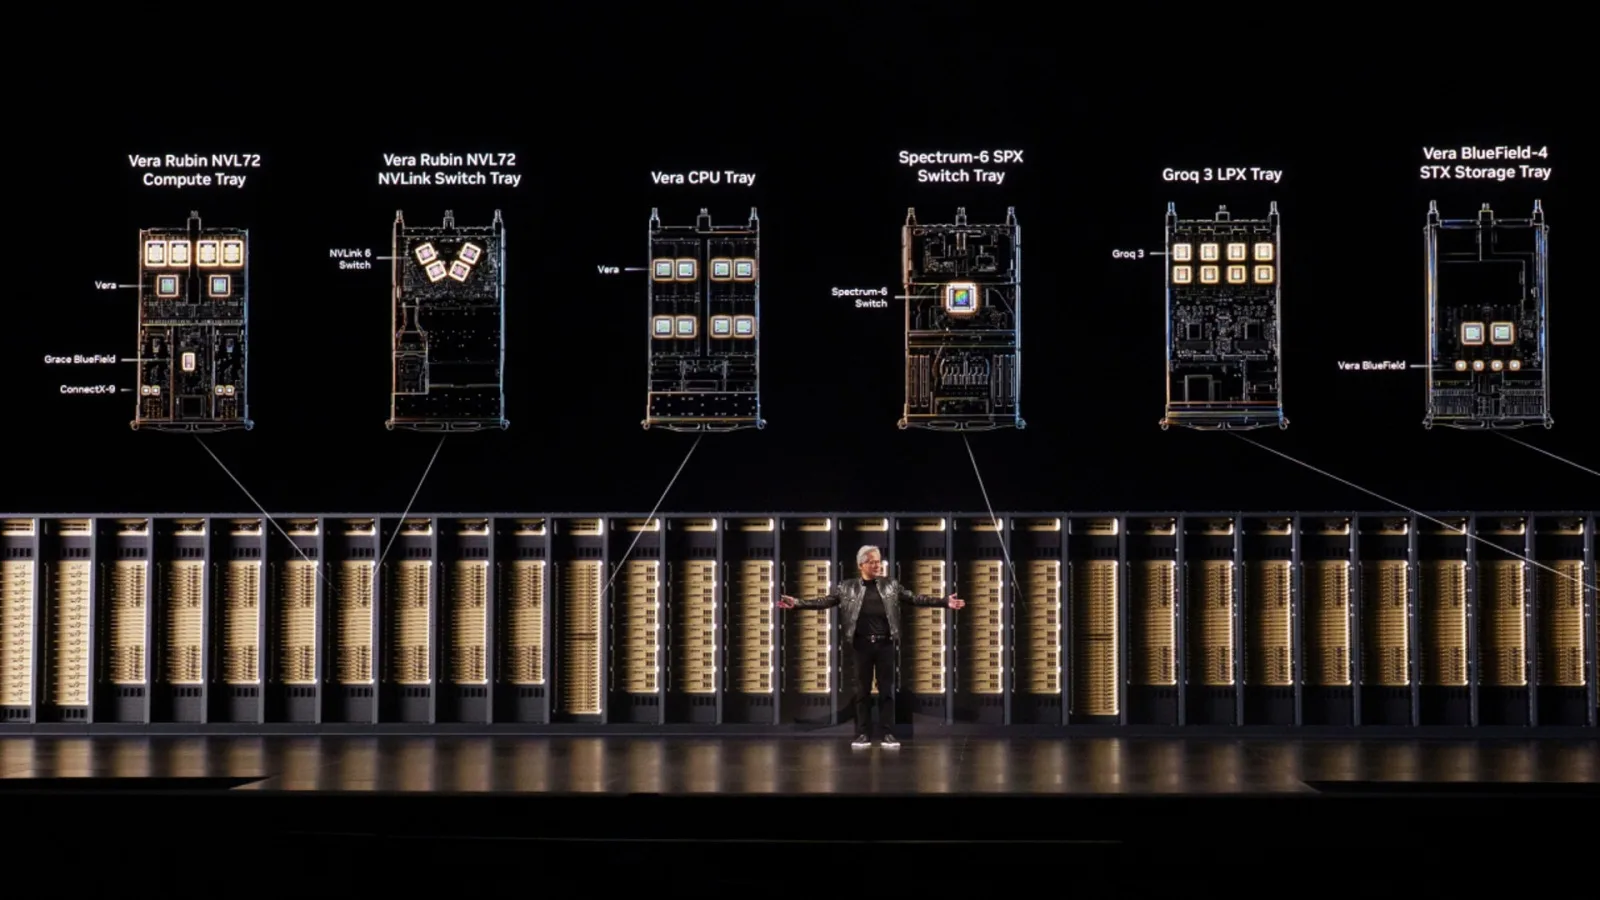
Kuva: NVIDIA · Lähde
NVIDIA vastaa tekoälyn kasvaviin GPU-muistivaatimuksiin koko pino -koodisuunnittelulla, optimoimalla muistin käyttöä laitteistossa ja ohjelmistossa lisätäkseen läpäisykykyä ja tehokkuutta rajatusta suuren kaistanleveyden muistista huolimatta.
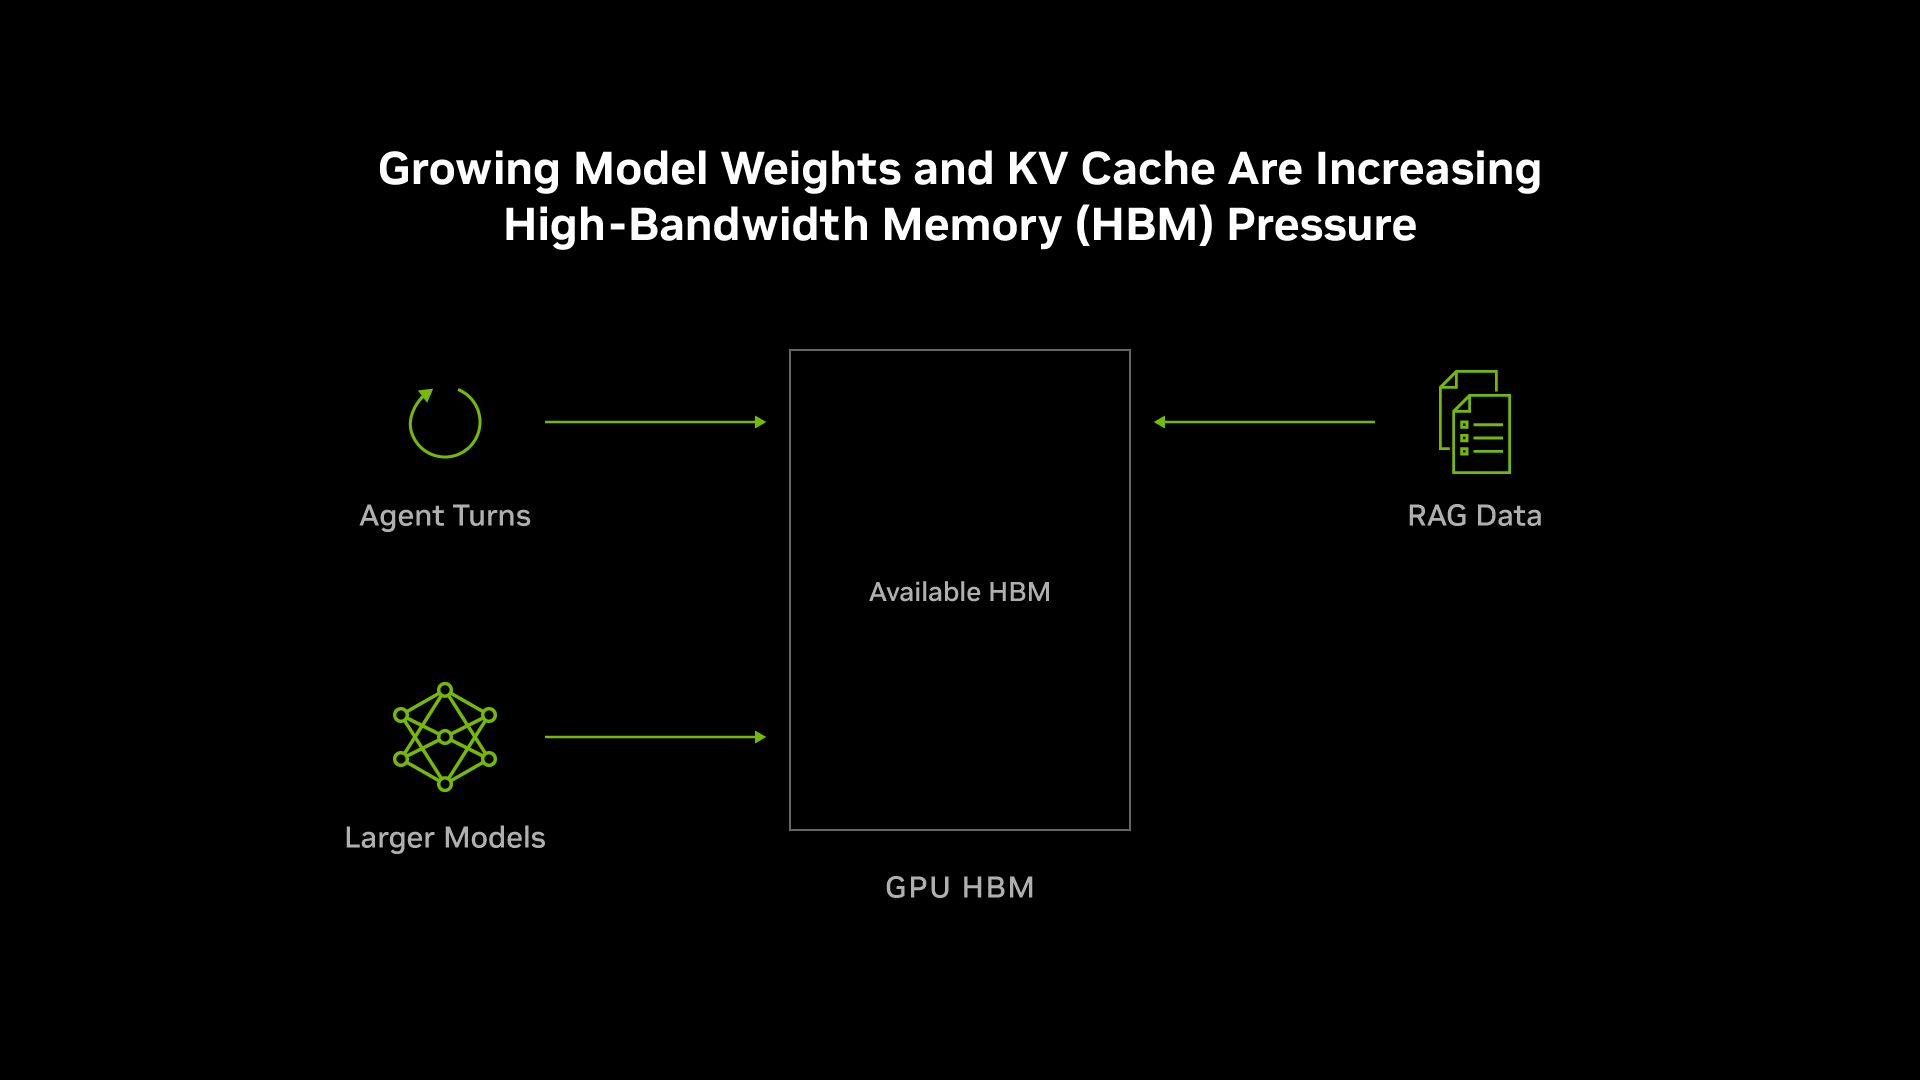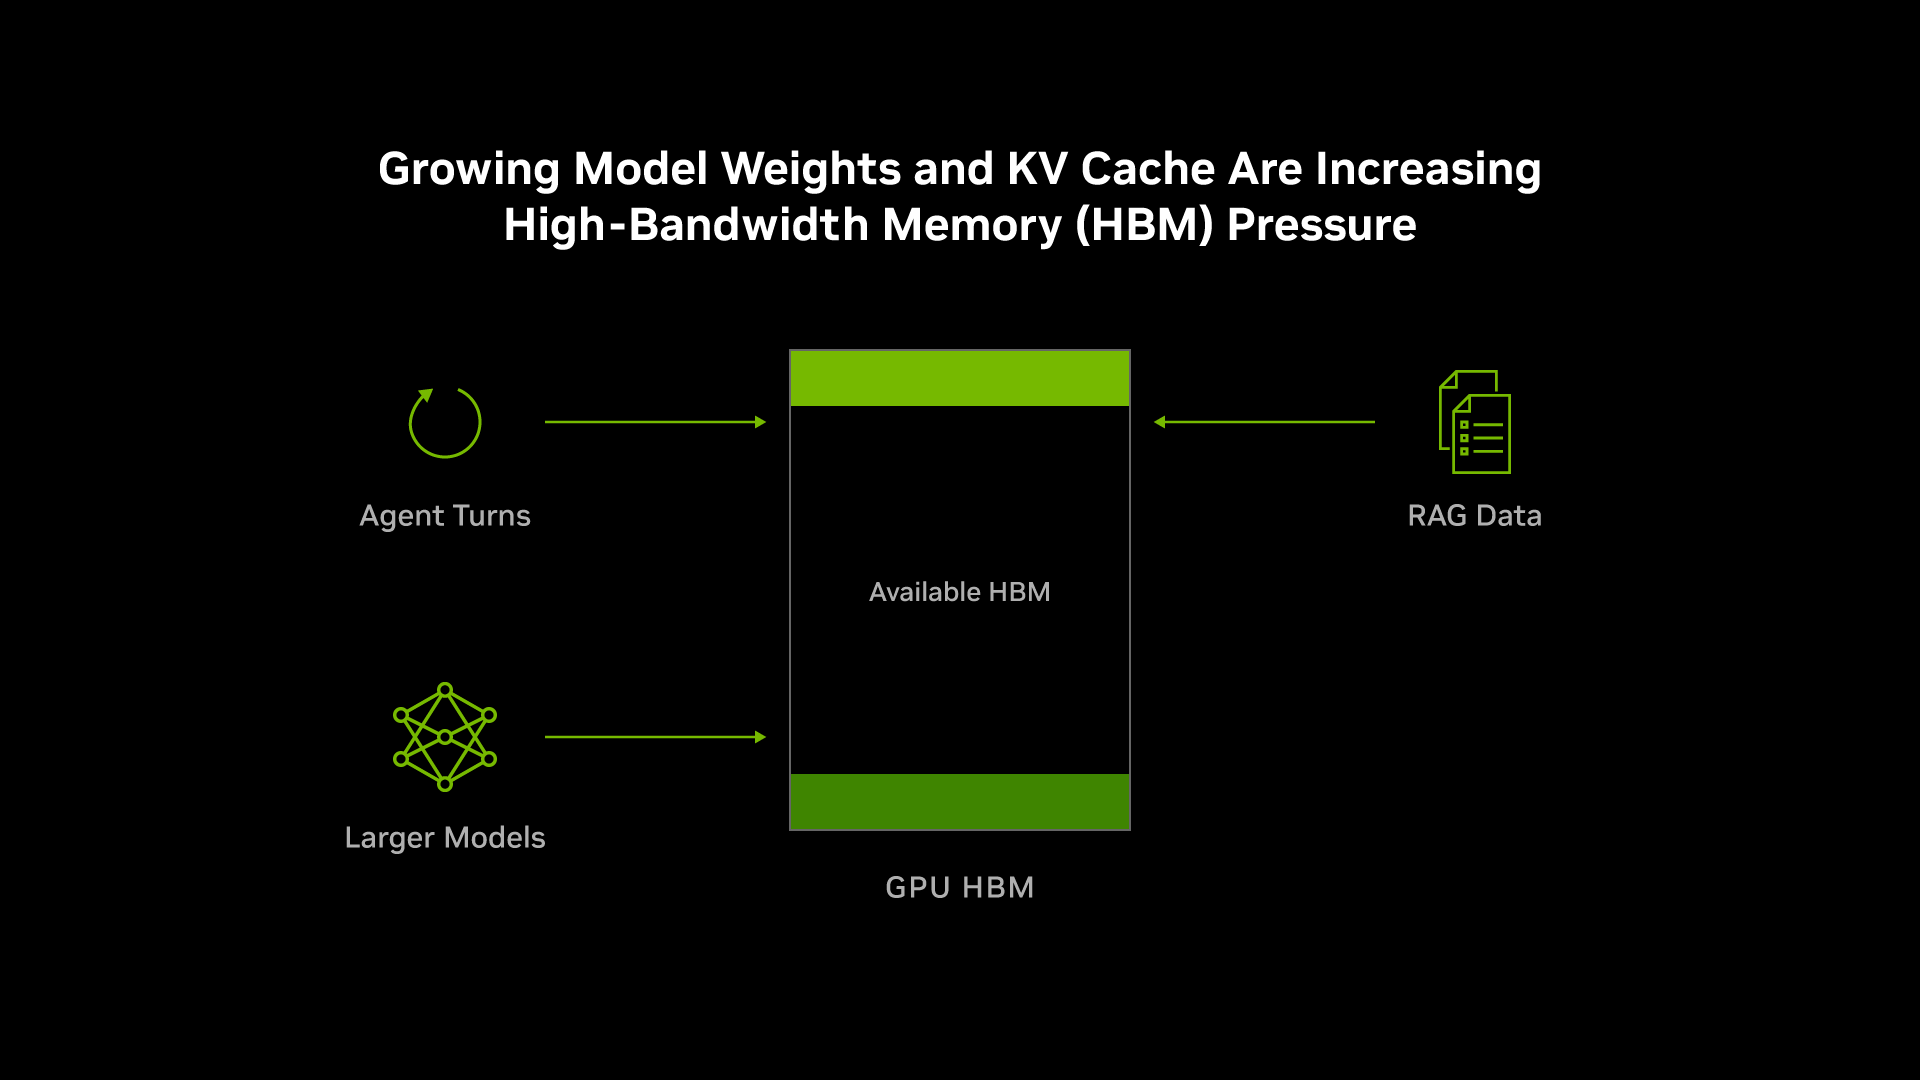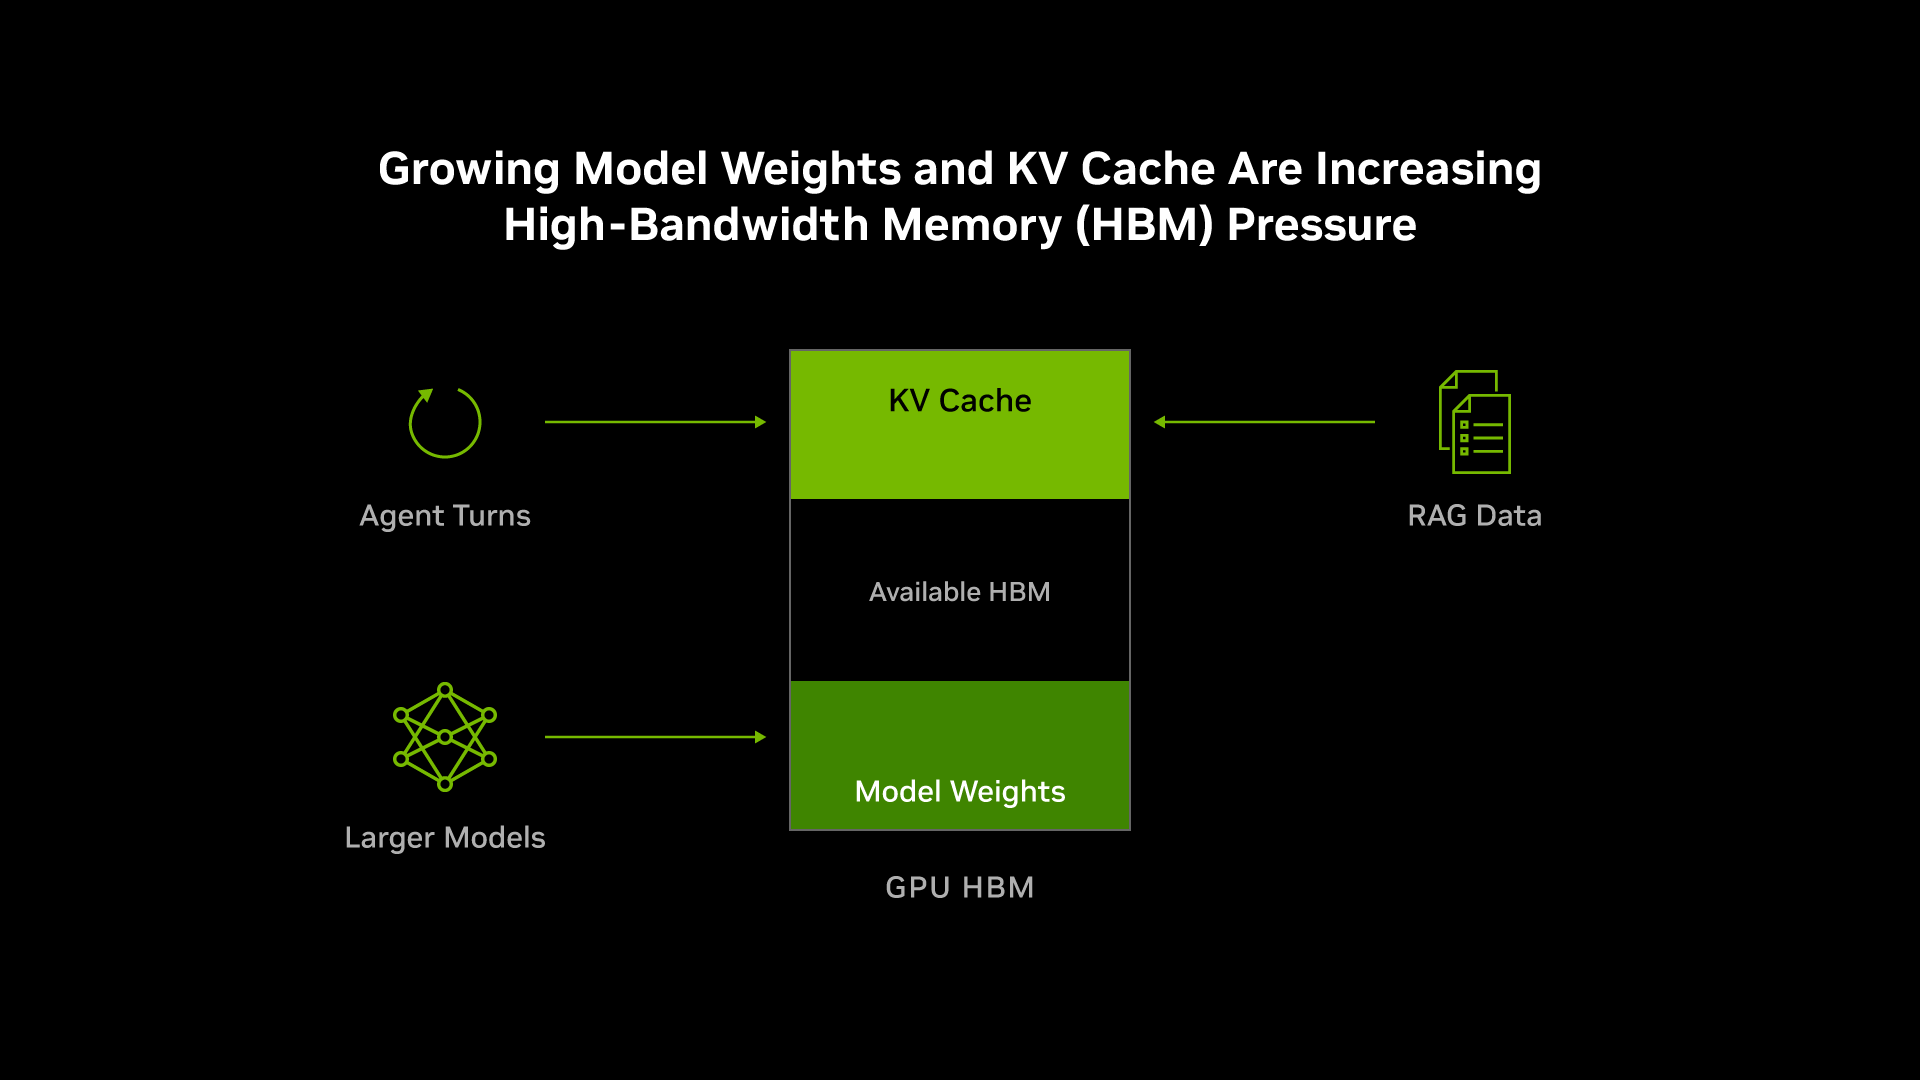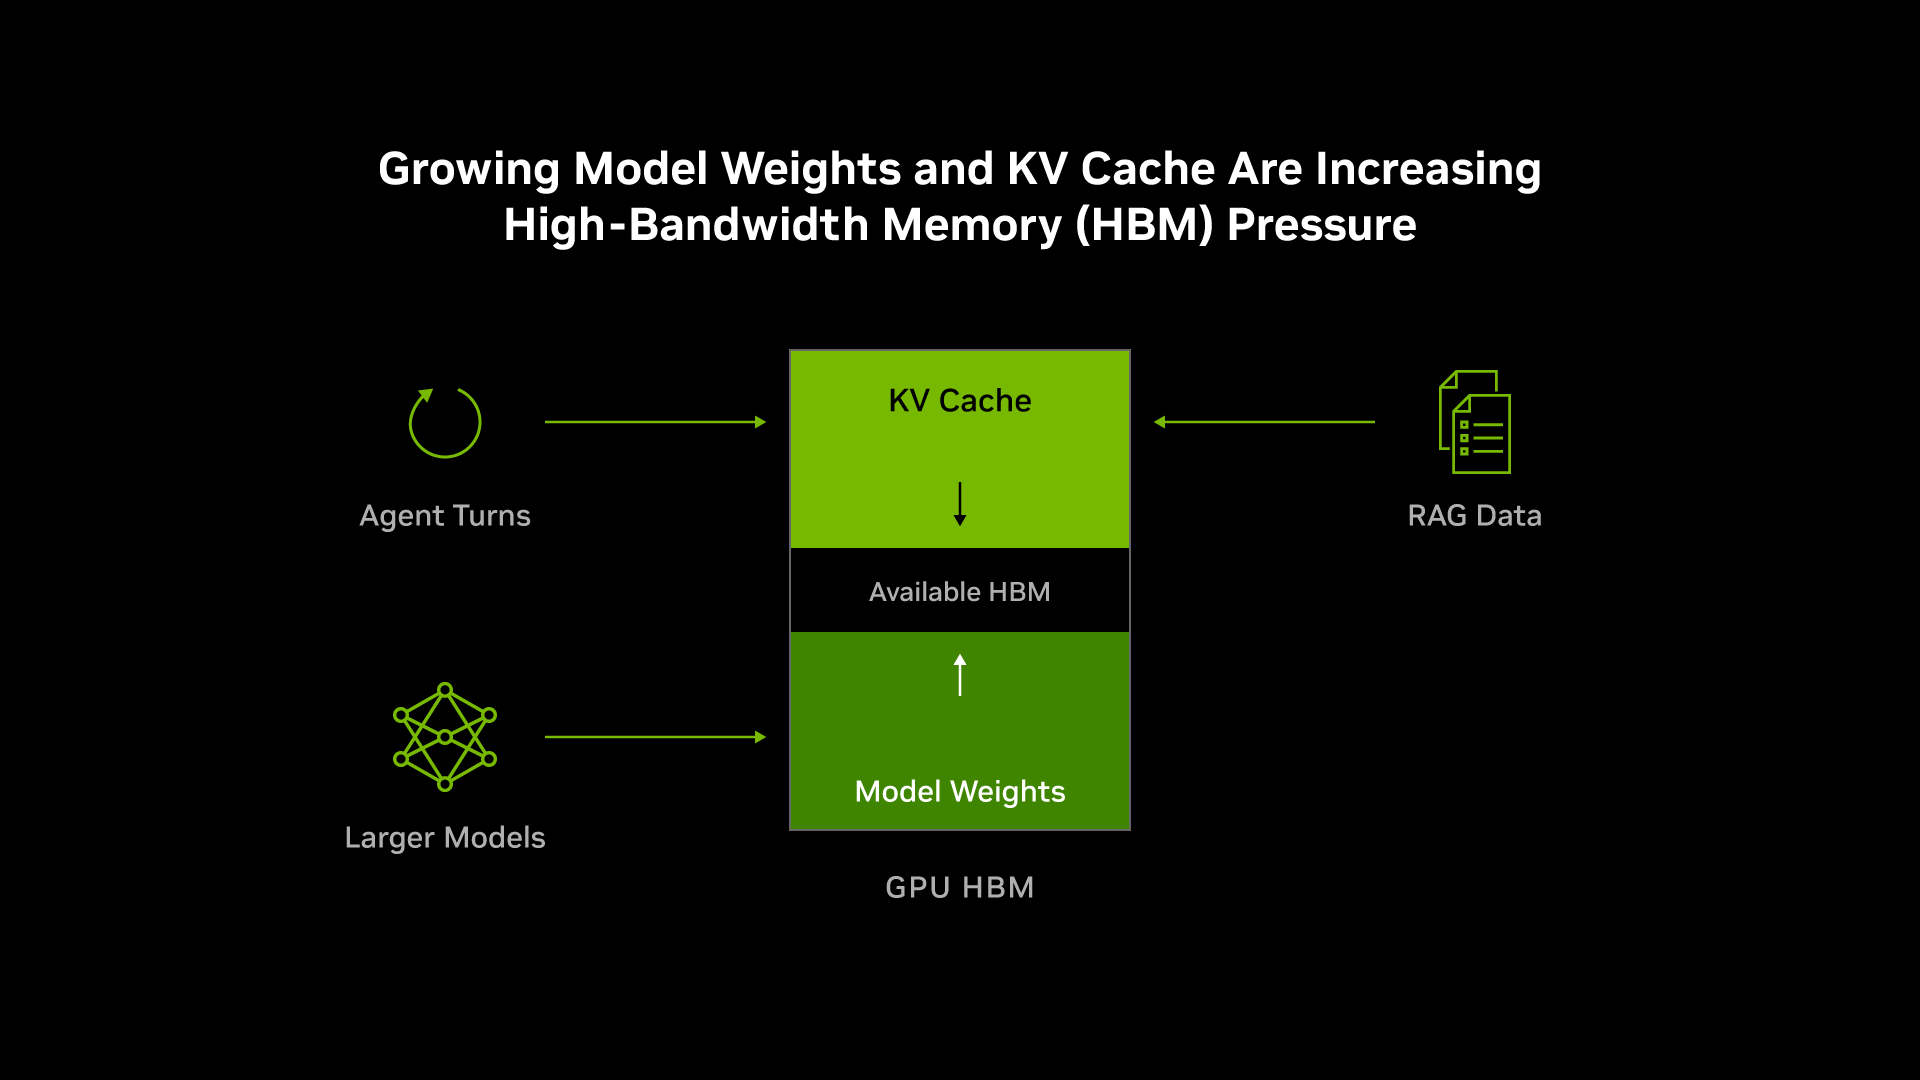
Kun tekoälymallit monimutkaistuvat – sisältäen biljoonia parametreja, pidempiä kontekstiikkunoita ja entistä agenttipohjaisempia päättelytehtäviä – GPU:n suuren kaistanleveyden muistin (HBM) tarve kiihtyy. NVIDIA korostaa, että tämä kasvava paine kohtaa rajoitetun muistin tarjonnan ja nousevat hinnat, haasteen, jonka ennakoidaan jatkuvan lähitulevaisuudessa.
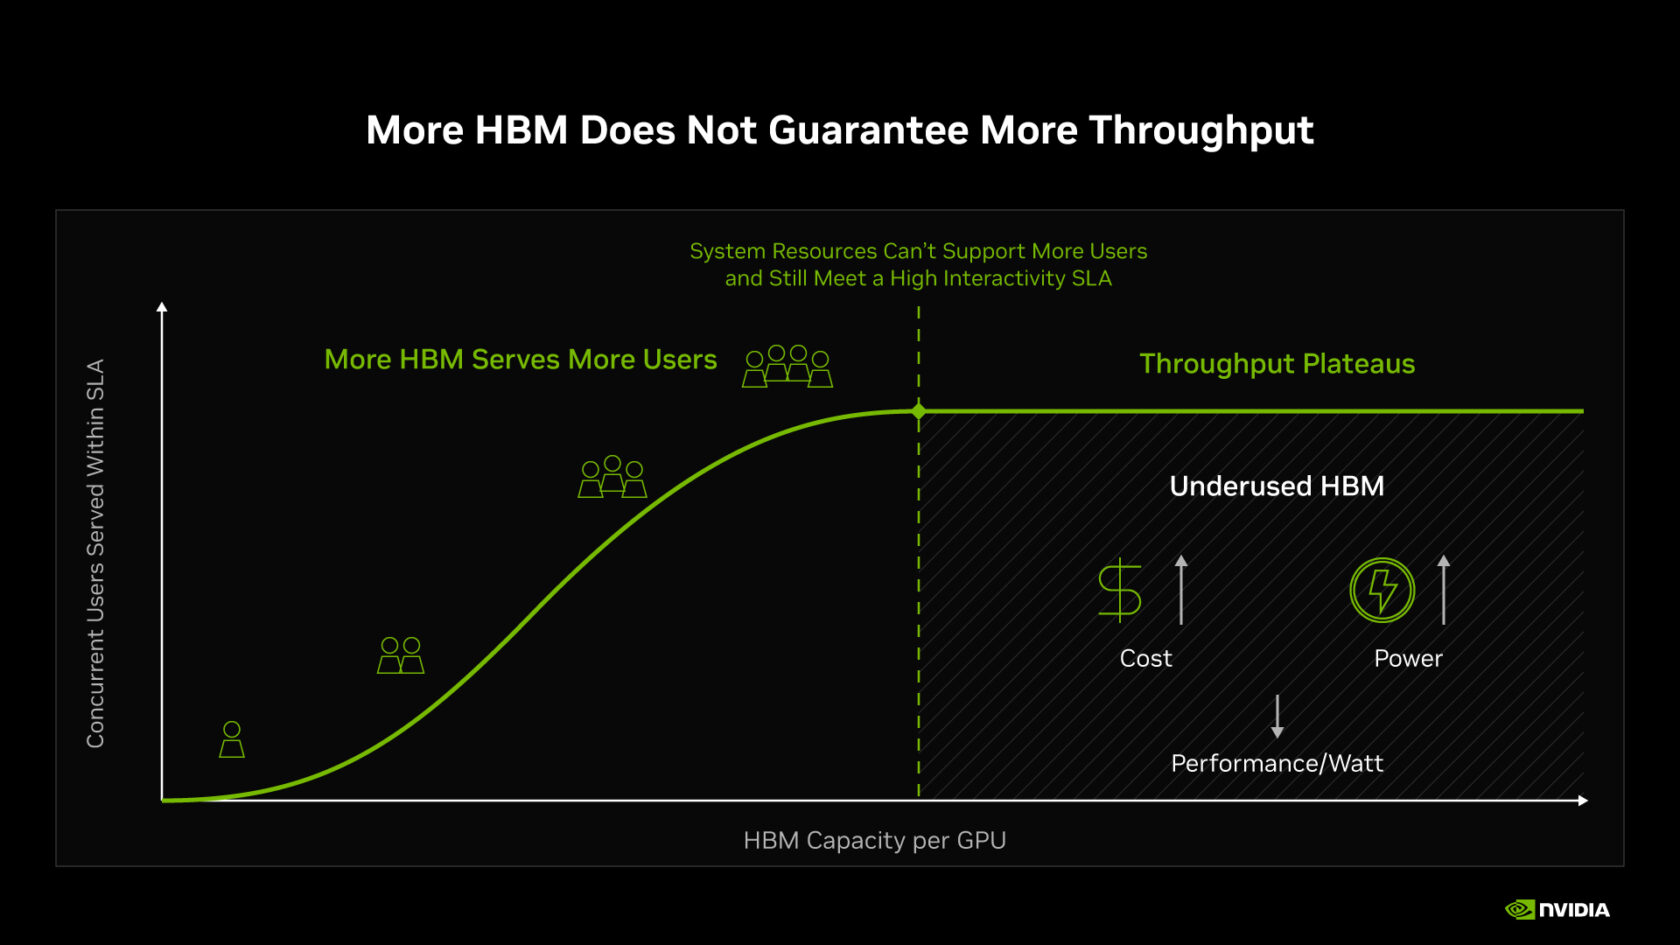
Sen sijaan, että pelkästään lisättäisiin HBM-kapasiteettia, mikä kohtaa fyysiset ja kustannukselliset rajoitteet, NVIDIA keskittyy koko pinon koodisuunnitteluun. Tämä strategia tarkoittaa GPU-laitteiston, CPU:iden, verkkoyhteyksien, tallennusjärjestelmien ja ohjelmistojen yhteen sovittamista maksimoidakseen muistin tehokkaan käytön kaikilla tekoälyprosessointiputken tasoilla – jota kutsutaan tekoälytehtaaksi.
Näissä tekoälytehtaissa on muistihierarkia: nopein ja kallein kerros on GPU:n HBM, joka tallentaa mallipainot ja avain-arvo (KV) välimuistin, joka pitää aktiivista kontekstia. Tämän alapuolella ovat tilavat mutta hitaammat CPU-muisti, paikalliset SSD:t ja jaettu tallennus – jotka vaihtavat nopeuden kapasiteettia ja kustannustehokkuutta vastaan. Tavoitteena on vähentää kalleimmassa kerroksessa säilytettävän datan määrää, siirtää passiivinen data edullisempiin tasoihin ja ennakoida data nopeasti takaisin GPU:hin, parantaen näin läpäisykykyä ja vähentäen viivettä.
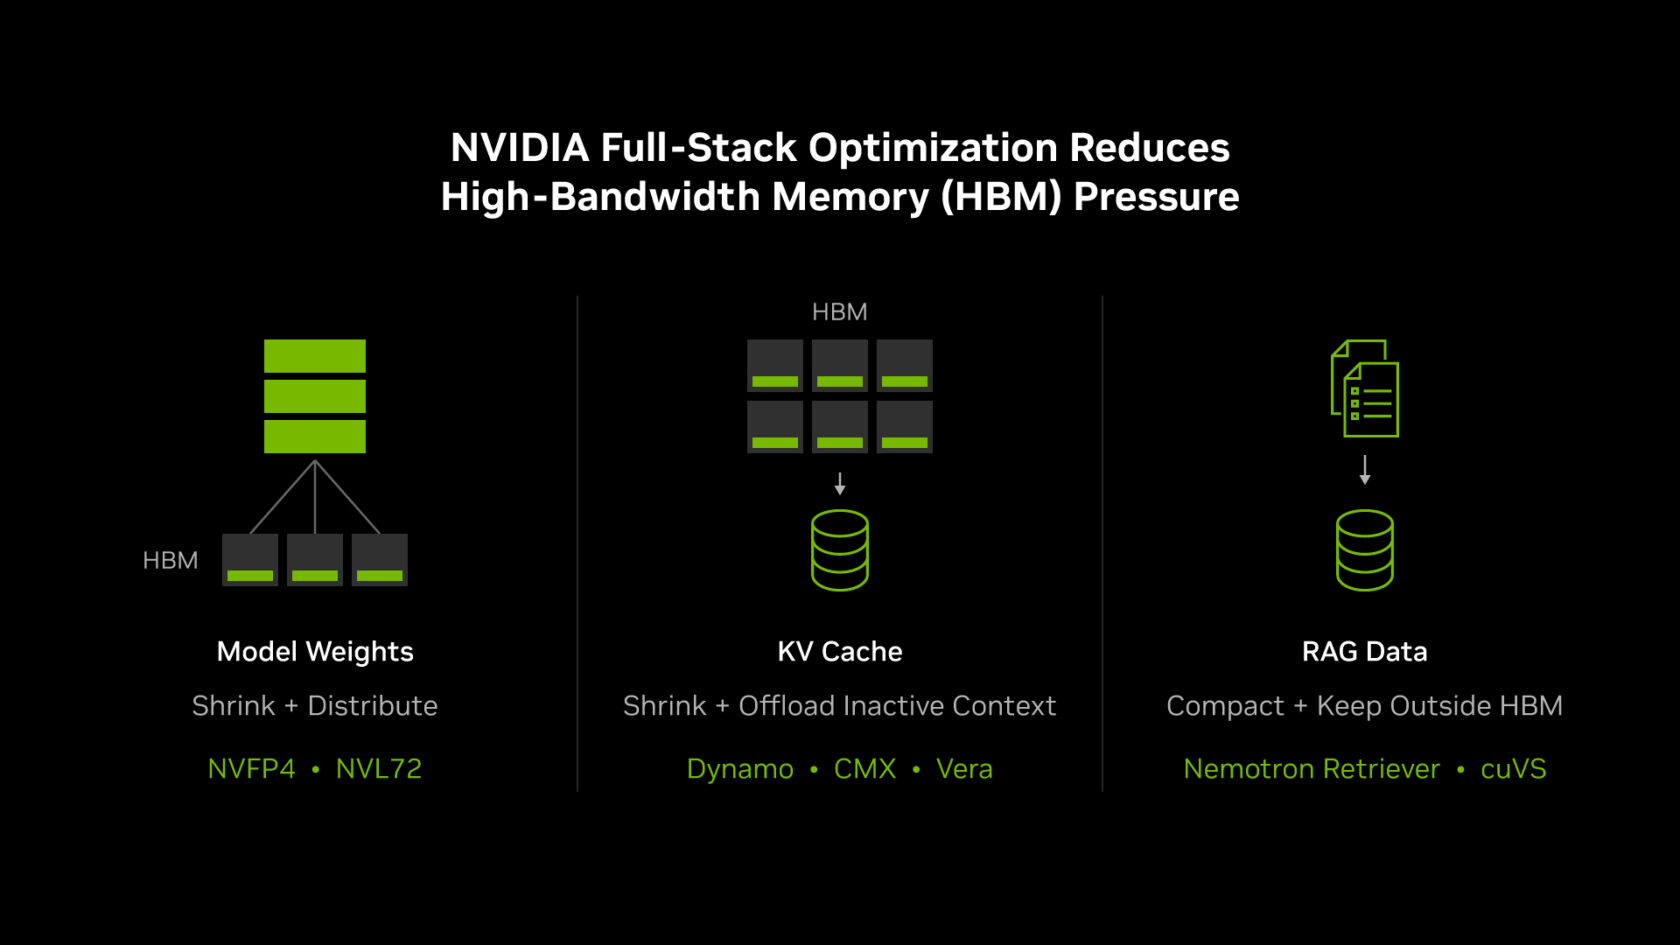
NVIDIAn lähestymistapa sisältää useita innovaatioita. Ensiksi, NVFP4-nimisen 4-bittisen liukulukumuodon käyttöönotto auttaa kutistamaan mallipainoja ja KV-välimuisteja, vähentäen muistijalanjälkeä. Koko mallin jakaminen jopa 72 GPU:n kesken NVL72-järjestelmässä vapauttaa enemmän HBM:ää KV-välimuistille ja käyttäjien samanaikaiselle käytölle.
Toiseksi, passiivinen KV-välimuistikonteksti voidaan siirtää kallista HBM:ää edullisempiin suuriin CPU:hon kytkettyihin muisteihin tai jaetun tallennuksen tasoihin käyttämällä uutta NVIDIA Dynamo -päätteiden suorituskykyohjelmistoa ja CMX-kontekstimuistoratkaisuja. Tämä ohjelmisto hallinnoi KV-välimuistia GPU-muistin, CPU-muistin ja tallennuksen välillä mahdollistaen datan nopean uudelleenkäytön ilman, että kaikki data on jatkuvasti HBM:ssä.
Kolmanneksi, hakuun perustuvat generointitekniikat (RAG) vähentävät HBM:n kuormitusta pitämällä suuret yritystietokannat poissa GPU:lta. Sen sijaan NVIDIAn Nemotron Retriever tuottaa kompakteja vektoriupotuksia ja cuVS-kirjasto hallitsee haettavaa indeksiä CPU- ja tallennustasoilla. Vain olennaiset kohdat pääsevät korkeanopeuksiseen GPU-kontekstiin.
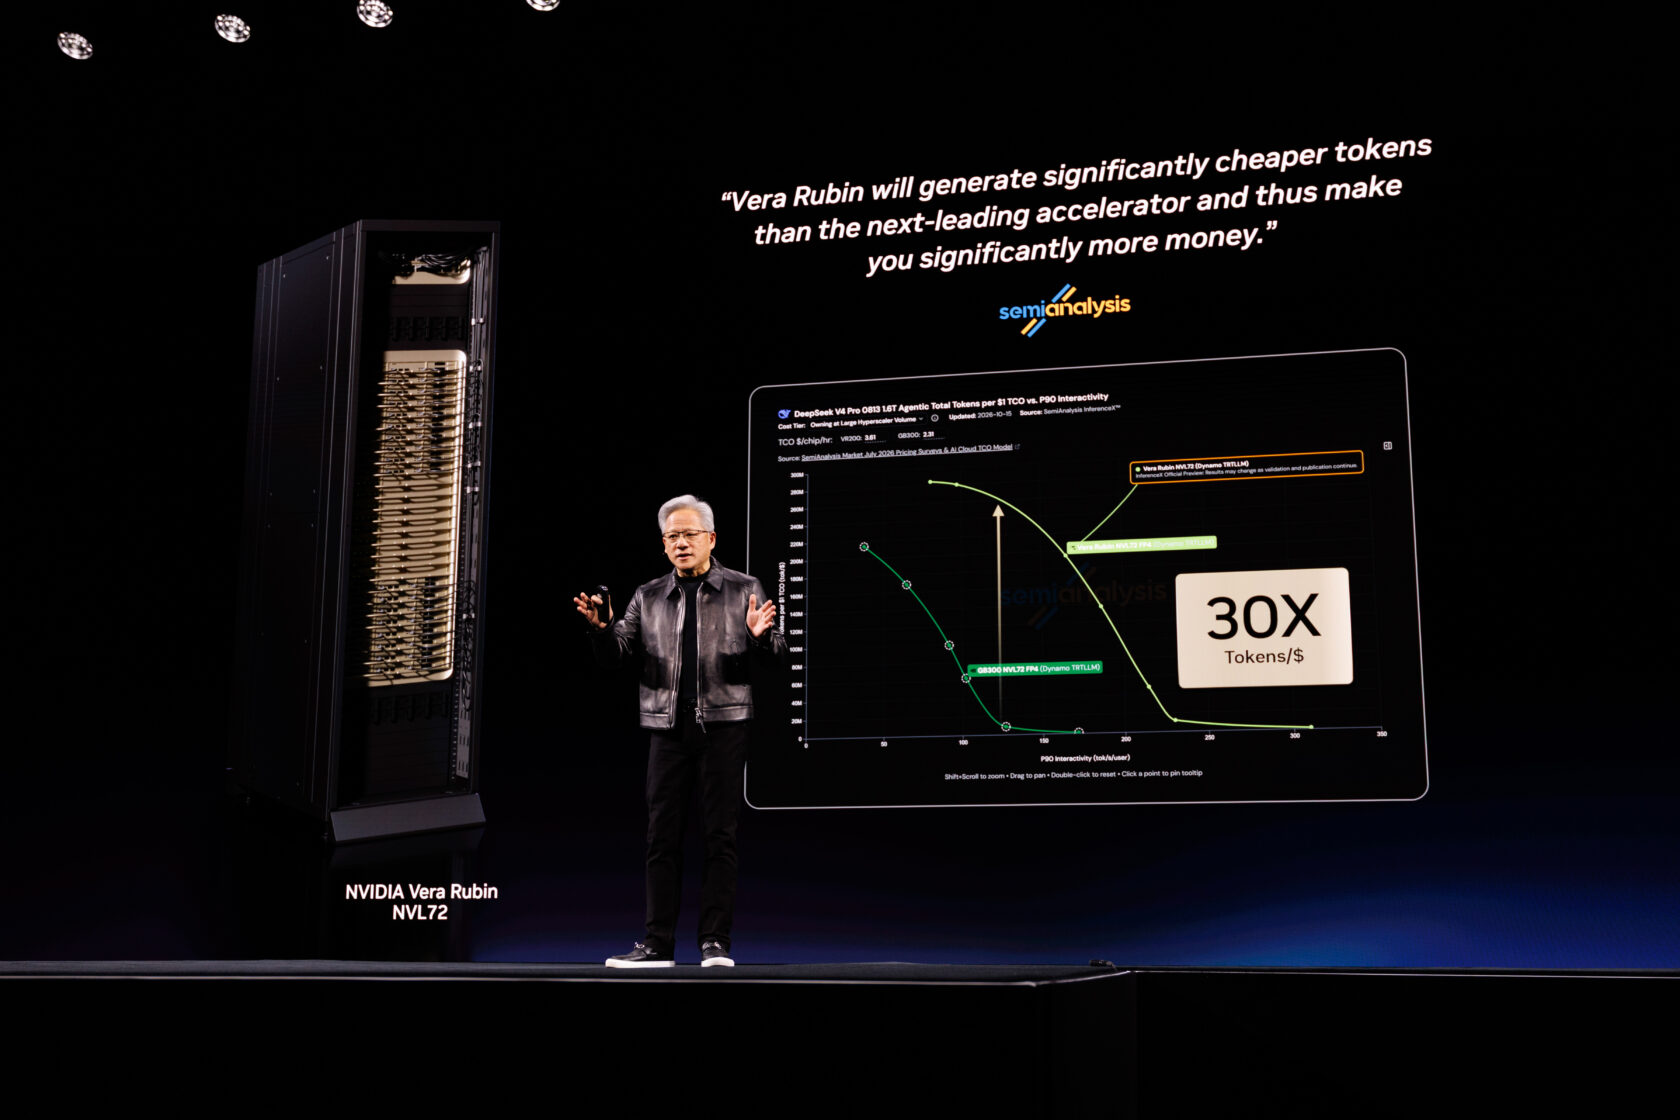
NVIDIA raportoi, että nämä yhdistetyt optimoinnit ovat johtaneet noin 3 % kasvuun HBM-kapasiteetissa per GPU NVIDIA Blackwell Ultra -alustalta Vera Rubin -alustalle, mutta ovat tuottaneet jopa 30-kertaisen agenttiperustaisen läpäisykyvyn per dollari testikuormissa kuten SemiAnalysis AgentX.
Ratkaisemalla muistin kaistanleveyden rajoituksia – niin kutsutun muurimuistin ongelman – NVIDIAn koko pinon koodisuunnittelu mahdollistaa tekoälyn työkuormien suorittaa enemmän hyödyllisiä laskelmia muistibittiä kohti, vähentäen energiankulutusta ja kustannuksia. Tämä kokonaisvaltainen muistinhallintastrategia merkitsee siirtymää raakamuistikapasiteetin kasvattamisesta kohti tehokkuuden orkestrointia laitteisto- ja ohjelmistokerroksissa tekoälyn kasvavien tarpeiden edessä.
Yksityiskohtaisemman teknisen ymmärryksen saamiseksi NVIDIA tarjoaa videoesityksen ja syväluotaavan tarkastelun siitä, miten koko pinon koodisuunnittelu vähentää päättelymuistin painetta ja parantaa tekoälyalustan taloudellisuutta.
Lähteet ja alkuperäiset raportit
Lue alkuperäinen lähde ↗
Kommentit (0)
Ei vielä kommentteja. Aloita keskustelu.
Kirjoita kommentti
Kommentit julkaistaan moderoinnin jälkeen. Nimesi ja kommenttisi näkyvät julkisesti. Tili