
Tekoälyn edistysas mahdollistaa luonnollisen kielen proteiini- ja genomin suunnittelutyökalut
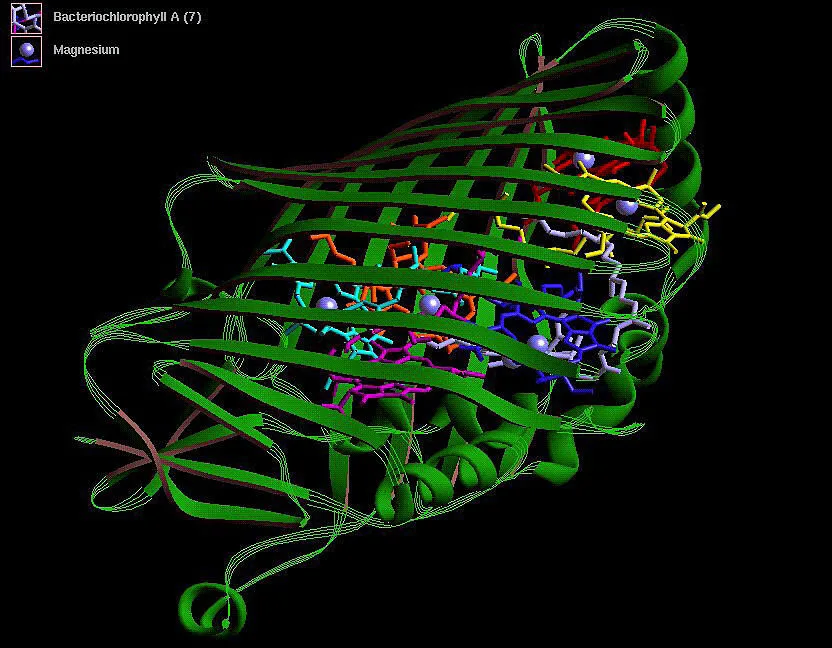
Kuva: Ars Technica · Lähde
Uudet tekoälytyökalut antavat käyttäjille mahdollisuuden suunnitella proteiineja ja DNA-sekvenssejä luonnollisen kielen kehotteilla, yksinkertaistaen biomolekyylien suunnittelun monimutkaista prosessia, vaikka onnistumisprosentit ovat edelleen alhaisia ja asiantuntijoiden validointi välttämätöntä.
Viimeaikaiset tekoälyn kehitysaskeleet ovat avanneet tien uusille työkaluille, jotka yksinkertaistavat proteiinien ja genomin suunnittelua sallimalla käyttäjien syöttää luonnollisen kielen kuvauksia yksityiskohtaisten biokemiallisten spesifikaatioiden sijaan. Perinteisesti proteiinien suunnittelu vaatii monimutkaista tietämystä entsyymimekanismeista sekä aminohappojen ja ympäröivien molekyylien tarkasta sijoittelusta.
Nykyiset tekoälyratkaisut edellyttävät käyttäjiltä teknistä rakenteellisten rajoitteiden määrittelyä, mikä rajoittaa käytettävyyden asiantuntijoihin, jotka hallitsevat proteiinikemian.
Kiinalainen laaja tutkimusyhteistyö kehitti työkalun nimeltä Pinal, joka hyödyntää luonnollisen kielen prosessointia tulkitakseen tavankielisiä kehotteita kuvaamaan haluttuja proteiinitoimintoja. Sen sijaan, että käyttäjät manuaalisesti tarjoaisivat aminohappojen konfiguraatioita tai rakenteellisia yksityiskohtia, he voivat kuvata kohdefunktioita—kuten entsymaattista aktiivisuutta tai fluoresenssia—ja Pinal tuottaa ehdokkaita proteiinisekvenssejä suunniteltuina täyttämään nämä tehtävät. Järjestelmä yhdistää teksti-rakenteeksi -moduulin T2struct ja aminohapposekvenssien generaattorin SAProt-T laajojen proteiinidatabassien ja AlphaFoldin ennustamien rakenteiden avulla koulutukseen.
Tutkijat demonstroivat Pinalin kykyä suunnitella erilaisia proteiineja, mukaan lukien fluoresoiva proteiini, joka on toiminnaltaan samanlainen mutta sekvenssiltään erilainen kuin vihreä fluoresoiva proteiini (GFP). Kymmenistä tuhansista laskennallisista ennusteista vain pieni määrä tuotettiin ja kokeellisesti testattiin; yksi niistä osoitti halutun fluoresenssin. Vaikka tämä osoittaa alhaisen onnistumisprosentin, se kuvastaa haasteen vaikeutta ja tiukkoja suodatuskriteerejä.
Täydennyksenä toinen Hugging Face:n ja akateemisten kumppaneiden tiimi esitteli Carbon X:n, DNA-painotteisen mallin, joka yhdistää ihmiskielentulkinnan genomiseen sekvenssien ennustamiseen. Tämä malli pystyy tulkitsemaan ja tuottamaan DNA-sekvenssejä luonnollisen kielen kehotteiden perusteella, kääntämään englannin ja DNA:n välillä sekä ennustamaan tiettyjen mutaatioiden vaikutukset sekvenssiin. Carbon X voi toimia paikallisessa laitteistossa, kuten MacBookissa, tarjoten kustannus- ja yksityisyysetuja kaupallisiin pilvipalveluihin verrattuna.
Näistä innovaatioista huolimatta luonnollisen kielen kehotteiden käyttö biomolekyylien suunnittelussa ei poista tarvetta alaosaamisen asiantuntemukselle. Tutkijat tarvitsevat edelleen kehittyneitä laboratoriomenetelmiä tekoälyn generoimien ehdokkaiden kokeelliseen validointiin ja hienosäätöön. Lisäksi nämä työkalut tuottavat joskus väärää positiivista ja kuviteltuja tuloksia, mikä vaatii huolellista tulkintaa.
Teknisiä esteitä madaltamalla nämä tekoälytyökalut lupaavat nopeuttaa biologista tutkimusta ja tehdä biomolekyylien suunnittelusta helpommin saavutettavaa. Kun järjestelmät kehittyvät, ne voivat tulla arvokkaiksi kumppaneiksi kokeellisille biologeille tehostaen työnkulkuja tarjoamalla intuitiivisia rajapintoja, jotka ymmärtävät käyttäjän aikomuksen luonnollisesta kielestä. Kuitenkin laajempi käyttöönotto ja käytännön hyöty laboratoriotyössä määräävät niiden lopullisen vaikutuksen alaan.
Lähteet ja alkuperäiset raportit
Lue alkuperäinen lähde ↗
Kommentit (0)
Ei vielä kommentteja. Aloita keskustelu.
Kirjoita kommentti
Kommentit julkaistaan moderoinnin jälkeen. Nimesi ja kommenttisi näkyvät julkisesti. Tili