
AI-framsteg möjliggör designverktyg för proteiner och genom med naturligt språk
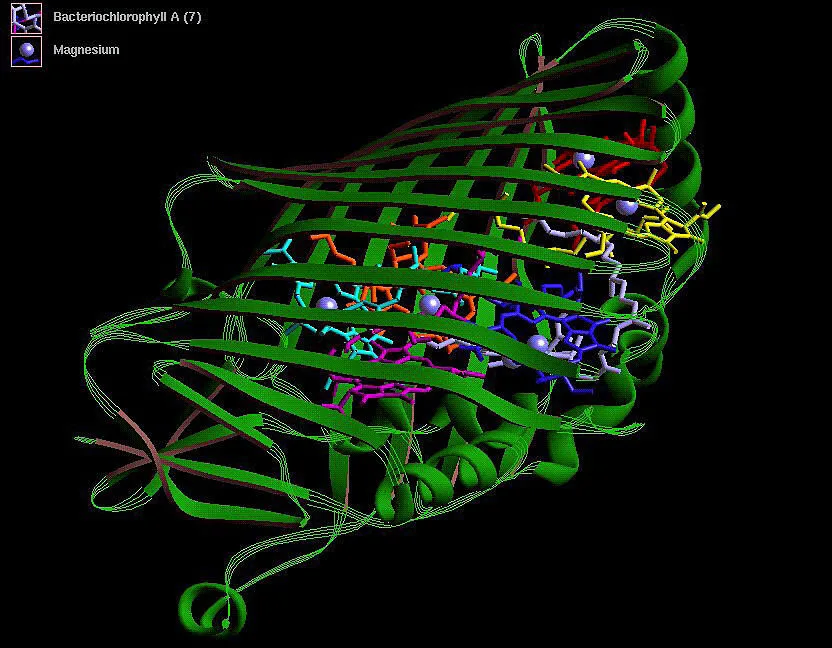
Bild: Ars Technica · Källa
Nya AI-verktyg låter användare designa proteiner och DNA-sekvenser med naturliga språkkommandon, vilket förenklar den komplexa processen av biomolekylär design, även om framgångsgraden fortfarande är låg och expertvalidering är avgörande.
Senaste framsteg inom artificiell intelligens har banat väg för nya verktyg som förenklar protein- och genomdesign genom att låta användare mata in beskrivningar på naturligt språk istället för detaljerade biokemiska specifikationer. Traditionellt kräver proteindesign ingående kunskap om enzymmekanismer och exakt positionering av aminosyror och omgivande molekyler. Existerande AI-lösningar kräver att användare preciserar strukturella begränsningar på ett tekniskt sätt, vilket begränsar användbarheten till experter väl insatta i proteinkemi.
Ett stort forskningssamarbete baserat i Kina utvecklade ett verktyg kallat Pinal, som utnyttjar naturlig språkbehandling för att tolka vardagliga beskrivningar av önskade proteinfunktioner. Istället för att manuellt specificera aminosyrakonfigurationer eller strukturella detaljer kan användare beskriva målade funktioner — som enzymatisk aktivitet eller fluorescens — och Pinal genererar kandidatproteinsekvenser designade för att uppfylla dessa roller. Systemet kombinerar en text-till-struktur-modul, T2struct, med en aminosyrasekvensgenerator, SAProt-T, som använder omfattande proteindatabaser och Alphafold-predicerade strukturer för träning.
Forskarna demonstrerade Pinal genom att ge det uppgiften att designa en mängd olika proteiner, inklusive ett fluorescerande protein med liknande funktion men skilt sekvens från grönt fluorescerande protein (GFP). Av tiotusentals beräknade förutsägelser producerades och testades endast ett fåtal experimentellt; en visade önskad fluorescens. Detta indikerar en låg framgångsgrad men speglar svårigheten i utmaningen och de strikta filtreringskriterierna som användes.
Kompletterande detta introducerade ett annat team från Hugging Face och akademiska partners Carbon X, en DNA-fokuserad modell som integrerar mänsklig språkförståelse med genomsekvensprediktion. Denna modell kan tolka och generera DNA-sekvenser baserat på naturliga språkkommandon, översätta mellan engelska och DNA samt förutsäga sekvenskonsekvenser av specifika mutationer. Carbon X kan köras på lokal hårdvara, såsom en MacBook, vilket erbjuder kostnads- och sekretessfördelar jämfört med kommersiella molnbaserade system.
Trots dessa innovationer eliminerar användningen av naturliga språkkommandon inom biomolekylär design inte behovet av domänexpertis. Forskare behöver fortfarande avancerade laboratorietekniker för att experimentellt validera och förfina de AI-genererade kandidaterna. Dessutom producerar dessa verktyg ibland falska positiva och hallucinerade resultat, vilket kräver noggrann tolkning.
Genom att sänka tekniska trösklar håller dessa AI-verktyg på att påskynda biologisk forskning och göra biomolekylär design mer tillgänglig. När dessa system utvecklas kan de bli värdefulla följeslagare för experimentbiologer och effektivisera arbetsflöden genom att erbjuda intuitiva gränssnitt som tolkar användarens intentioner från naturligt språk. Men brett genomslag och dokumenterad nytta i laboratoriemiljö avgör deras slutgiltiga påverkan på fältet.
Källor och ursprunglig rapportering
Läs den ursprungliga källan ↗
Kommentarer (0)
Inga kommentarer ännu. Börja diskussionen.
Skriv en kommentar
Kommentarer publiceras efter granskning. Ditt namn och kommentar syns offentligt. Konto