
AI-framsteg muliggjør verktøy for design av proteiner og genomer med naturlig språk
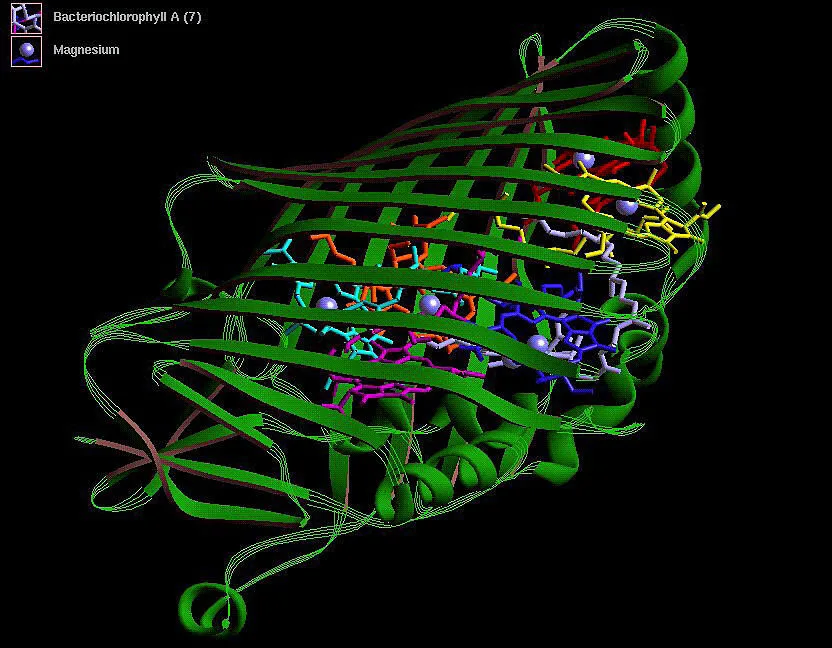
Bilde: Ars Technica · Kilde
Nye AI-verktøy lar brukere designe proteiner og DNA-sekvenser ved hjelp av naturlige språkkommandoer, noe som forenkler den komplekse prosessen med biomolekylær design, men suksessraten er fortsatt lav og faglig validering er nødvendig.
Siste fremskritt innen kunstig intelligens har åpnet for nye verktøy som forenkler design av proteiner og genomer ved å la brukere skrive inn beskrivelser med naturlig språk i stedet for detaljerte biokjemiske spesifikasjoner. Tradisjonelt krever proteindesign inngående kunnskap om enzymmekanismer og presis plassering av aminosyrer og omkringliggende molekyler. Eksisterende AI-løsninger krever at brukeren angir strukturelle begrensninger på en teknisk måte, noe som begrenser bruken til eksperter godt kjent med proteinkjemi.
Et stort forskningssamarbeid basert i Kina utviklet et verktøy kalt Pinal, som utnytter naturlig språkprosessering for å tolke vanlige språklige beskrivelser av ønskede proteinfunksjoner. I stedet for manuelt å gi aminosyrekonfigurasjoner eller strukturelle detaljer kan brukere beskrive målfunksjoner — for eksempel enzymatisk aktivitet eller fluorescens — og Pinal genererer kandidatsekvenser av proteiner designet for å oppfylle disse rollene. Systemet kombinerer en tekst-til-struktur modul, T2struct, med en aminosyresekvensgenerator, SAProt-T, basert på omfattende proteindatabaser og AlphaFold-forutsagte strukturer for trening.
Forskerne demonstrerte Pinal ved å få det til å designe ulike proteiner, inkludert et fluorescerende protein som fungerer på samme måte, men skiller seg i sekvens fra grønt fluorescerende protein (GFP). Av titusener av beregnede prediksjoner ble kun et fåtall produsert og testet eksperimentelt; ett viste ønsket fluorescens. Selv om dette indikerer lav suksessrate, reflekterer det utfordringen og de strenge filtreringskriteriene som er brukt.
Som et supplement introduserte et annet team fra Hugging Face og akademiske partnere Carbon X, en DNA-fokusert modell som integrerer forståelse av menneskelig språk med genomsekvens-prediksjon. Denne modellen kan tolke og generere DNA-sekvenser basert på naturlige språkkommandoer, oversette mellom engelsk og DNA, samt forutsi sekvenskonsekvenser av spesifikke mutasjoner. Carbon X kan kjøres på lokal maskinvare, for eksempel en MacBook, noe som gir kostnads- og personvernfordeler sammenlignet med kommersielle skybaserte systemer.
Til tross for disse innovasjonene fjerner ikke bruk av naturlige språkkommandoer innen biomolekylær design behovet for fagkompetanse. Forskere trenger fortsatt avanserte laboratorieteknikker for å validere og finjustere de AI-genererte kandidatene eksperimentelt. I tillegg produserer disse verktøyene noen ganger falske positive og hallusinerte resultater, noe som krever nøye tolkning.
Ved å senke tekniske barrierer, lover disse AI-verktøyene å akselerere biologisk forskning og gjøre biomolekylær design mer tilgjengelig. Etter hvert som disse systemene utvikles, kan de bli verdifulle følgesvenner for eksperimentelle biologer, og effektivisere arbeidsflyter ved å tilby intuitive grensesnitt som tolker brukernes hensikt fra naturlig språk. Men bred adopsjon og dokumentert nytte i laboratoriemiljøet vil avgjøre deres endelige innvirkning på feltet.
Kilder og originalrapportering
Les originalkilden ↗
Kommentarer (0)
Ingen kommentarer ennå. Start diskusjonen.
Skriv en kommentar
Kommentarer publiseres etter moderering. Ditt navn og kommentar vil være synlige offentlig. Konto