
Mākslīgā intelekta attīstība ļauj izmantot dabiskās valodas rīkus proteīnu un genoma dizainam
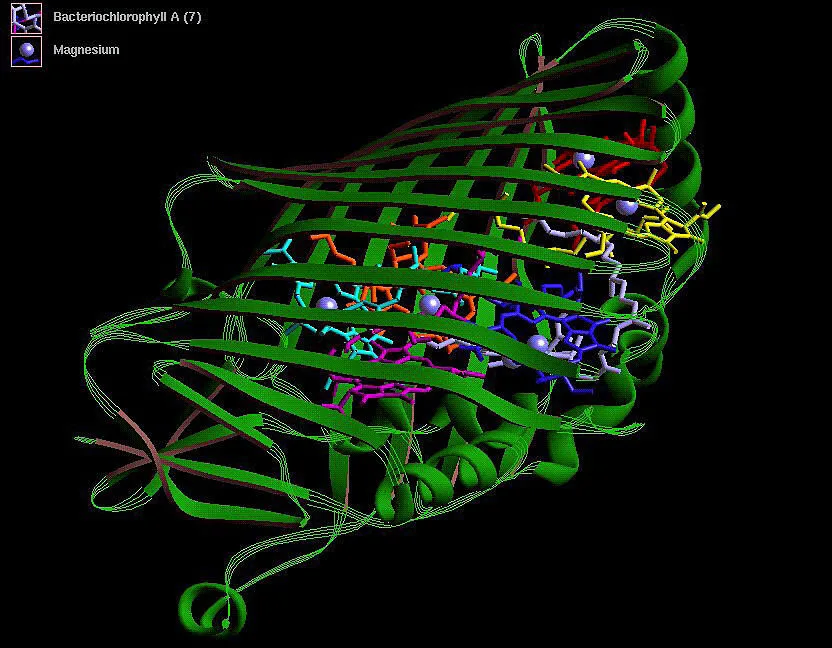
Attēls: Ars Technica · Avots
Jauni mākslīgā intelekta rīki ļauj lietotājiem izstrādāt proteīnus un DNS secības, izmantojot dabiskās valodas komandas, vienkāršojot biomolekulārā dizaina sarežģīto procesu, lai gan panākumu līmenis joprojām ir zems un nepieciešama ekspertu pārbaude.
Nesenie mākslīgā intelekta sasniegumi ir radījuši jaunas iespējas vienkāršot proteīnu un genoma projektēšanu, ļaujot lietotājiem ievadīt dabiskās valodas aprakstus vietā tehniskām bioķīmiskām specifikācijām. Tradicionāli proteīnu dizains prasa padziļinātas zināšanas par fermentu mehānismiem un precīzu aminoskābju un apkārtējo molekulu pozicionēšanu. Esošie mākslīgā intelekta risinājumi pieprasa lietotājiem tehniski noteikt strukturālos ierobežojumus, kas ierobežo to izmantošanu līdz ekspertiem ar proteīnu ķīmijas zināšanām.
Ķīnā bāzēta lielā pētījumu sadarbība izstrādāja rīku Pinal, kas izmanto dabiskās valodas apstrādi, lai interpretētu vienkāršotās valodās sniegtas instrukcijas par vēlamajām proteīnu funkcijām. Tā vietā, lai manuāli norādītu aminoskābju konfigurācijas vai struktūras detaļas, lietotāji var aprakstīt mērķa funkcijas, piemēram, fermenta aktivitāti vai fluorescenci, un Pinal ģenerē kandidātu proteīnu secības to izpildei. Sistēma apvieno tekstu struktūrā moduļa T2struct ar aminoskābju secību ģeneratoru SAProt-T, izmantojot plašas proteīnu datubāzes un AlphaFold prognozētās struktūras apmācībai.
Pētījumu veicēji demonstrēja Pinal, uzdodot tam izstrādāt dažādus proteīnus, tostarp fluorescējošu proteīnu, kas funkcionāli līdzīgs, taču secienē atšķiras no zaļā fluorescējošā proteīna (GFP). No desmitiem tūkstošu skaitļošanas prognožu tikai neliela daļa tika radīta un eksperimentāli pārbaudīta; viens parādīja vēlamo fluorescenci. Lai gan tas liecina par zemu panākumu līmeni, tas atspoguļo šī izaicinājuma sarežģītību un stingros atlases kritērijus.
Papildus tam citai komandai no Hugging Face un akadēmiskajiem partneriem tika ieviests Carbon X, DNS orientēts modelis, kas apvieno cilvēka valodas izpratni ar genoma secību paredzēšanu. Šis modelis spēj interpretēt un ģenerēt DNS secības, pamatojoties uz dabiskās valodas komandām, tulkot starp angļu un DNS valodu, kā arī prognozēt sekvences sekas konkrētām mutācijām. Carbon X var darboties lokālajā aparatūrā, piemēram, MacBook datorā, piedāvājot izmaksu un privātuma priekšrocības salīdzinājumā ar komerciāliem mākoņpakalpojumiem.
Neskatoties uz šīm inovācijām, dabiskās valodas komandu lietošana biomolekulārā dizainā neaizvieto nepieciešamību pēc jomas ekspertiem. Pētniekiem joprojām nepieciešamas sarežģītas laboratorijas metodes, lai eksperimentāli apstiprinātu un uzlabotu mākslīgā intelekta radītās kandidātu secības. Turklāt šie rīki dažkārt rada viltus pozitīvus rezultātus un halucinācijas, kas prasa rūpīgu interpretāciju.
Samazinot tehniskās barjeras, šie mākslīgā intelekta rīki sola paātrināt bioloģisko pētījumu norisi un padarīt biomolekulāro dizainu pieejamāku. Attīstoties šīm sistēmām, tās var kļūt par vērtīgiem partneriem eksperimentālajiem biologiem, vienkāršojot darba procesus un nodrošinot intuitīvas saskarnes, kas interpretē lietotāja nodomu dabiskajā valodā. Tomēr to plaša ieviešana un pierādīta noderība laboratorijas apstākļos noteiks to galīgo ietekmi šajā jomā.
Avoti un oriģinālziņas
Lasīt oriģinālo avotu ↗
Komentāri (0)
Komentāru vēl nav. Sāciet diskusiju.
Rakstīt komentāru
Komentāri tiek publicēti pēc moderēšanas. Jūsu vārds un komentārs būs redzami publiski. Konts