
Достижения ИИ позволяют создавать инструменты для проектирования белков и генома на естественном языке
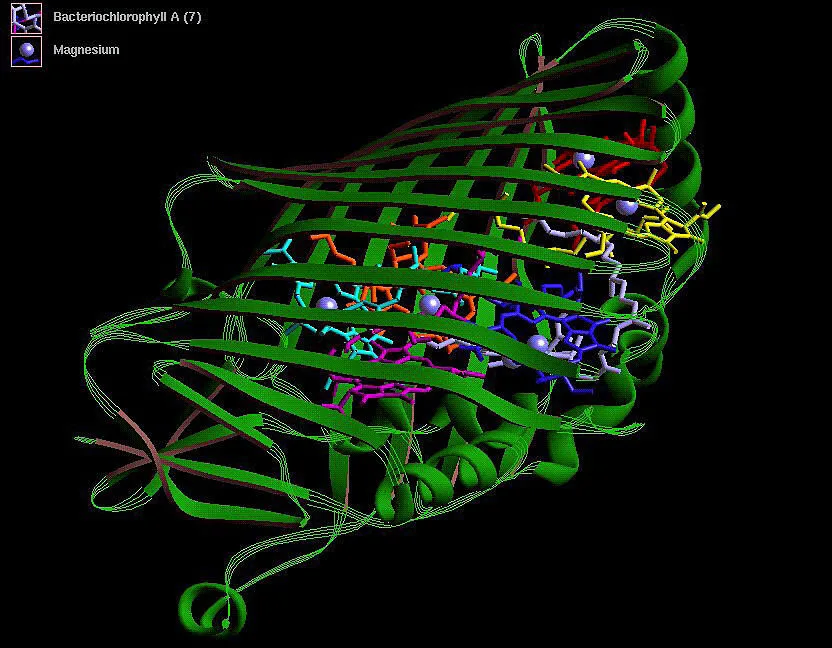
Image: Ars Technica · Source
Новые инструменты с ИИ позволяют пользователям проектировать белки и последовательности ДНК с помощью команд на естественном языке, упрощая сложный процесс биомолекулярного проектирования, однако показатели успеха остаются низкими, и необходима экспертиза для валидации.
Недавние достижения в области искусственного интеллекта открыли путь для новых инструментов, которые упрощают проектирование белков и генома, позволяя пользователям вводить описания на естественном языке вместо детальных биохимических спецификаций. Традиционно проектирование белков требует глубоких знаний механизмов ферментов и точного расположения аминокислот и окружающих молекул. Существующие решения на базе ИИ требуют технического указания структурных ограничений, что ограничивает их использование экспертами, хорошо знакомыми с химией белков.
Крупное исследовательское сотрудничество из Китая разработало инструмент под названием Pinal, который использует обработку естественного языка для интерпретации запросов на простом языке, описывающих желаемые функции белков. Вместо ручного задания конфигураций аминокислот или структурных деталей пользователи могут описать целевые функции — например, ферментативную активность или флуоресценцию — и Pinal генерирует кандидаты на белковые последовательности, предназначенные для выполнения этих функций. Система объединяет модуль преобразования текста в структуру T2struct и генератор аминокислотных последовательностей SAProt-T, используя обширные базы данных белков и предсказанные AlphaFold структуры для обучения.
Исследователи продемонстрировали Pinal, поручив ему спроектировать разнообразные белки, включая флуоресцентный белок, схожий по функции, но отличный по последовательности от зелёного флуоресцентного белка (GFP). Из десятков тысяч вычислительных предсказаний лишь небольшое количество были сгенерированы и экспериментально протестированы; один из них проявил желаемую флуоресценцию. Хотя это свидетельствует о низком уровне успеха, это отражает сложность задачи и строгие критерии фильтрации.
В дополнение к этому другая команда из Hugging Face и академические партнёры представили Carbon X — модель, ориентированную на ДНК, которая интегрирует понимание человеческого языка с предсказанием геномных последовательностей. Эта модель может интерпретировать и генерировать последовательности ДНК на основе команд на естественном языке, переводить между английским и ДНК, а также прогнозировать последствия конкретных мутаций в последовательностях. Carbon X может работать на локальном оборудовании, таком как MacBook, что даёт преимущества по стоимости и конфиденциальности по сравнению с коммерческими облачными системами.
Несмотря на эти инновации, использование запросов на естественном языке в биомолекулярном проектировании не устраняет необходимость в специализированных знаниях. Исследователям по-прежнему нужны сложные лабораторные методы для экспериментальной проверки и доработки кандидатов, созданных ИИ. Кроме того, эти инструменты иногда создают ложноположительные результаты и галлюцинации, требующие осторожной интерпретации.
Снижение технических барьеров делает эти инструменты с ИИ перспективными для ускорения биологических исследований и повышения доступности проектирования биомолекул. По мере развития такие системы могут стать ценными помощниками для экспериментальных биологов, оптимизируя рабочие процессы за счёт интуитивных интерфейсов, которые интерпретируют намерения пользователя из естественного языка. Однако широкое применение и доказанная польза в лабораторных условиях определят их окончательное влияние на область.
Источники и первоисточники
Read the original source ↗
Комментарии (0)
Комментариев пока нет. Начните обсуждение.
Написать комментарий
Комментарии публикуются после модерации. Ваше имя и комментарий будут видны всем. Аккаунт