
KI-Fortschritte ermöglichen Werkzeuge zur Proteinfaltung und Genomdesign mit natürlicher Sprache
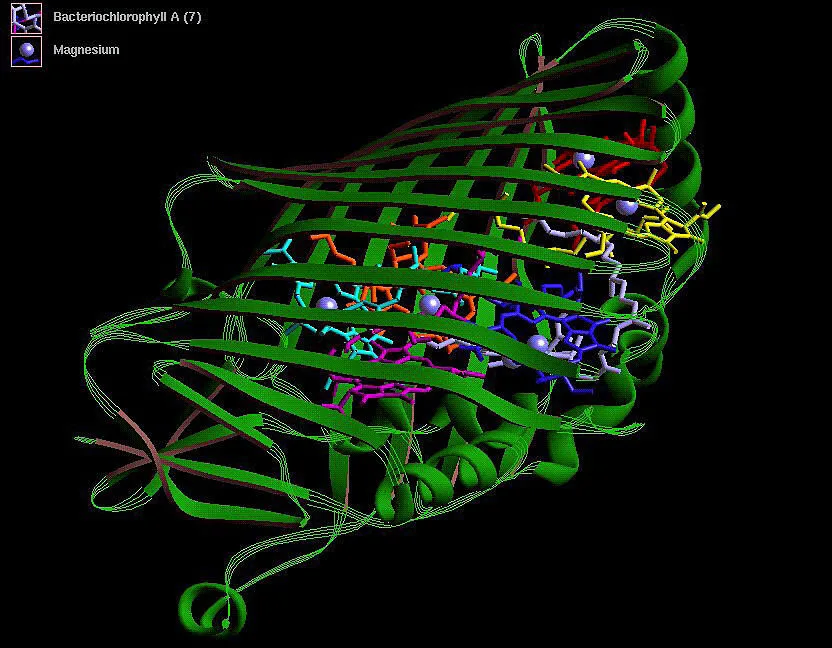
Image: Ars Technica · Source
Neue KI-Werkzeuge erlauben es Nutzern, Proteine und DNA-Sequenzen mittels natürlicher Sprachbefehle zu entwerfen, was den komplexen Prozess des biomolekularen Designs vereinfacht, auch wenn die Erfolgsraten weiterhin niedrig sind und eine Expertenvalidierung unerlässlich bleibt.
Jüngste Fortschritte im Bereich der künstlichen Intelligenz haben neuartige Werkzeuge ermöglicht, welche die Gestaltung von Proteinen und Genomen vereinfachen, indem Nutzer anstelle detaillierter biochemischer Vorgaben Beschreibungen in natürlicher Sprache eingeben können. Traditionell erfordert das Protein-Design tiefgehendes Wissen über Enzymmechanismen und die präzise Platzierung von Aminosäuren und umgebenden Molekülen. Bestehende KI-Lösungen verlangen von den Nutzern die technische Spezifizierung struktureller Einschränkungen, was die Nutzbarkeit auf Experten mit fundierter Proteinchemie beschränkt.
Eine große Forschungskooperation mit Sitz in China entwickelte ein Werkzeug namens Pinal, das Verarbeitung natürlicher Sprache nutzt, um einfach formulierte Eingaben zu interpretieren, die gewünschte Proteinfunktionen beschreiben. Anstatt manuell Aminosäure-Konfigurationen oder Strukturdetails bereitzustellen, können Nutzer Ziel-Funktionen wie enzymatische Aktivität oder Fluoreszenz beschreiben und Pinal generiert Kandidaten-Proteinsequenzen, die darauf ausgelegt sind, diese Funktionen zu erfüllen. Das System kombiniert ein Text-zu-Struktur-Modul namens T2struct mit einem Aminosäure-Sequenzgenerator namens SAProt-T und nutzt umfangreiche Proteindatenbanken sowie AlphaFold-vorhergesagte Strukturen im Training.
Die Forscher demonstrierten Pinal, indem sie ihm die Aufgabe stellten, verschiedene Proteine zu entwerfen, darunter ein fluoreszierendes Protein, das funktional ähnlich, aber in der Sequenz verschieden zum grünen fluoreszierenden Protein (GFP) ist. Von Zehntausenden computergenerierten Vorhersagen wurden nur wenige tatsächlich hergestellt und experimentell getestet; eines zeigte die gewünschte Fluoreszenz. Obwohl dies eine niedrige Erfolgsrate darstellt, zeigt es die Schwierigkeit der Herausforderung und die strengen Filterkriterien.
Ergänzend dazu stellte ein weiteres Team von Hugging Face und akademischen Partnern Carbon X vor, ein Modell mit Fokus auf DNA, das menschliches Sprachverständnis mit genomischer Sequenzvorhersage verbindet. Dieses Modell kann DNA-Sequenzen basierend auf natürlichen Spracheingaben interpretieren und generieren, zwischen Englisch und DNA übersetzen und die Folgen spezifischer Mutationen vorhersagen. Carbon X kann auf lokaler Hardware wie einem MacBook betrieben werden und bietet dadurch Kosten- und Datenschutzvorteile gegenüber kommerziellen Cloud-Systemen.
Trotz dieser Innovationen beseitigt die Verwendung von Spracheingaben im biomolekularen Design nicht die Notwendigkeit von Fachwissen. Forscher benötigen weiterhin ausgefeilte Labortechniken, um die KI-generierten Kandidaten experimentell zu validieren und zu optimieren. Zudem produzieren diese Werkzeuge gelegentlich falsch positive beziehungsweise halluzinierte Ausgaben, was eine sorgfältige Interpretation erfordert.
Indem sie technische Barrieren abbauen, bergen diese KI-Werkzeuge das Potenzial, die biologische Forschung zu beschleunigen und biomolekulares Design zugänglicher zu machen. Mit der Weiterentwicklung dieser Systeme könnten sie für experimentelle Biologen wertvolle Hilfsmittel werden, die Arbeitsabläufe durch intuitive Schnittstellen erleichtern, welche die Nutzerabsicht aus natürlicher Sprache ableiten. Ob sie sich flächendeckend durchsetzen und ihren Nutzen im Laboralltag beweisen, wird ihren endgültigen Einfluss auf das Fachgebiet bestimmen.
Quellen und Originalberichte
Read the original source ↗
Kommentare (0)
Noch keine Kommentare.
Kommentar schreiben
Kommentare erscheinen nach Moderation. Name und Kommentar werden öffentlich angezeigt. Konto