
Google запускает бенчмарк Multimodal Knowledge Agent для оценки визуального рассуждения в ИИ
Image: Google · Source
Google в сотрудничестве с Artificial Analysis представила бенчмарк Multimodal Knowledge Agent для оценки способности ИИ-агентов справляться с визуально сложными задачами из различных профессиональных областей в реальных условиях.
Компания Google совместно с Artificial Analysis объявила о запуске бенчмарка Multimodal Knowledge Agent (MKA) 10 ноября 2026 года. Новый бенчмарк предназначен для оценки того, как искусственные агенты рассуждают над визуально сложными задачами, которые обычно встречаются в профессиональной работе, основанной на знаниях. В отличие от традиционных бенчмарков, решаемых только с помощью текста, MKA подчеркивает важность интерпретации изображений, макетов и схем — элементов, критически важных для повседневной деятельности во многих отраслях.
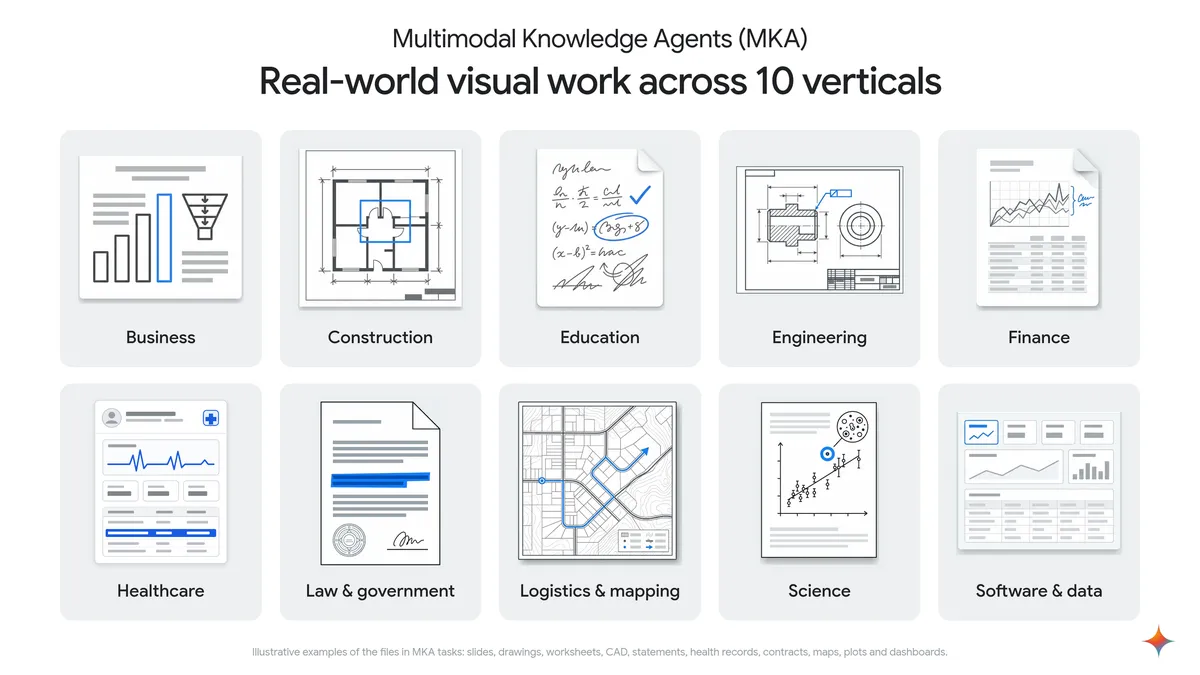
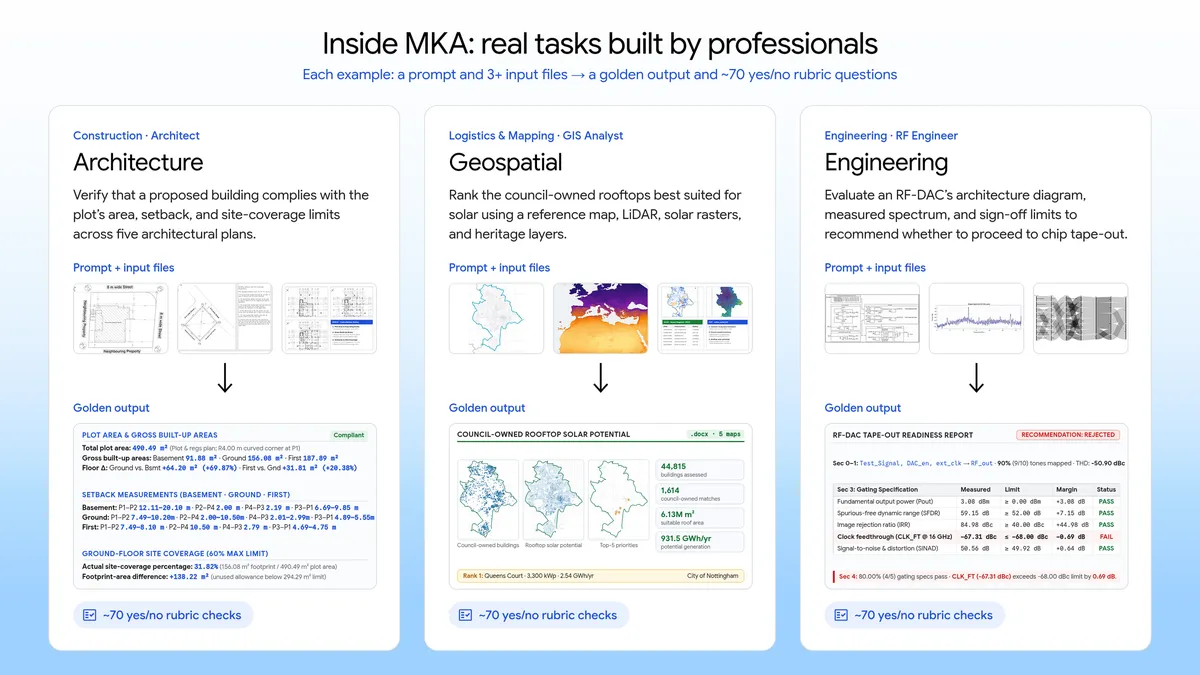
Создание MKA включало экспертов из 10 отраслей, охватывающих 83 профессии, включая архитекторов, биологов, страховщиков и специалистов по данным. Эти специалисты разработали набор из 200 сложных заданий, представляющих собой многоэтапные проекты, требующие нескольких часов работы опытных профессионалов. Каждое задание содержит реалистичные инструкции, сопровождающиеся мультимодальными входными файлами, и оценивается с помощью экспертной рубрики, в которой 75% уделено фактической точности и 25% — качеству визуального дизайна.
Для обеспечения справедливого и открытого бенчмаркинга все модели, оцененные с помощью MKA, работают в рамках открытой платформы агента Stirrup, которая стандартизирует инструменты, песочницу и лимит взаимодействий. Кроме того, агентский авторейтер, построенный на модели, не относящейся к Google, автоматически оценивает результаты, тщательно проверяя входные файлы, визуализируя страницы, исследуя формулы в электронных таблицах и сверяя выходные данные с экспертной рубрикой. Этот авторейтер совпадает с оценками человеческих экспертов в 96% случаев.
Данные для оценки остаются закрытыми, чтобы предотвратить утечку в обучающие данные или обнаружение модели через поиск, в то время как меньший публичный набор из 10 заданий доступен на Hugging Face для более широкого изучения и тестирования.
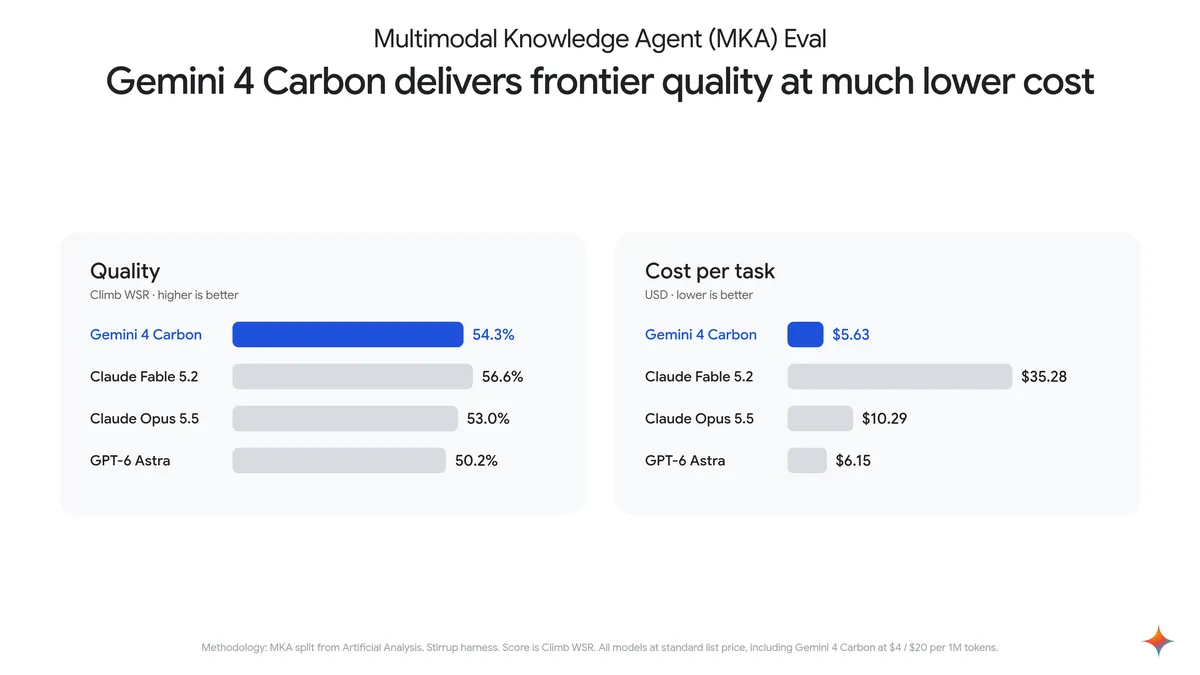
Модель Gemini 4 Carbon от Google достигла второго по величине качественного показателя в тестах MKA при высокой экономичности — работая примерно с шестой части стоимости модели с наивысшим результатом. Gemini 4 Carbon уже доступна через Gemini API в Google AI Studio, поддерживается обновленным руководством для разработчиков.
Технический отчет, сопровождающий MKA, подчеркивает, что модели высшего уровня значительно различаются по эффективности, и что сильные способности визуального восприятия необходимы для решения задач бенчмарка. В нем также подробно описано, как модели хуже справляются без визуального ввода и какие различные подходы используют агенты при выполнении этих сложных заданий.
Эта инициатива подчеркивает растущее признание того, что продвинутые ИИ-агенты должны интегрировать мультимодальное понимание для эффективной поддержки сложной, визуально насыщенной интеллектуальной работы в различных областях.
Источники и первоисточники
Read the original source ↗
Комментарии (0)
Комментариев пока нет. Начните обсуждение.
Написать комментарий
Комментарии публикуются после модерации. Ваше имя и комментарий будут видны всем. Аккаунт