
Google uruchamia test Multimodal Knowledge Agent do oceny wizualnego rozumowania w AI
Image: Google · Source
Google we współpracy z Artificial Analysis wprowadziło benchmark Multimodal Knowledge Agent, mający na celu ocenę zdolności agentów AI do radzenia sobie z wizualnie złożonymi, realistycznymi zadaniami z różnych dziedzin zawodowych.
Google, współpracując z Artificial Analysis, ogłosiło uruchomienie benchmarku Multimodal Knowledge Agent (MKA) 10 listopada 2026 roku. Nowy benchmark został zaprojektowany, aby ocenić, jak sztuczne agenty radzą sobie z wizualnie złożonymi zadaniami, które zwykle pojawiają się w profesjonalnej pracy opierającej się na wiedzy. W odróżnieniu od tradycyjnych benchmarków, które można rozwiązać wyłącznie za pomocą tekstu, MKA podkreśla znaczenie interpretacji obrazów, układów i schematów – elementów kluczowych dla codziennej pracy w wielu branżach.
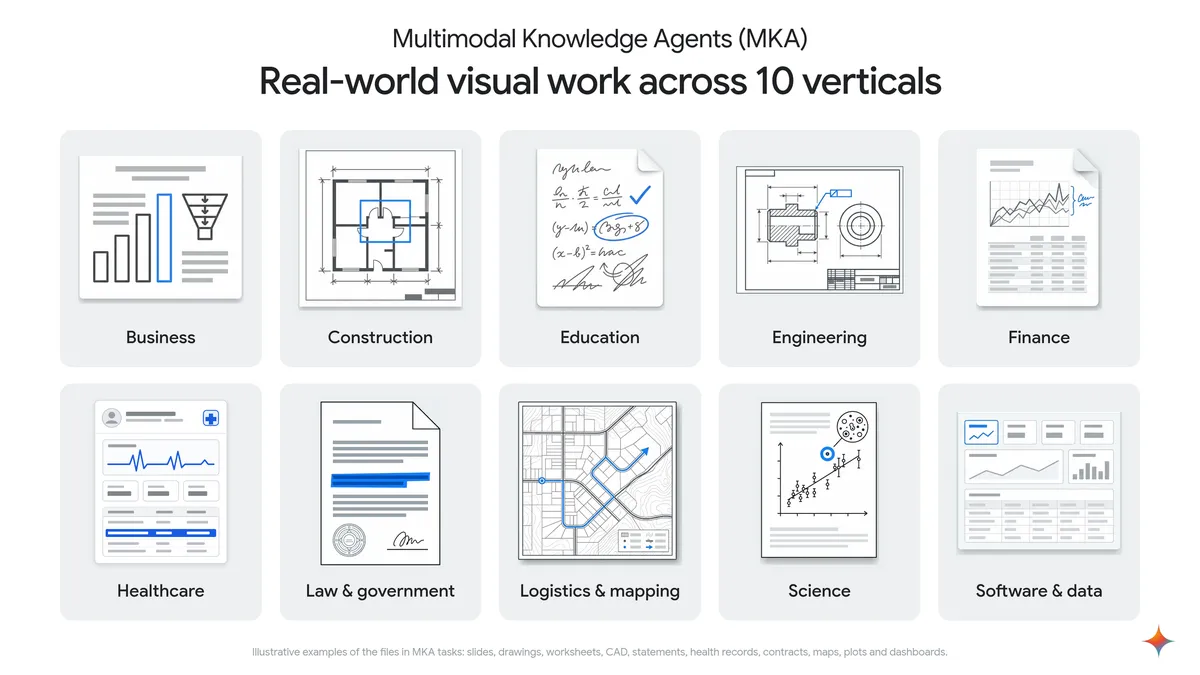
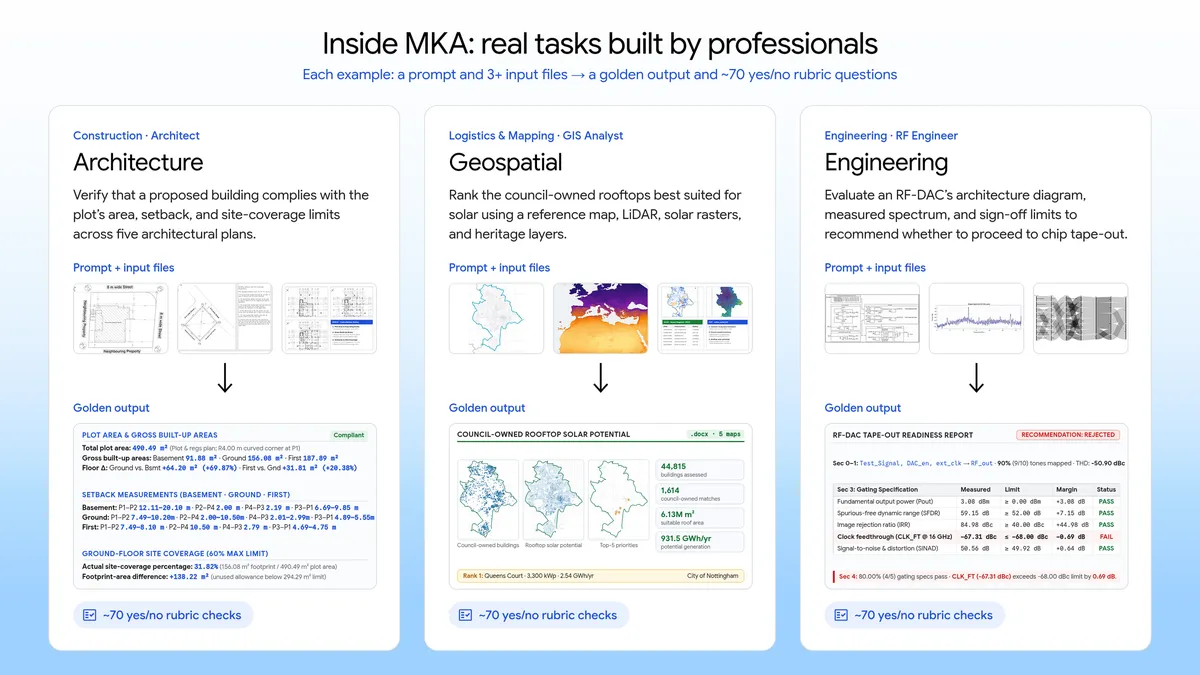
Proces tworzenia benchmarku MKA zaangażował ekspertów branżowych z 10 sektorów obejmujących 83 zawody, w tym architektów, biologów, underwriterów i data scientistów. Specjaliści opracowali zestaw oceniający 200 złożonych zadań reprezentujących wieloetapowe projekty wymagające kilku godzin pracy doświadczonych profesjonalistów. Każde zadanie zawiera realistyczne polecenia powiązane z multimodalnymi plikami wejściowymi i jest oceniane za pomocą ekspertowego rubryki skupiającej się w 75% na dokładności faktów i 25% na jakości wizualnej prezentacji.
Dla zapewnienia uczciwego i otwartego benchmarkingu wszystkie modele oceniane za pomocą MKA działają w ramach otwartego środowiska agenta Stirrup, które standaryzuje narzędzia, środowisko sandbox i budżet interakcji. Dodatkowo agentic autorater oparty na modelu spoza Google automatycznie ocenia wyniki, dokładnie analizując pliki wejściowe, renderując strony, sprawdzając formuły w arkuszach kalkulacyjnych i porównując wyniki z eksperckimi rubrykami. Ten autorater zgadza się z oceną ekspertów ludzkich w 96% przypadków.
Zestaw danych do oceny pozostaje prywatny, aby zapobiec wyciekowi do danych treningowych lub odkryciu modelu przez wyszukiwarki, natomiast mniejszy, publiczny zestaw 10 zadań jest dostępny na platformie Hugging Face do szerszego przeglądu i testowania.
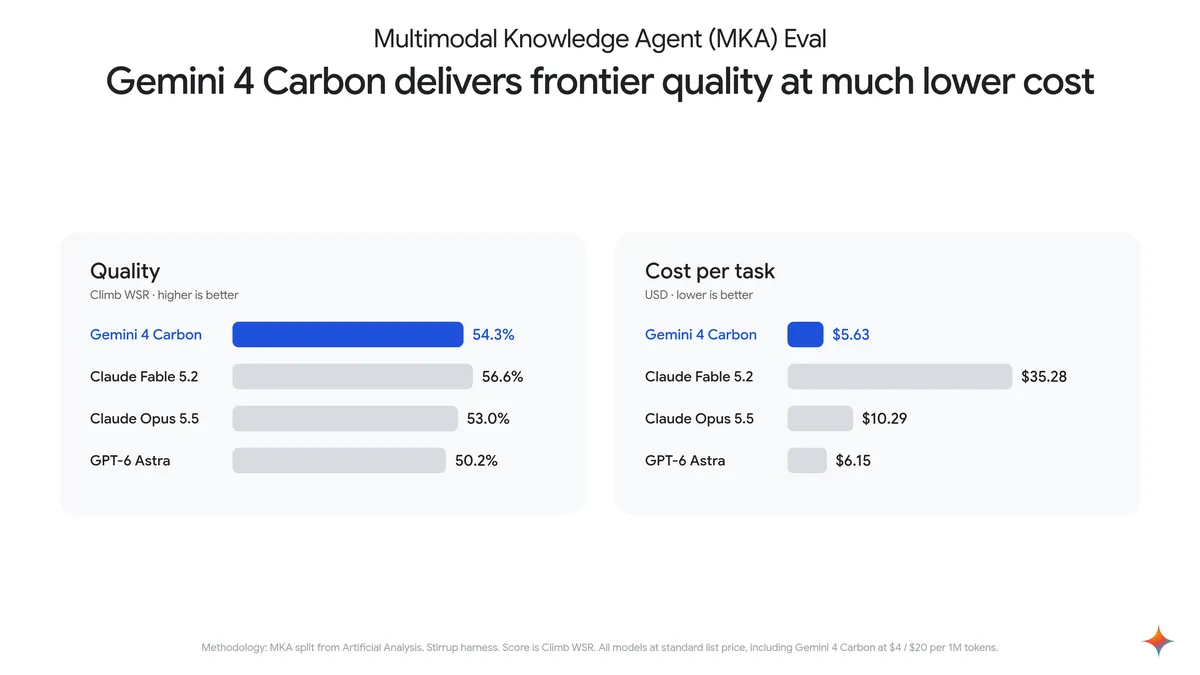
Model Gemini 4 Carbon firmy Google osiągnął drugi najwyższy wynik jakościowy w testach MKA, jednocześnie wykazując wysoką efektywność kosztową – działa przy około jednej szóstej kosztów modelu z najwyższym wynikiem. Gemini 4 Carbon jest dostępny już teraz przez Gemini API w Google AI Studio, wspierany zaktualizowanym przewodnikiem dla programistów.
Raport techniczny towarzyszący MKA podkreśla, że modele najwyższej klasy znacznie różnią się pod względem efektywności oraz że silne zdolności percepcji wizualnej są niezbędne do rozwiązywania zadań benchmarku. Dokument szczegółowo opisuje również, jak modele radzą sobie gorzej bez wejścia wizualnego oraz różne podejścia agentów do tych trudnych zadań.
Inicjatywa ta podkreśla rosnącą świadomość, że zaawansowane agenty AI muszą integrować zrozumienie multimodalne, aby skutecznie wspierać złożoną, wizualnie bogatą pracę opartą na wiedzy w różnych dziedzinach.
Źródła i oryginalne doniesienia
Read the original source ↗
Komentarze (0)
Nie ma jeszcze komentarzy.
Napisz komentarz
Komentarze publikujemy po moderacji. Nazwa i komentarz będą publiczne. Konto