
Google lanserer Multimodal Knowledge Agent-benchmark for å evaluere visuell resonnering i AI
Bilde: Google · Kilde
Google, i samarbeid med Artificial Analysis, har introdusert Multimodal Knowledge Agent-benchmark for å vurdere AI-agenters evne til å håndtere visuelt komplekse, virkelighetsnære oppgaver på tvers av ulike profesjonelle domener.
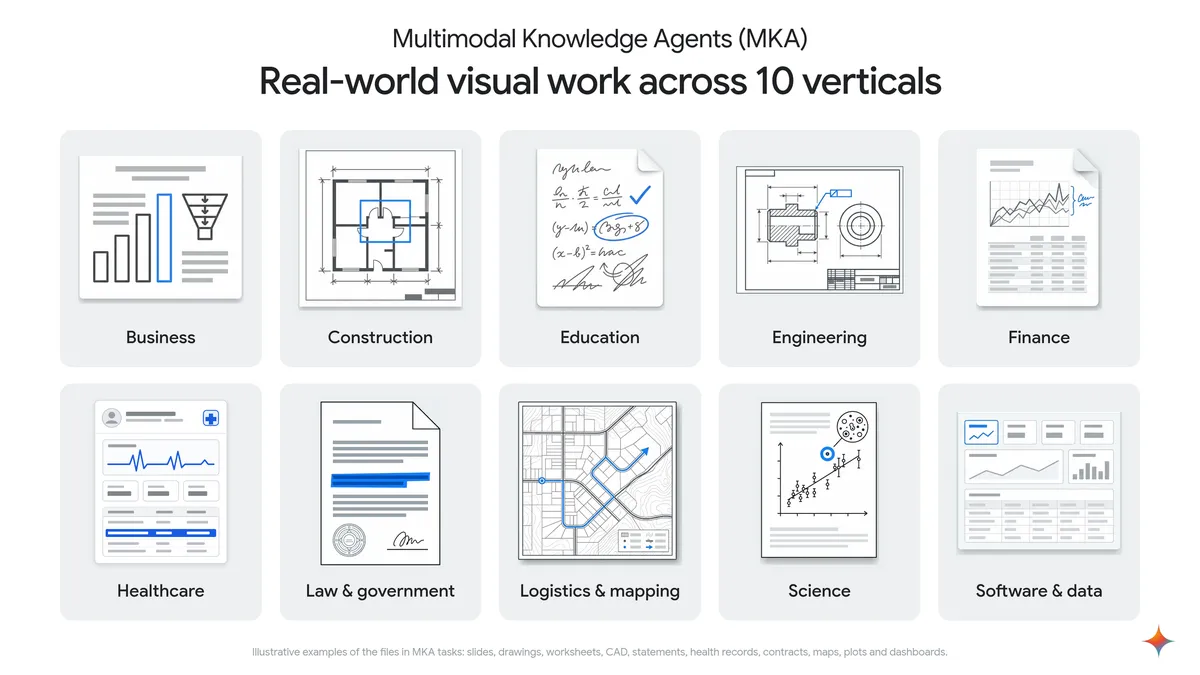
Google, i partnerskap med Artificial Analysis, kunngjorde lanseringen av Multimodal Knowledge Agent (MKA)-benchmark den 10. november 2026. Denne nye benchmarken er designet for å evaluere hvordan kunstige agenter resonerer over visuelt komplekse oppgaver som vanligvis oppstår i profesjonelt kunnskapsarbeid. I motsetning til tradisjonelle benchmarks som kan løses utelukkende med tekst, legger MKA vekt på betydningen av å tolke bilder, oppsett og skjemaer—elementer som er kritiske for daglig drift i mange bransjer.
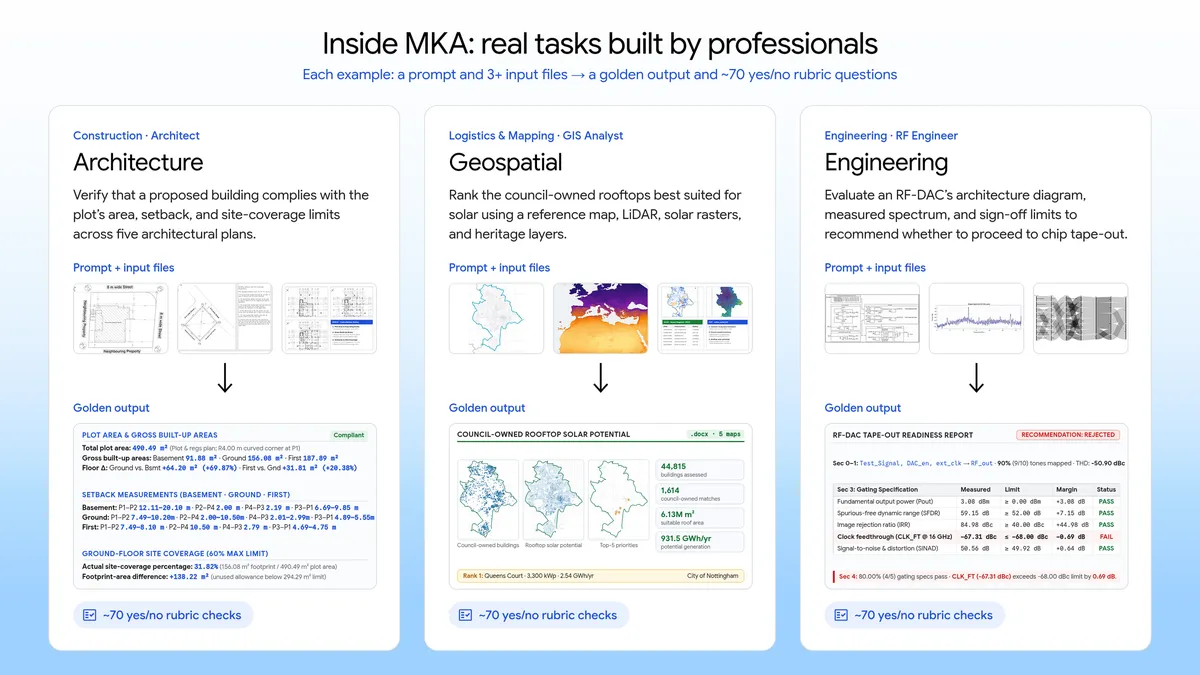
Utviklingen av MKA-benchmarken involverte domeneeksperter fra 10 sektorer som omfatter 83 yrker, inkludert arkitekter, biologer, forsikringsvurderere og dataforskere. Disse spesialistene utviklet et evalueringssett på 200 komplekse oppgaver som representerer flertrinnsprosjekter som krever flere timer å fullføre av erfarne fagfolk. Hver oppgave inneholder realistiske oppdragsbeskrivelser sammen med multimodale inndatafiler, og vurderes med en ekspertutarbeidet rubrikk som fokuserer 75 % på faktanøyaktighet og 25 % på kvaliteten av visuell design.
For å legge til rette for rettferdig og åpen benchmarking opererer alle modeller som evalueres med MKA innenfor den åpne agent-rammeverket Stirrup, som standardiserer verktøy, sandkasse-miljø og interaksjonsbudsjett. I tillegg er det en agentbasert automatisk vurderer, basert på en ikke-Google-modell, som automatisk karaktersetter leveranser ved å grundig undersøke inndatafiler, sideutrenderinger, inspisere regnearkformler og sammenligne utdata med ekspertrubrikker. Denne automatvurdereren samsvarer med menneskelige ekspertvurderinger 96 % av gangene.
Evalueringsdatasettet forblir privat for å forhindre lekkasje til treningsdata eller modelloppdagelse via søk, mens et mindre offentlig sett på 10 oppgaver er tilgjengelig på Hugging Face for bredere inspeksjon og testing.
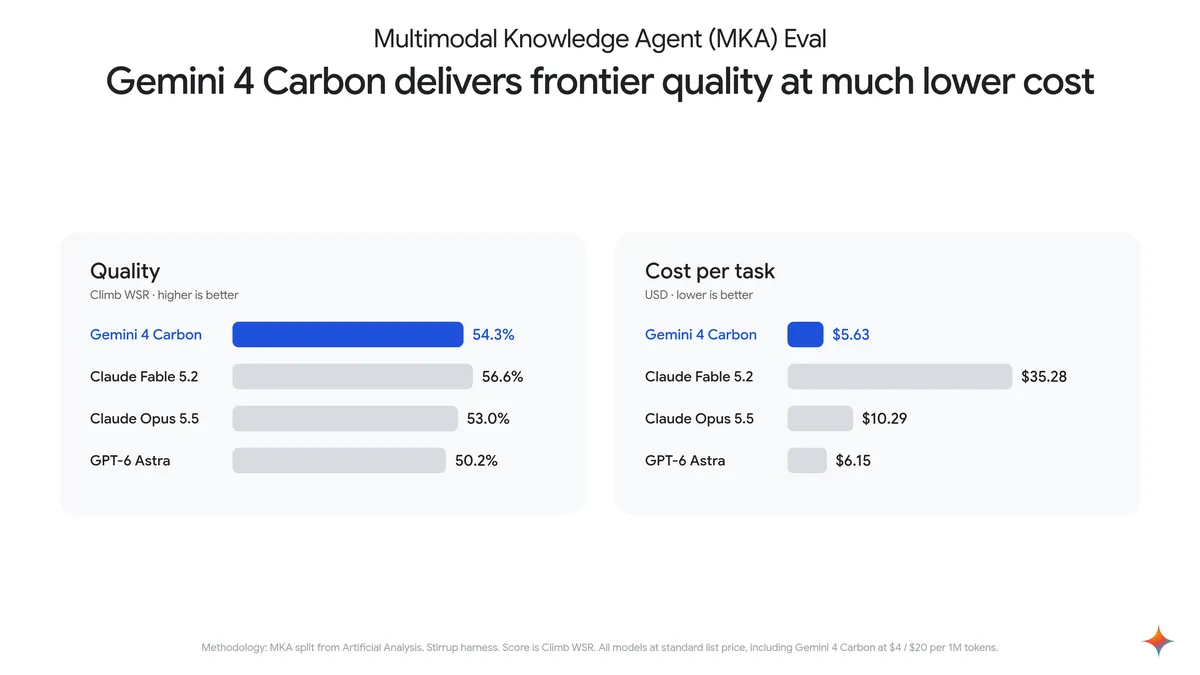
Googles Gemini 4 Carbon-modell oppnådde den nest høyeste kvalitetsvurderingen på MKA-testene samtidig som den viste høy kostnadseffektivitet—den opererer til omtrent en sjettedel av kostnaden til modellen med høyest poengsum. Gemini 4 Carbon er tilgjengelig nå gjennom Gemini API i Google AI Studio, støttet av en oppdatert utviklerguide.
Den tekniske rapporten som følger med MKA fremhever at toppmodeller varierer betydelig i effektivitet, og at sterke visuelle persepsjonsevner er essensielle for å løse benchmark-oppgavene. Den beskriver også hvordan modeller presterer dårligere uten visuelle inndata og de varierte tilnærmingene agenter tar på tvers av disse krevende oppgavene.
Dette initiativet understreker den økende anerkjennelsen av at avanserte AI-agenter må integrere multimodal forståelse for effektivt å støtte komplekst, visuelt rikt kunnskapsarbeid på tvers av ulike områder.
Kilder og originalrapportering
Les originalkilden ↗
Kommentarer (0)
Ingen kommentarer ennå. Start diskusjonen.
Skriv en kommentar
Kommentarer publiseres etter moderering. Ditt navn og kommentar vil være synlige offentlig. Konto