
Google lanserar Multimodal Knowledge Agent-benchmark för att utvärdera visuell resonemang i AI
Bild: Google · Källa
Google, i samarbete med Artificial Analysis, har introducerat Multimodal Knowledge Agent-benchmark för att bedöma AI-agenters förmåga att hantera visuellt komplexa, verkliga uppgifter inom olika professionella områden.
Google, i samarbete med Artificial Analysis, tillkännagav lanseringen av Multimodal Knowledge Agent (MKA)-benchmark den 10 november 2026. Denna nya benchmark är utformad för att utvärdera hur artificiella agenter resonerar över visuellt komplexa uppgifter som vanligtvis uppstår i professionellt kunskapsarbete. Till skillnad från traditionella benchmark-tester som kan lösas med endast text, betonar MKA vikten av att tolka bilder, layout och scheman—element som är avgörande för den dagliga verksamheten i många branscher.
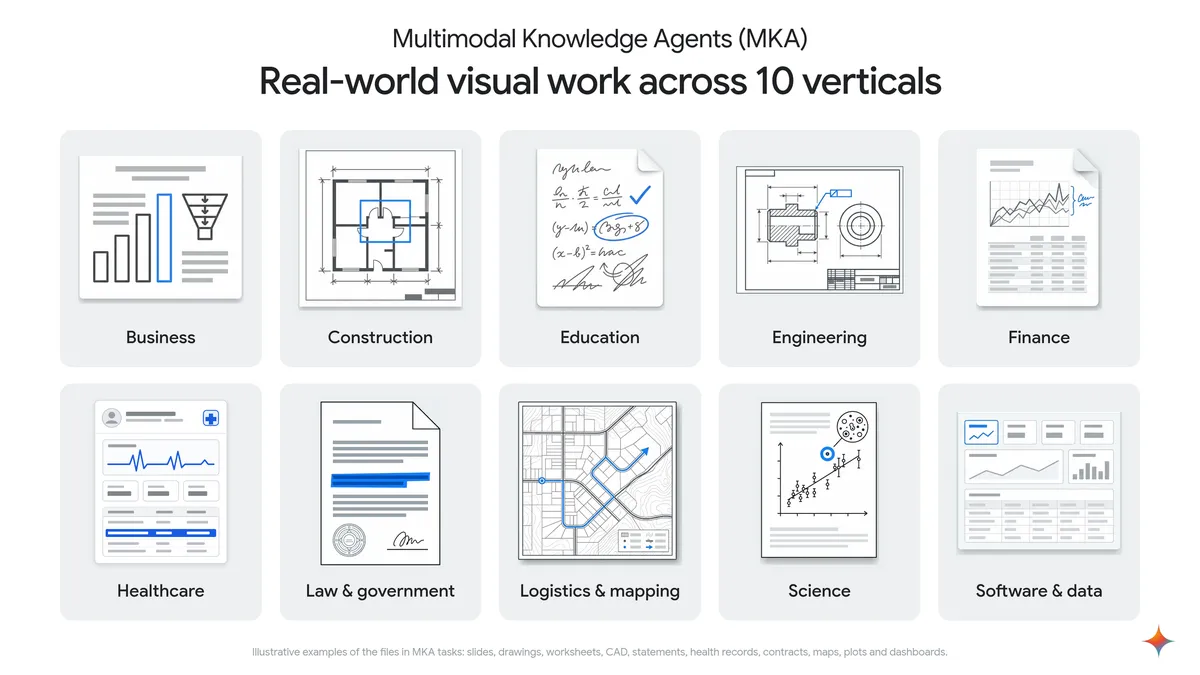
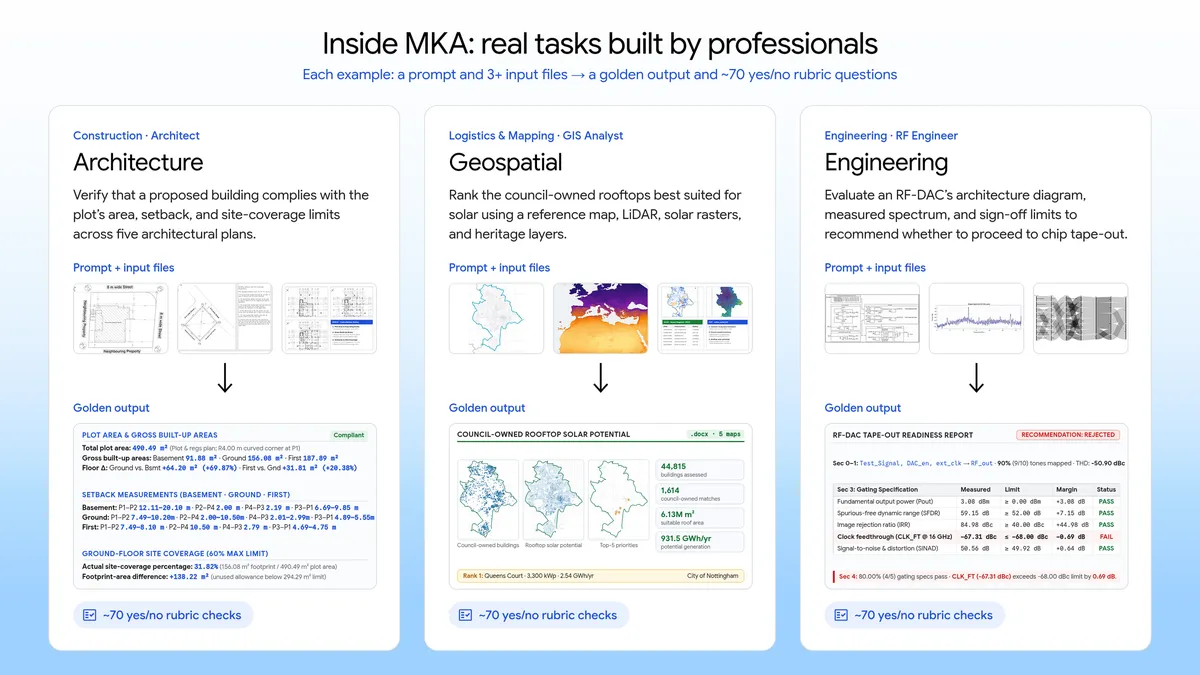
Skapandet av MKA-benchmarken involverade domänexperter från 10 branscher som omfattar 83 yrken, inklusive arkitekter, biologer, försäkringsbedömare och dataforskare. Dessa specialister utvecklade en utvärderingsuppsättning med 200 komplexa uppgifter som representerar flerstegsprojekt som kräver flera timmars arbete för erfarna yrkespersoner. Varje uppgift innehåller realistiska uppmaningar kopplade till multimodala indatafiler och bedöms med en expertgranskad rubrik som fokuserar 75 % på faktuell noggrannhet och 25 % på visuell designkvalitet.
För att möjliggöra rättvis och öppen benchmarking fungerar alla modeller som utvärderas med MKA inom den öppen källkodsbundna agentplattformen Stirrup, som standardiserar verktyg, sandbox-miljö och interaktionsbudget. Dessutom finns en agentbaserad automatisk bedömare (autorater) byggd på en modell utanför Google som automatiskt graderar leveranser genom att noggrant undersöka indatafiler, renderade sidor, inspektera kalkylarksformler och jämföra resultat med expertrubriker. Denna automatbedömare överensstämmer med mänsklig expertbedömning i 96 % av fallen.
Utvärderingsdatasettet förblir privat för att förhindra läckage till träningsdata eller modellupptäckt via sökningar, medan en mindre offentlig uppsättning med 10 uppgifter finns tillgänglig på Hugging Face för bredare inspektion och testning.
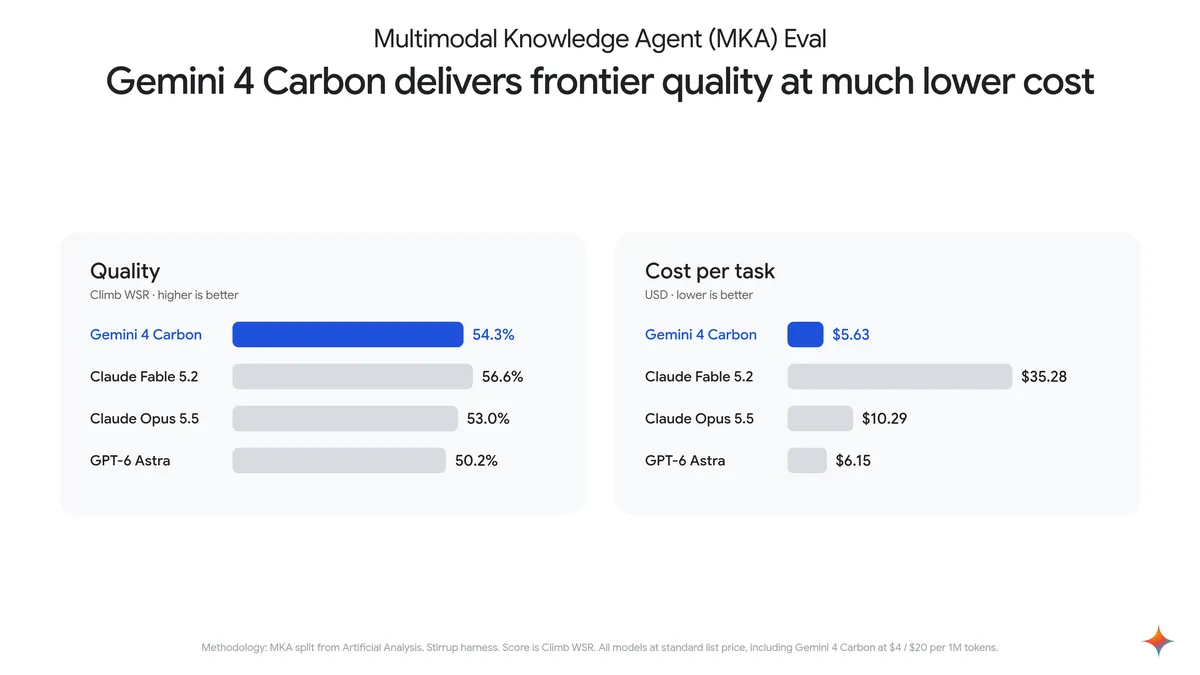
Googles Gemini 4 Carbon-modell nådde det näst högsta kvalitetsbetyget på MKA-testerna samtidigt som den visade hög kostnadseffektivitet—driftkostnaden uppgår till ungefär en sjättedel av modellen med högst poäng. Gemini 4 Carbon är nu tillgänglig via Gemini API i Google AI Studio, med stöd från en uppdaterad utvecklarguide.
Den tekniska rapporten som följer med MKA framhäver att toppmodeller skiljer sig markant i effektivitet och att starka visuella perceptionsförmågor är avgörande för att lösa benchmark-uppgifterna. Den redogör även för hur modeller presterar sämre utan visuella indata och de skiftande metoder som agenter använder för dessa utmanande uppgifter.
Initiativet understryker den växande insikten att avancerade AI-agenter måste integrera multimodal förståelse för att effektivt stödja komplext, visuellt rikt kunskapsarbete inom olika områden.
Källor och ursprunglig rapportering
Läs den ursprungliga källan ↗
Kommentarer (0)
Inga kommentarer ännu. Börja diskussionen.
Skriv en kommentar
Kommentarer publiceras efter granskning. Ditt namn och kommentar syns offentligt. Konto