
Google izstrādā multimodālu zināšanu aģentu novērtēšanas rādītāju vizuālās loģikas pārbaudei mākslīgajā intelektā
Attēls: Google · Avots
Google sadarbībā ar Artificial Analysis ir izstrādājis Multimodālu zināšanu aģentu (MKA) novērtēšanas rādītāju, lai pārbaudītu mākslīgā intelekta aģentu spēju risināt redzami sarežģītus, reālās pasaules uzdevumus dažādās profesionālās nozarēs.
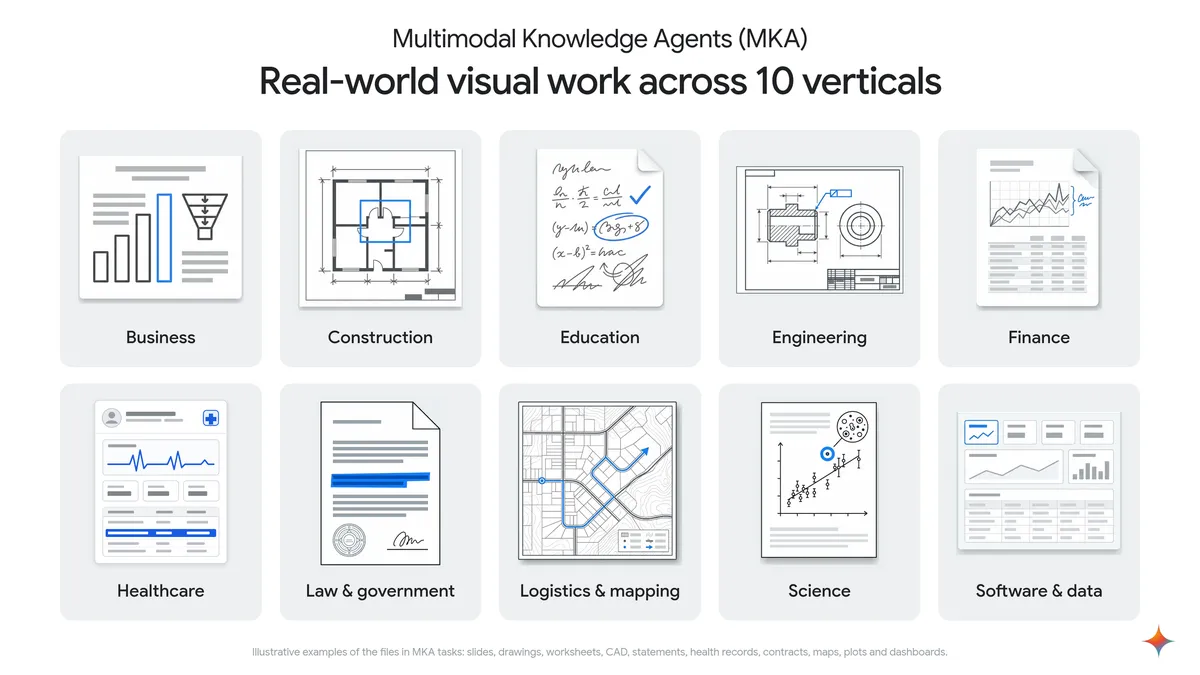
Google, sadarbojoties ar Artificial Analysis, paziņoja par Multimodāla zināšanu aģenta (MKA) novērtēšanas rādītāja izveidi 2026. gada 10. novembrī. Šis jaunais novērtēšanas rādītājs ir izstrādāts, lai novērtētu, kā mākslīgie aģenti spēj risināt vizuāli sarežģītus uzdevumus, kas parasti rodas profesionālas zināšanu darba kontekstā. Atšķirībā no tradicionālajiem novērtēšanas rādītājiem, kurus var atrisināt tikai ar tekstu, MKA uzsver attēlu, izkārtojumu un shēmu interpretācijas nozīmi — elementus, kas ir būtiski ikdienas darbībā daudzās nozarēs.
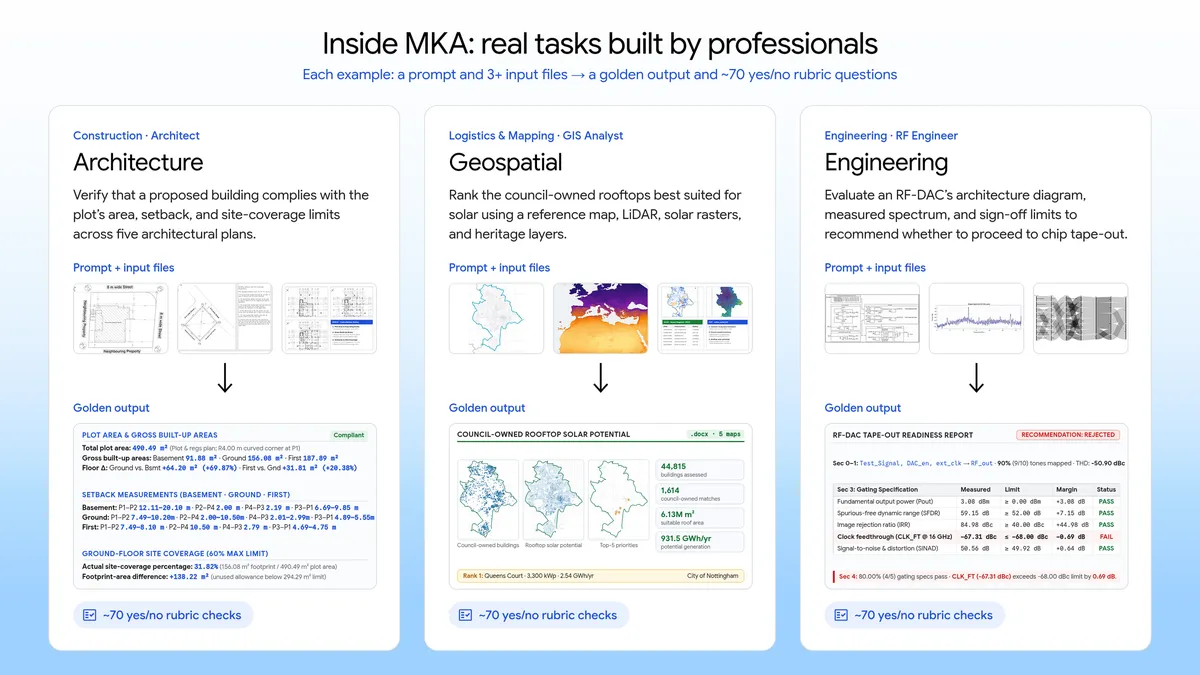
MKA novērtēšanas rādītāja izstrādē piedalījās jomas eksperti no 10 nozares vertikālēm, aptverot 83 profesijas, tostarp arhitektus, biologus, apdrošinātājus un datu zinātniekus. Šie speciālisti izstrādāja vērtēšanas komplektu, kas sastāv no 200 sarežģītiem uzdevumiem, kas atspoguļo daudzpakāpju projektus, kuriem pieredzējuši profesionāļi veltītu vairākas stundas. Katram uzdevumam ir reālistiski norādījumi ar multimodālu ievades failu komplektu, un tas tiek vērtēts, izmantojot ekspertu izstrādātu vērtēšanas rubriku, kuras 75% vērtējuma sastāda faktu precizitāte un 25% — vizuālā dizaina kvalitāte.
Lai nodrošinātu godīgu un atklātu novērtēšanu, visi MKA arhitektūras modeļi darbojas atvērtā koda aģentu ietvarā Stirrup, kas standartizē rīkus, aizsargātu vidi un mijiedarbības budžetu. Turklāt aģentu automatizētais vērtētājs, kas balstās uz ne-Google modeli, automātiski vērtē rezultātus, rūpīgi pārbaudot ievades failus, attēlojot lapas, pārbaudot izklājlapu formulas un salīdzinot rezultātus ar ekspertu rubrikām. Šis automatizētais vērtētājs ir saskaņā ar cilvēku ekspertu lēmumiem 96% gadījumu.
Novērtējuma datu kopums tiek saglabāts privāts, lai novērstu tā nonākšanu mācību datos vai modeļu atklāšanu, izmantojot meklēšanu, savukārt mazāks publisks 10 uzdevumu komplekts ir pieejams Hugging Face platformā plašākai pārskatīšanai un testēšanai.
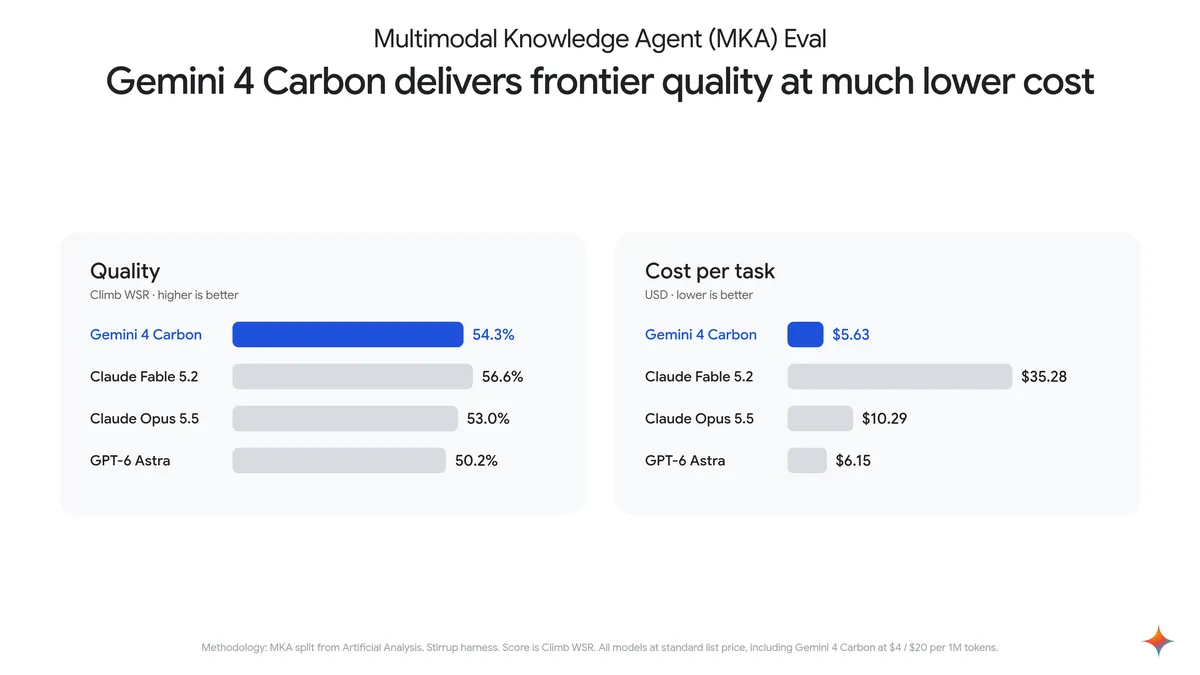
Google Gemini 4 Carbon modelis MKA testos ieguva otro augstāko kvalitātes rezultātu, vienlaikus demonstrējot augstu izmaksu efektivitāti — darbojas aptuveni sešas reizes lētāk nekā augstākā rezultāta modelis. Gemini 4 Carbon ir pieejams, izmantojot Gemini API Google AI Studio platformā, to papildina atjaunota izstrādātāju roka grāmata.
Tehniskajā ziņojumā, kas pavada MKA, norādīts, ka augstākās klases modeļi būtiski atšķiras efektivitātē un spēcīgas vizuālās uztveres iespējas ir būtiskas šī novērtēšanas rādītāja uzdevumu risināšanā. Tāpat ir aprakstīts, kā modeļi sniedz sliktākus rezultātus bez vizuālās ievades un kā dažādi aģenti pieiet šiem izaicinošiem uzdevumiem.
Šī iniciatīva uzsver pieaugošo izpratni, ka attīstīti mākslīgā intelekta aģenti ir jāapvieno multimodāla izpratne, lai efektīvi atbalstītu sarežģītu, vizuāli bagātu zināšanu darbu dažādās jomās.
Avoti un oriģinālziņas
Lasīt oriģinālo avotu ↗
Komentāri (0)
Komentāru vēl nav. Sāciet diskusiju.
Rakstīt komentāru
Komentāri tiek publicēti pēc moderēšanas. Jūsu vārds un komentārs būs redzami publiski. Konts