
Google 2026. gadā atklāj četras specializētas TPU, tostarp drošus un ar plašu kontekstu modeļus
Attēls: Google · Avots
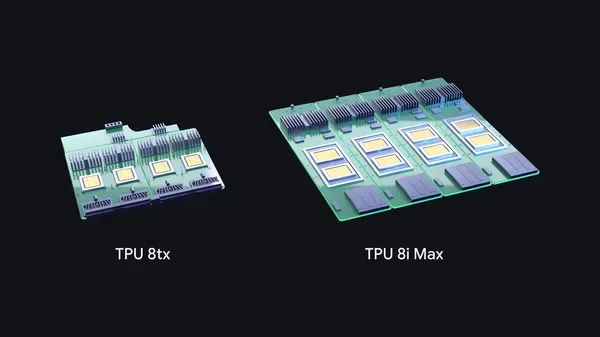
Google paplašina savu astotās paaudzes TPU klāstu ar TPU 8tx un TPU 8i Max, papildinot TPU 8t un 8i, lai risinātu drošas inferencēšanas un apjomīgu kontekstu mākslīgā intelekta aģentiem.
2026. gada novembrī Google paziņoja par būtisku paplašinājumu savā astotās paaudzes Tensor Processing Unit (TPU) portfelī, ieviešot divas jaunas sistēmas — TPU 8tx un TPU 8i Max — kopā ar iepriekš izlaistajiem TPU 8t un TPU 8i modeļiem. Tas ir pirmais gadījums, kad Google vienā gadā izlaidis četras TPU variācijas, kas atspoguļo pieaugošo AI darba slodžu sarežģītību un vajadzību pēc specializētas aparatūras.
TPU radīti pirms vairāk nekā desmit gadiem, lai atbalstītu Google iekšējās AI vajadzības, piemēram, balss atpazīšanu un valodu tulkošanu, tie ir attīstījušies, lai apkalpotu dažādas lietojumprogrammas, tostarp Gemini AI modeļu apmācību un izvietošanu, aģentiskās darba slodzes un mākoņpakalpojumu nodrošināšanu aptuveni 100 klientiem visā pasaulē.
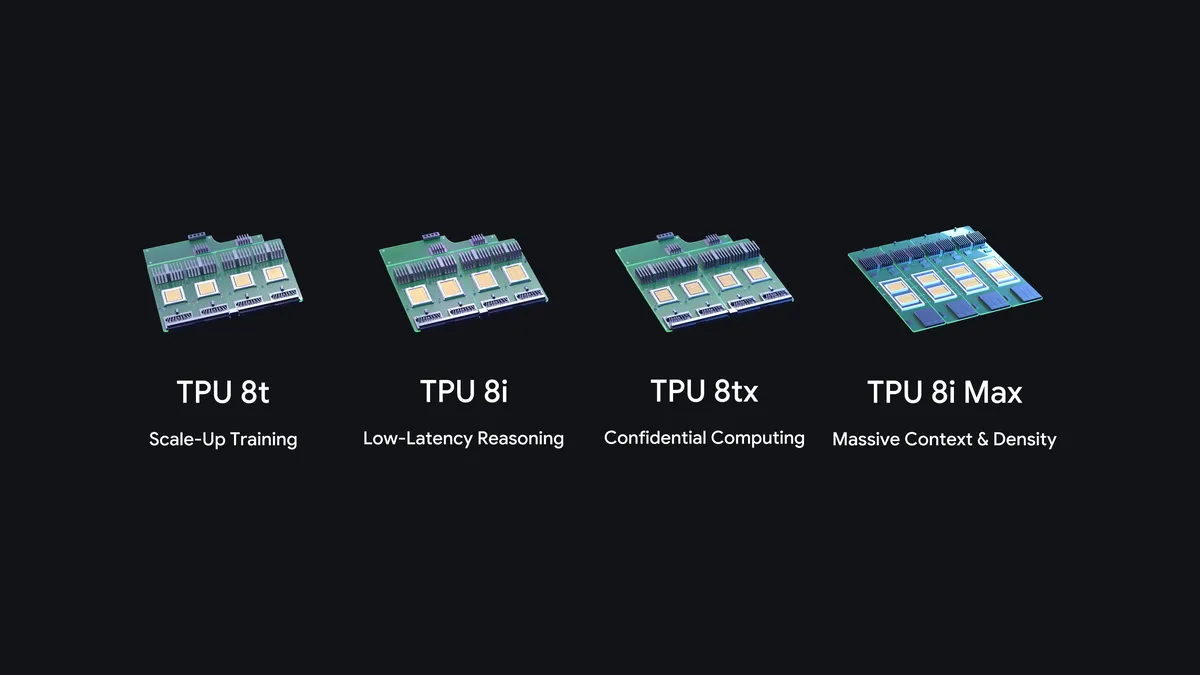
TPU 8t ir izstrādāts plaša mēroga pamatā esošo AI modeļu apmācībai, koncentrējoties uz apmācības veiktspējas maksimizēšanu, kas tiek mērīta kā noderīgas intelekta izlaides apjoms uz vatu. TPU 8i variants ir vērsts uz reāllaika spriešanas uzdevumiem, efektīvi risinot atmiņas nosprostojumus un samazinot komunikācijas aizkavēšanos starp mikroshēmām.
Nesen izziņotais TPU 8tx ir paredzēts drošām un konfidenciālām AI inferencēšanas darba slodzēm, atbilstot regulētām nozarēm, piemēram, uzņēmumiem un valdības iestādēm. Izmantojot tādu pašu mikroshēmu kā TPU 8t kopā ar AMD EPYC CPU, TPU 8tx ietver aparatūras līmeņa šifrēšanu, lai aizsargātu jutīgos datus un modeļa parametrus aktīvas lietošanas laikā, vienlaikus uzturot zemu latentumu, pateicoties specializētam Boardfly tīklam. Šī sistēma atbalsta privātu precizēšanu, distilēšanu un pastiprinātu mācīšanos vienā platformā bez datu migrācijas, izpildot stingras drošības prasības.
TPU 8i Max risina milzīgu kontekstu logu izaicinājumu, kas nepieciešams aģentiskiem AI, kas pamatojas uz plašu datu avotu, piemēram, koda bāzēm vai video. Apvienojot divas TPU 8i mikroshēmas, tas dubulto aprēķinu jaudu, SRAM un augsta joslas platuma atmiņu, ļaujot lielām darba slodzēm darboties bez apstāšanās un palielinot aprēķinu blīvumu uz viena plaukta ietilpību.
Šīs četras sistēmas kopumā nodrošina speciāli izstrādātus akceleratorus, optimizētus dažādiem AI dzīves cikla posmiem: TPU 8t mēroga apmācībai, TPU 8i zemas latentuma spriešanai, TPU 8tx konfidenciālai skaitļošanai un TPU 8i Max lielam kontekstam un augstai aprēķinu blīvumam.
Papildus aparatūrai Google ir uzlabojis TPU pieejamību, atbalstot populāras ietvarprogrammas kā PyTorch, izmantojot atvērtā pirmkoda TorchTPU, ļaujot vienkārši izvietot un optimizēt bez koda pārrakstīšanas. Papildu rīki, piemēram, TPU aģentu komplekts un TPU Sync programmatūras slānis, atvieglo lielu TPU klasteru automatizētu piesaisti, atmiņas pārvaldību un mērogošanu.
Google uzsver kopdizaina pieeju ar Google DeepMind un AI darbinātas izstrādes metodes, lai ātri ieviestu inovācijas TPU aparatūrā un sistēmās. Šis integrētās izstrādes process paātrina attīstības ciklus un sagatavo infrastruktūru lielo aģentisko AI un lielo valodu modeļu pieaugošajām prasībām.
Papildu informācijai Google piedāvā detalizētu tiešraidi un tiešsaistes resursus, kas apraksta šo TPU sistēmu specifikācijas un spējas, lai dotu spēkus izstrādātājiem un uzņēmumiem efektīvi un droši izmantot nākamās paaudzes AI infrastruktūru.
Avoti un oriģinālziņas
Lasīt oriģinālo avotu ↗
Komentāri (0)
Komentāru vēl nav. Sāciet diskusiju.
Rakstīt komentāru
Komentāri tiek publicēti pēc moderēšanas. Jūsu vārds un komentārs būs redzami publiski. Konts