
Google stellt 2026 vier spezialisierte TPUs vor, darunter sichere und hochkontextbezogene Modelle
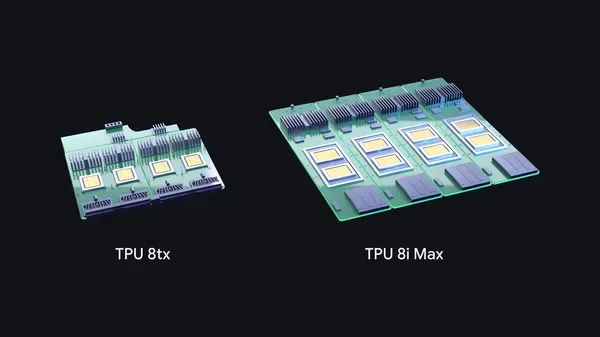
Image: Google · Source
Google erweitert seine TPU der achten Generation um TPU 8tx und TPU 8i Max, ergänzt TPU 8t und 8i, um sichere Inferenz und umfangreiche Kontextaufgaben für KI-Agenten zu adressieren.
Im November 2026 kündigte Google eine bedeutende Erweiterung seines Portfolios der achten Generation von Tensor Processing Units (TPUs) an, indem zwei neue Systeme – TPU 8tx und TPU 8i Max – zusammen mit den zuvor eingeführten TPU 8t und 8i vorgestellt wurden. Dies ist das erste Mal, dass Google vier TPU-Varianten innerhalb eines Jahres veröffentlicht, was die zunehmende Komplexität der KI-Arbeitslasten und den Bedarf an spezialisierter Hardware widerspiegelt.
Ursprünglich vor über einem Jahrzehnt entwickelt, um Googles interne Anforderungen an KI wie Spracherkennung und maschinelle Übersetzung zu unterstützen, haben sich TPUs weiterentwickelt, um vielfältige Anwendungen zu bedienen, einschließlich Training und Bereitstellung der Gemini KI-Modelle, agentenbasierter Arbeitslasten und Bereitstellung von Clouddiensten für eine wachsende Kundenbasis von nahezu 100 Organisationen weltweit.
Der TPU 8t wurde für groß angelegtes Training von grundlegenden KI-Modellen entwickelt und konzentriert sich darauf, die Trainingsleistung zu maximieren, gemessen an der nützlichen Intelligenz pro Watt. Die TPU 8i-Variante zielt auf Echtzeit-Reasoning-Aufgaben durch effiziente Bewältigung von Speicherengpässen und Reduzierung von Verzögerungen in der Chip-zu-Chip-Kommunikation ab.
Der neu angekündigte TPU 8tx richtet sich an sichere und vertrauliche KI-Inferenz-Arbeitslasten und erfüllt die Anforderungen regulierter Sektoren wie Unternehmen und Regierungsbehörden. Er verwendet denselben Siliziumchip wie der TPU 8t kombiniert mit AMD EPYC CPUs. Der TPU 8tx integriert Hardwareverschlüsselung, um sensible Daten und Modellparameter während aktiver Nutzung zu schützen, während durch ein spezialisiertes Boardfly-Netzwerk eine geringe Latenz erhalten bleibt. Dieses System unterstützt private Feinabstimmung, Destillation und Reinforcement Learning auf einer einzigen Plattform ohne Datenmigration und erfüllt damit strenge Sicherheitsanforderungen.
Der TPU 8i Max adressiert die Herausforderung enorm großer Kontextfenster, die für agentenbasierte KI benötigt werden, die über umfassende Daten wie Codebasen oder Videos strategisch schließt. Durch das Kombinieren zweier TPU 8i-Chips verdoppelt er Rechenleistung, SRAM und Hochgeschwindigkeitsspeicher, ermöglicht das Ausführen großer Arbeitslasten ohne Unterbrechungen und erhöht die Rechendichte pro Rackfläche.
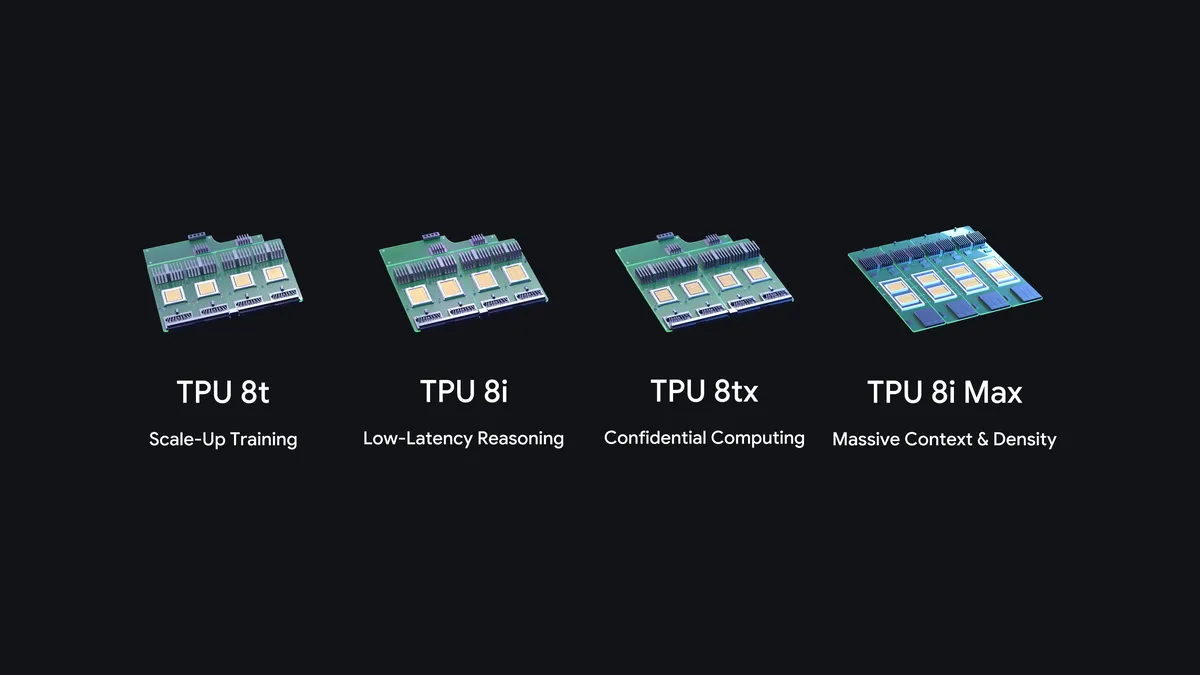
Diese vier Systeme bieten gemeinsam zweckoptimierte Beschleuniger, die für verschiedene Phasen des KI-Lebenszyklus optimiert sind: TPU 8t für Skalierungstraining, TPU 8i für latenzarmes Reasoning, TPU 8tx für vertrauliches Computing und TPU 8i Max für kontextreiche und hochdichte Berechnungen.
Ergänzend zur Hardware hat Google die Zugänglichkeit der TPUs verbessert, indem beliebte Frameworks wie PyTorch durch das Open-Source-Projekt TorchTPU unterstützt werden, was eine nahtlose Bereitstellung und Optimierung ohne Codeumstrukturierung ermöglicht. Weitere Tools wie die TPU-Agent-Suite und die TPU-Sync-Software-Schicht erleichtern automatisiertes Onboarding, Speicherverwaltung und das Skalieren großer TPU-Cluster.
Google betont einen Co-Design-Ansatz mit Google DeepMind und KI-gestützte Entwicklungstechniken, um TPU-Hardware und -Systeme schnell zu innovieren. Dieser integrierte Designprozess beschleunigt Entwicklungszyklen und bereitet die Infrastruktur auf die wachsenden Anforderungen durch agentenbasierte KI und große Sprachmodelle vor.
Für weitere Informationen bietet Google eine ausführliche Übertragung und Online-Ressourcen, die die Spezifikationen und Fähigkeiten dieser TPU-Systeme beschreiben, mit dem Ziel, Entwickler und Unternehmen zu befähigen, die nächste Generation der KI-Infrastruktur effizient und sicher zu nutzen.
Quellen und Originalberichte
Read the original source ↗
Kommentare (0)
Noch keine Kommentare.
Kommentar schreiben
Kommentare erscheinen nach Moderation. Name und Kommentar werden öffentlich angezeigt. Konto