
Google wprowadza cztery wyspecjalizowane układy TPU w 2026 roku, w tym modele bezpieczne i obsługujące duże konteksty
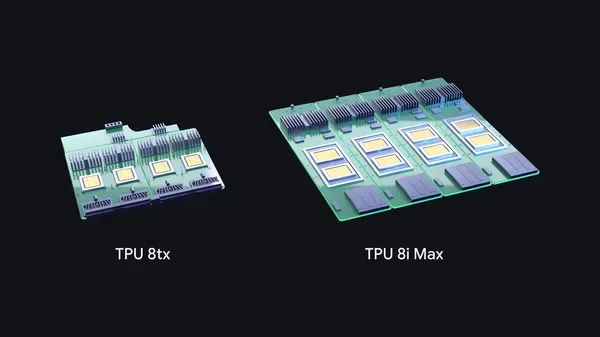
Image: Google · Source
Google rozszerza swoją ósmą generację układów TPU o modele TPU 8tx i TPU 8i Max, uzupełniając TPU 8t i 8i, aby sprostać wymogom bezpiecznej inferencji i ogromnym kontekstom obciążenia dla agentów AI.
W listopadzie 2026 roku Google ogłosiło znaczące rozszerzenie swojego portfolio ósmej generacji Tensor Processing Unit (TPU) poprzez wprowadzenie dwóch nowych systemów, TPU 8tx i TPU 8i Max, obok wcześniej zaprezentowanych TPU 8t i TPU 8i. Jest to pierwszy raz, gdy Google wypuszcza cztery warianty TPU w ciągu jednego roku, co odzwierciedla rosnącą złożoność obciążeń AI i potrzebę specjalistycznego sprzętu.
Układy TPU pierwotnie zostały opracowane ponad dekadę temu, aby wspierać wewnętrzne potrzeby AI Google, takie jak rozpoznawanie mowy i tłumaczenie językowe. Od tego czasu ewoluowały, aby obsługiwać różnorodne zastosowania, w tym trening i wdrażanie modeli Gemini AI, obciążenia agentowe oraz świadczenie usług w chmurze rosnącej liczbie klientów, sięgającej około 100 organizacji na całym świecie.
TPU 8t został zaprojektowany do treningu dużych, podstawowych modeli AI, koncentrując się na maksymalizacji wydajności treningu mierzonej jako użyteczna inteligencja na wat energii. Wariant TPU 8i jest skierowany do zadań wnioskowania w czasie rzeczywistym poprzez efektywne rozwiązywanie problemów z pamięcią i redukcję opóźnień komunikacji między układami.
Nowo zaprezentowany TPU 8tx jest dedykowany do bezpiecznych i poufnych obciążeń inferencji AI, spełniając wymagania regulowanych sektorów, takich jak przedsiębiorstwa i agencje rządowe. Korzysta z tego samego krzemu co TPU 8t, połączonego z procesorami AMD EPYC. TPU 8tx zawiera sprzętowe szyfrowanie mające na celu ochronę wrażliwych danych i parametrów modeli podczas aktywnego użytkowania, zachowując niskie opóźnienia dzięki specjalizowanej sieci Boardfly. System ten wspiera prywatne dostrajanie, destylację oraz uczenie ze wzmocnieniem na jednej platformie bez konieczności migracji danych, spełniając rygorystyczne wymagania bezpieczeństwa.
TPU 8i Max odpowiada na wyzwanie ogromnych okien kontekstowych, niezbędnych dla agentowego AI rozumującego na podstawie obszernego materiału, takiego jak bazy kodu czy wideo. Łącząc dwa układy TPU 8i, podwaja moc obliczeniową, pamięć SRAM oraz pamięć o wysokiej przepustowości, umożliwiając płynne wykonywanie dużych obciążeń bez przestojów i zwiększając gęstość obliczeniową na jednostkę powierzchni szafy rack.
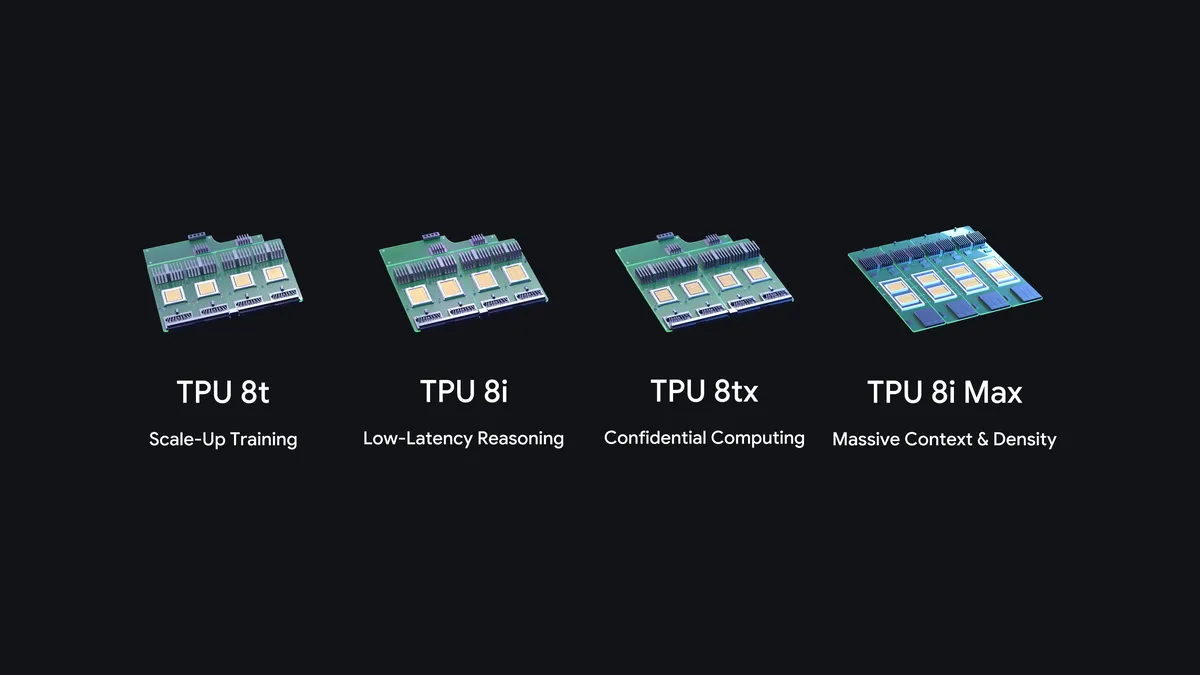
Te cztery systemy razem tworzą specjalistyczne przyspieszacze zoptymalizowane pod różne etapy cyklu życia AI: TPU 8t do treningu na dużą skalę, TPU 8i do wnioskowania o niskich opóźnieniach, TPU 8tx do obliczeń poufnych oraz TPU 8i Max do obliczeń z dużym kontekstem i wysoką gęstością.
Dopełnieniem sprzętu jest zwiększona dostępność TPU dzięki wsparciu popularnych frameworków, takich jak PyTorch, poprzez otwartoźródłowy TorchTPU, umożliwiający płynne wdrożenia i optymalizacje bez konieczności przepisywania kodu. Dodatkowe narzędzia, takie jak zestaw TPU agent i warstwa oprogramowania TPU Sync, ułatwiają automatyczne wdrażanie, zarządzanie pamięcią oraz skalowanie dużych klastrów TPU.
Google podkreśla podejście współprojektowe z Google DeepMind i techniki rozwoju oparte na AI, aby szybko wprowadzać innowacje w sprzęcie i systemach TPU. Ten zintegrowany proces projektowy przyspiesza cykle rozwojowe i przygotowuje infrastrukturę na rosnące wymagania wywołane przez agentowe AI i duże modele językowe.
Więcej informacji można znaleźć w szczegółowej transmisji oraz zasobach online Google, które prezentują specyfikacje i możliwości tych systemów TPU, pozwalając deweloperom i przedsiębiorstwom efektywnie i bezpiecznie korzystać z infrastruktury AI następnej generacji.
Źródła i oryginalne doniesienia
Read the original source ↗
Komentarze (0)
Nie ma jeszcze komentarzy.
Napisz komentarz
Komentarze publikujemy po moderacji. Nazwa i komentarz będą publiczne. Konto