
Platforma NVIDIA Vera Rubin dominuje w benchmarkach MLPerf Training i Endpoints
Image: NVIDIA · Source
Nowa platforma NVIDIA Vera Rubin zajmuje czołowe miejsca we wszystkich kategoriach benchmarków MLPerf Training v6.1 i oferuje ponad 10-krotną poprawę efektywności w przepustowości agentic AI per wat w MLPerf Endpoints.
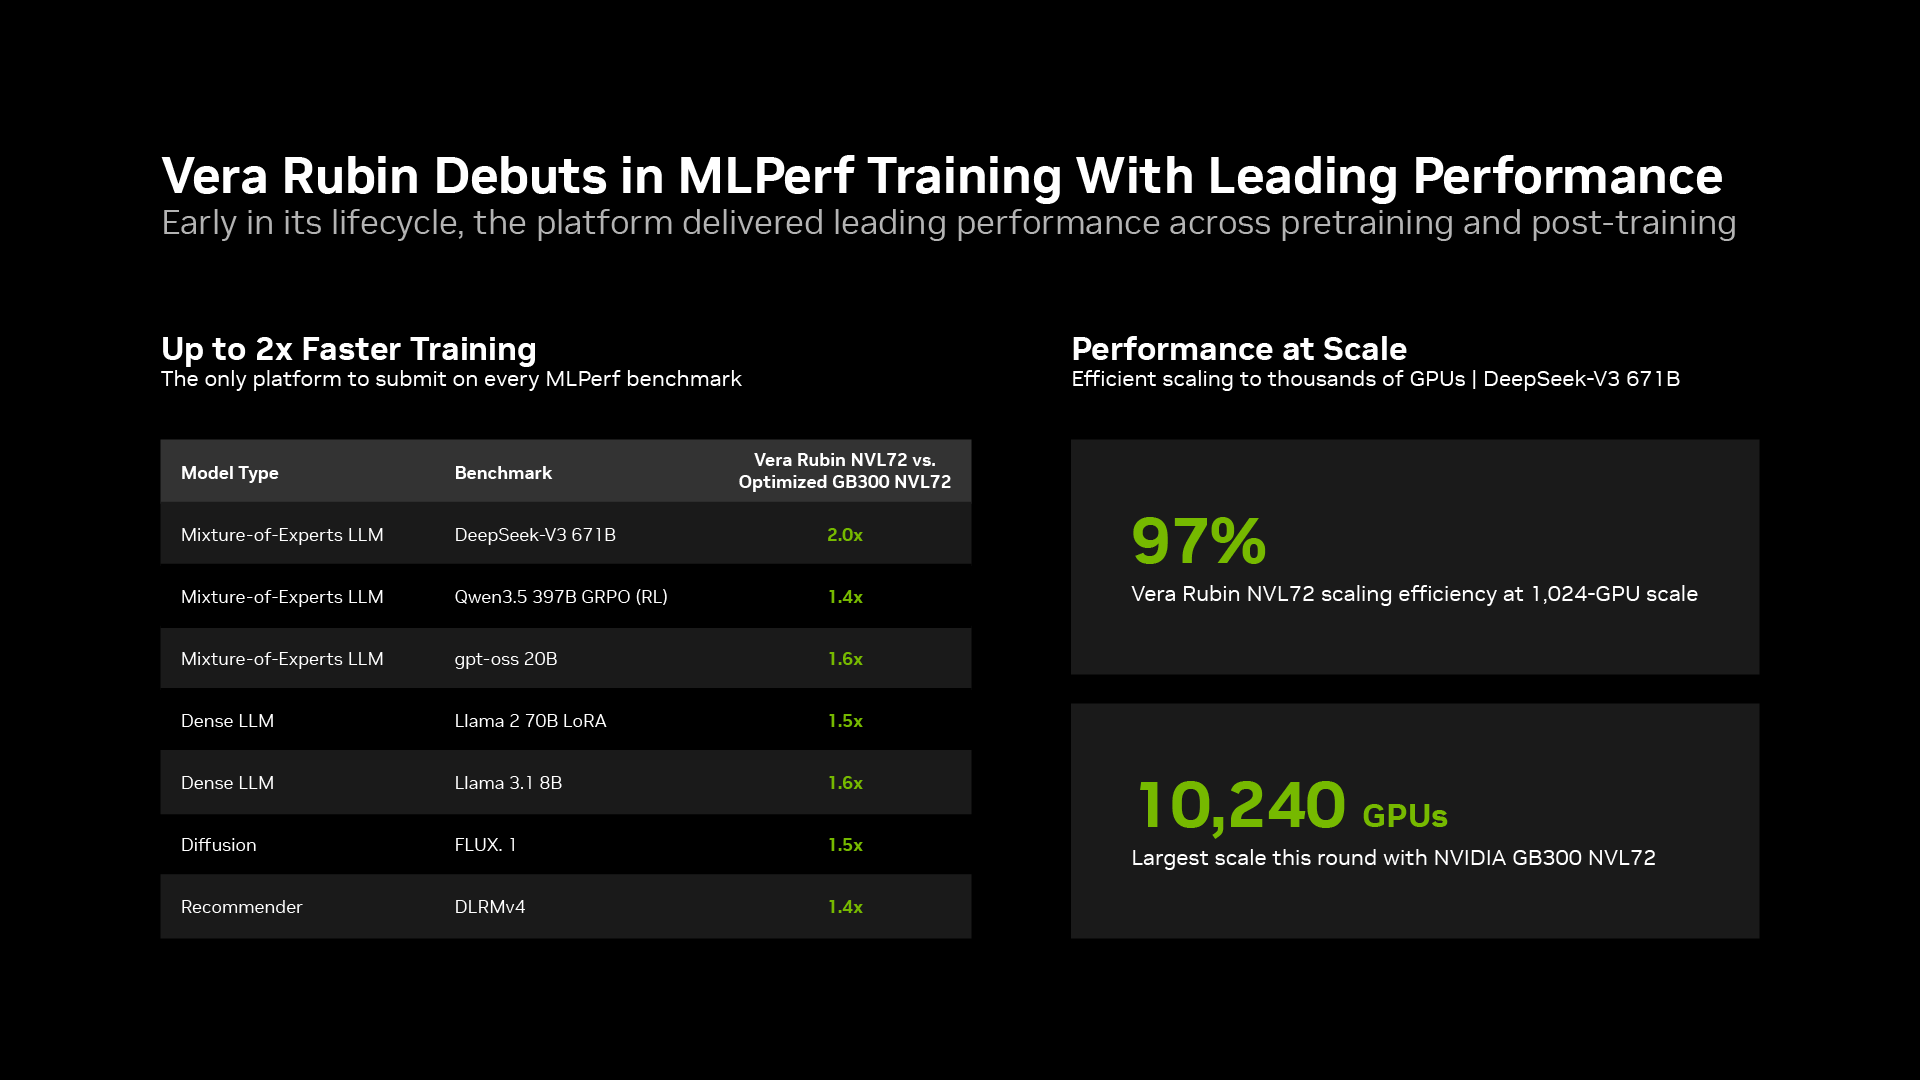
NVIDIA odniosła zdecydowane zwycięstwo dzięki platformie Vera Rubin w najnowszych wynikach benchmarków MLPerf, oznaczając silny debiut zarówno w metrykach wydajności treningu, jak i wnioskowania. W niedawno opublikowanych benchmarkach MLPerf Training v6.1 system Vera Rubin firmy NVIDIA był jedyną platformą, która dostarczyła wyniki dla każdego testu, obejmującego duże modele językowe, generowanie obrazów, systemy rekomendacyjne oraz uczenie ze wzmocnieniem po treningu. Osiągnął do dwukrotnie wyższej wydajności na GPU w porównaniu do wysoko zoptymalizowanego systemu NVIDIA GB300, podkreślając szybkie poprawki generacyjne w sprzęcie i oprogramowaniu.
Skalowalność była szczególnie godna uwagi w przypadku platformy Vera Rubin, zwłaszcza w benchmarku DeepSeek-V3, gdzie system utrzymał około 97% efektywności skalowania od 256 do 1024 GPU, skracając czas treningu z 16 do około 4 minut. NVIDIA zademonstrowała również trening na ogromną skalę: systemy GB300 prowadziły benchmarki z użyciem 10 240 GPU, co było największą skalą obserwowaną w tej rundzie, równolegle z Microsoft Azure używającym systemów GB200. Podkreśla to znaczenie efektywnej koordynacji wielu GPU, osiąganej dzięki sieciowaniu NVLink scale-up firmy NVIDIA w ramach systemów oraz Quantum-X800 InfiniBand i Spectrum-X Ethernet scale-out w centrach danych.
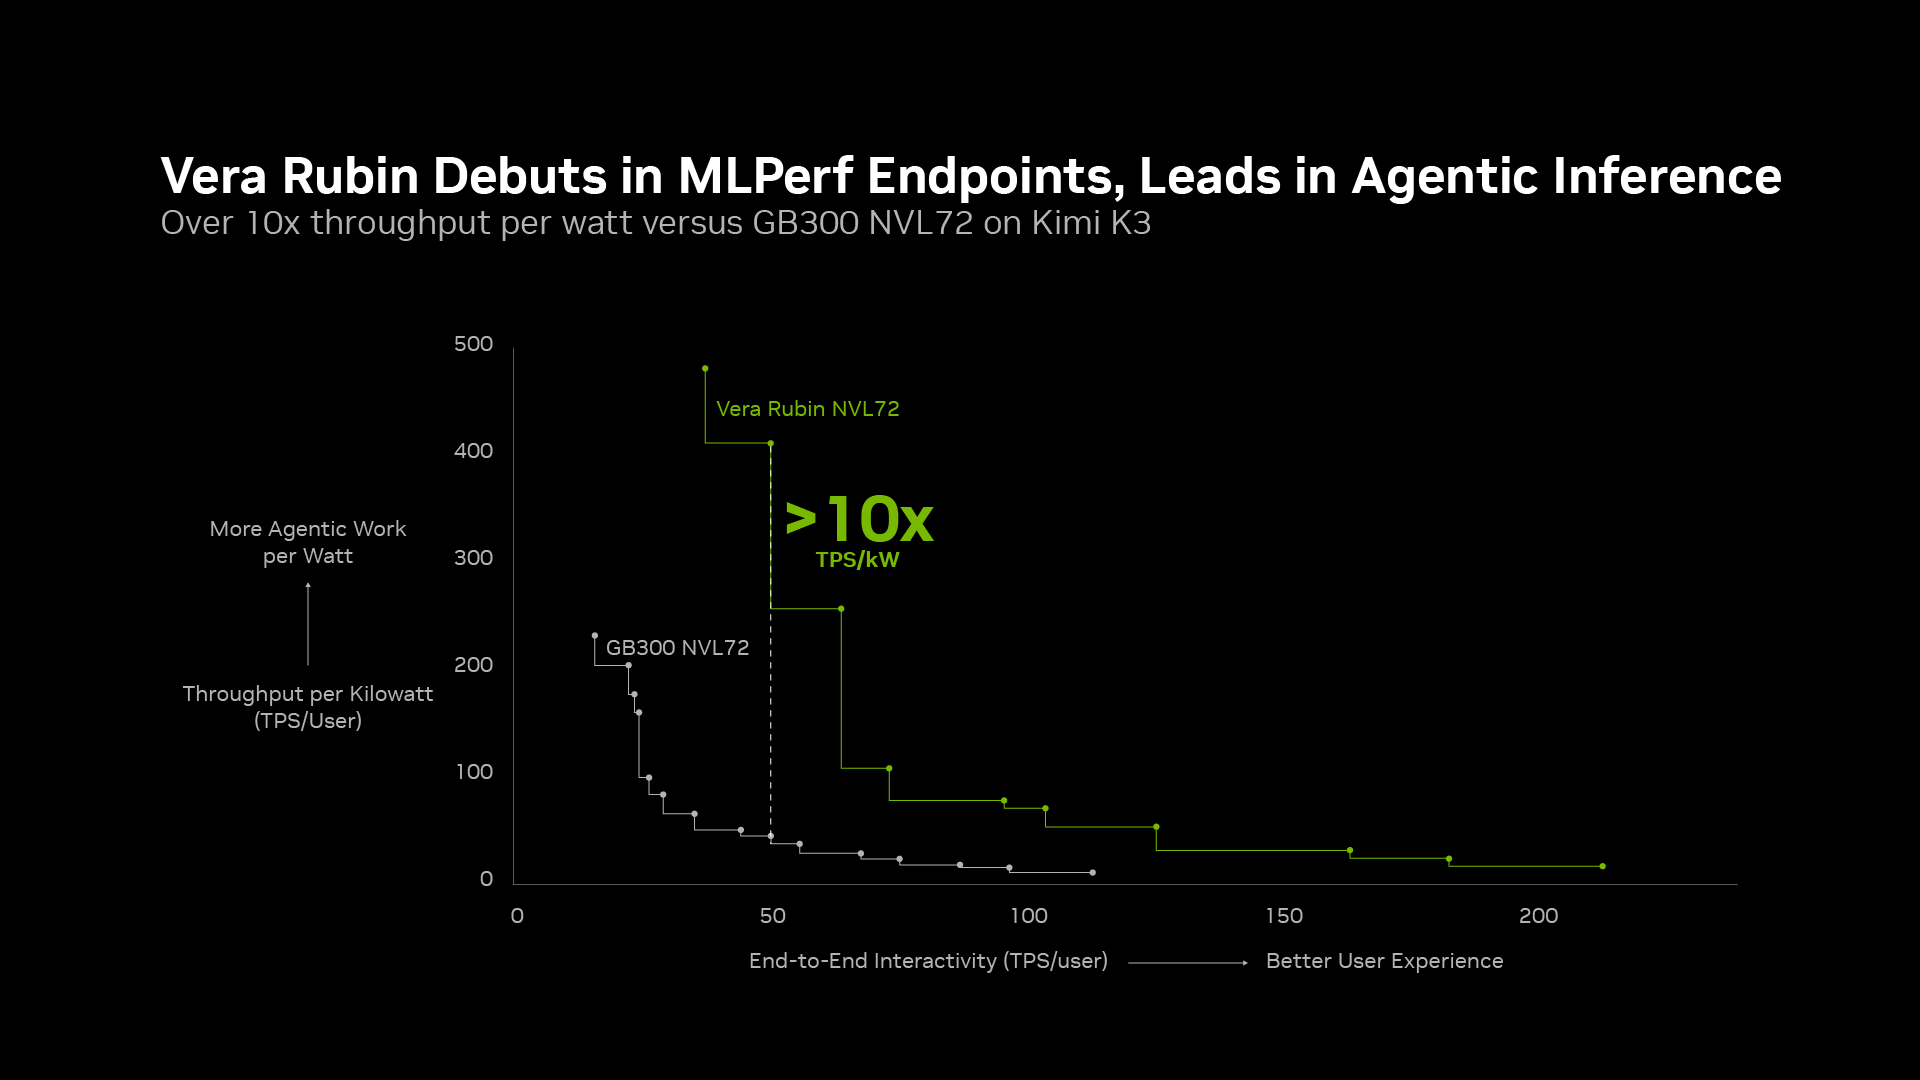
Po raz pierwszy w MLPerf Endpoints, skupiających się na agentic AI inference, platformy Vera Rubin dostarczyły ponad dziesięciokrotną poprawę przepustowości na wat w porównaniu do systemów poprzedniej generacji, takich jak GB300, zachowując jednocześnie niskie opóźnienia odpowiedzi. Jest to kluczowe, gdyż zadania agentic AI często wymagają rozumowania wieloetapowego i wielokrotnych wywołań narzędzi, generując wiele tokenów na każdą wykonaną akcję. Wyższa generacja tokenów na wat oznacza, że centra danych mogą obsługiwać więcej agentów AI jednocześnie przy niższych kosztach energii.
Ekosystem partnerów NVIDIA odegrał kluczową rolę w tych osiągnięciach, z wynikami przesłanymi przez 20 organizacji, w tym Asus, Cisco, Dell Technologies, Google Cloud, HPE, Oracle, Supermicro i innych. Te wkłady odzwierciedlają wszechstronność i potencjał optymalizacji stosu oprogramowania opartego na CUDA w połączeniu z najnowszą architekturą sprzętową firmy NVIDIA.
Poza MLPerf, Vera Rubin prowadzi także w niezależnych benchmarkach agentów AI, takich jak SemiAnalysis AgentX i Artificial Analysis AgentPerf, potwierdzając swoje możliwości obejmujące wstępne trenowanie, post-training i agentic inference. Wspiera też wymagania obliczeń wysokowydajnych, co pokazano podczas niedawnej konferencji SC26. NVIDIA wskazuje, że trwające optymalizacje oprogramowania dalsze poprawią wydajność Vera Rubin, obiecując ciągły wzrost wartości dla klientów inwestujących w tę infrastrukturę.
Szczegółowe informacje techniczne można znaleźć na blogach NVIDIA dotyczących MLPerf Training i MLPerf Endpoints, które oferują kompleksową analizę osiągnięć benchmarków oraz konfiguracji systemów. Platforma Vera Rubin mocno ustanawia pozycję NVIDIA jako lidera w przyspieszaniu AI w skali, łącząc efektywność energetyczną z bezkonkurencyjną przepustowością i skalowalnością.
Źródła i oryginalne doniesienia
Read the original source ↗
Komentarze (0)
Nie ma jeszcze komentarzy.
Napisz komentarz
Komentarze publikujemy po moderacji. Nazwa i komentarz będą publiczne. Konto