
La plataforma NVIDIA Vera Rubin domina los benchmarks MLPerf Training y Endpoints
Image: NVIDIA · Source
La nueva plataforma Vera Rubin de NVIDIA lidera los benchmarks MLPerf Training v6.1 en todas las categorías y ofrece más de 10 veces mejoras en eficiencia en el rendimiento de IA agente por vatio en MLPerf Endpoints.
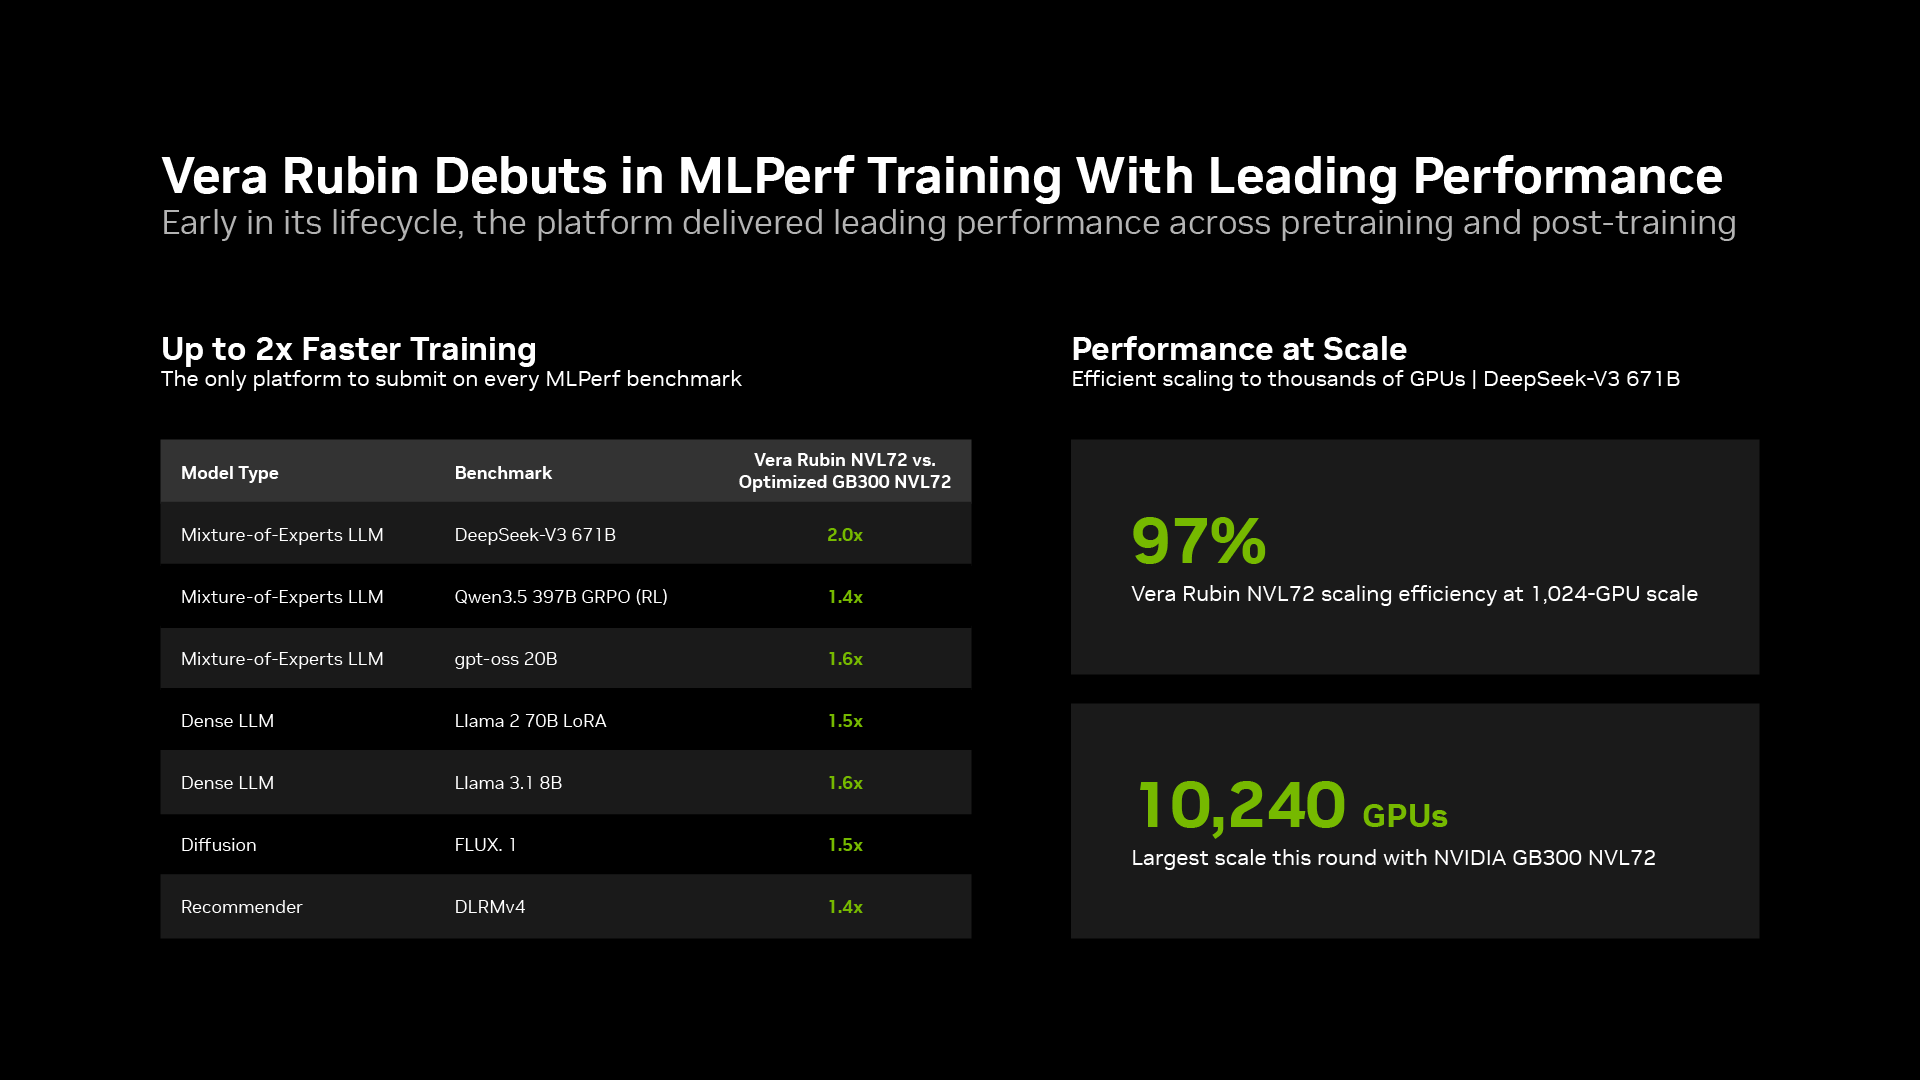
NVIDIA ha logrado una victoria contundente con su plataforma Vera Rubin en los últimos resultados de benchmarking MLPerf, marcando un debut sólido tanto en métricas de desempeño de entrenamiento como de inferencia. En los benchmarks MLPerf Training v6.1 recientemente publicados, el sistema Vera Rubin de NVIDIA fue la única plataforma que presentó resultados para cada benchmark, abarcando grandes modelos de lenguaje, generación de imágenes, sistemas de recomendación y aprendizaje por refuerzo posterior al entrenamiento. Ofreció hasta el doble de rendimiento por GPU en comparación con el sistema NVIDIA GB300 altamente optimizado, resaltando rápidas mejoras generacionales en su hardware y software.
La escalabilidad fue un punto destacado para Vera Rubin, especialmente en el benchmark DeepSeek-V3, donde el sistema mantuvo aproximadamente un 97% de eficiencia de escalado desde 256 hasta 1,024 GPUs, reduciendo el tiempo de entrenamiento de 16 minutos a cerca de cuatro minutos. NVIDIA también demostró entrenamientos a escala masiva: los sistemas GB300 ejecutaron benchmarks utilizando 10,240 GPUs, la mayor escala observada en esta ronda, igualada por Microsoft Azure usando sistemas GB200. Esto subraya la importancia de una coordinación eficiente entre múltiples GPUs, lograda mediante la red NVLink de NVIDIA para escalado dentro de sistemas, y las redes Quantum-X800 InfiniBand y Spectrum-X Ethernet para escalado entre centros de datos.
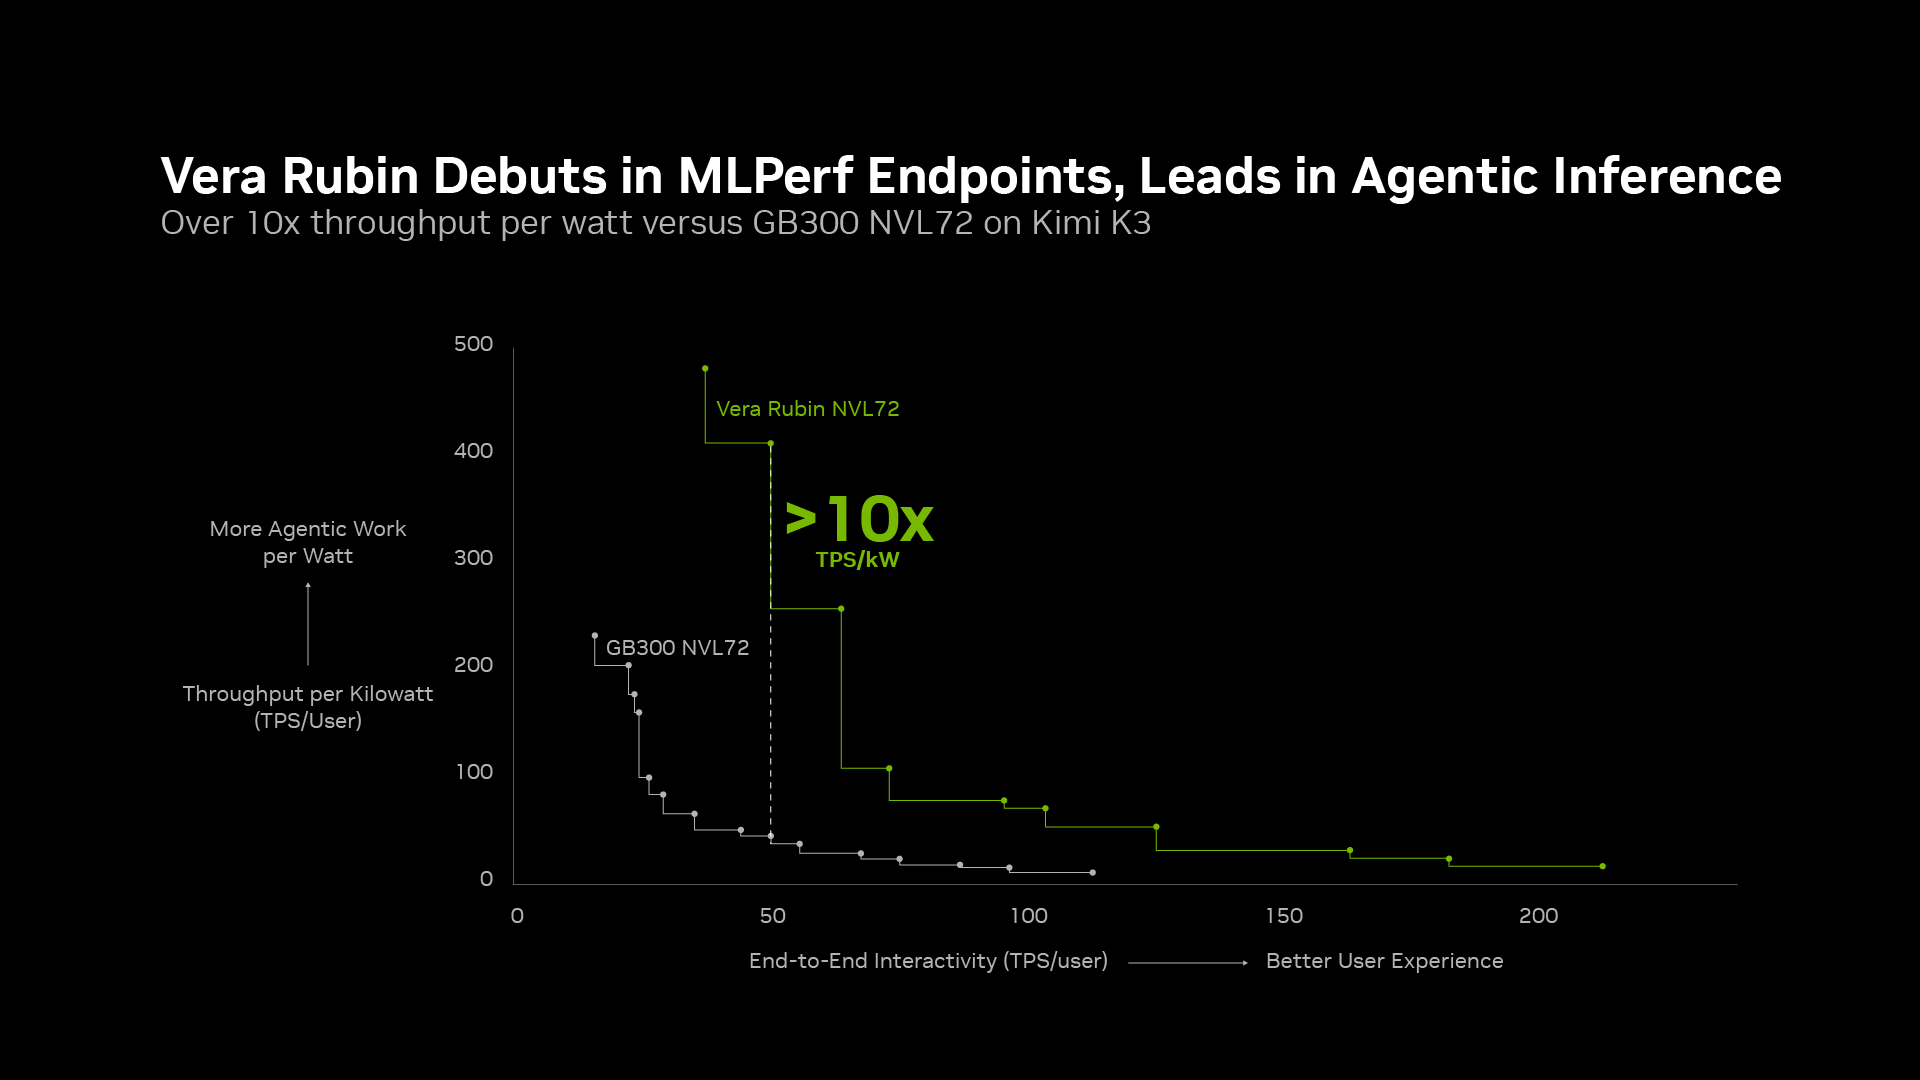
Por primera vez para NVIDIA en MLPerf Endpoints, enfocados en cargas de trabajo de inferencia de IA agente, las plataformas Vera Rubin entregaron más de diez veces la mejora en rendimiento por vatio comparado con sistemas de generaciones anteriores como el GB300, manteniendo latencias de respuesta. Esto es fundamental porque las tareas de IA agente suelen requerir razonamiento multi paso e invocaciones repetidas de herramientas, generando muchos tokens por cada acción completada. Una generación más alta de tokens por vatio significa que los centros de datos pueden servir a más agentes de IA simultáneamente con costos energéticos reducidos.
El ecosistema de socios de NVIDIA jugó un papel clave en estos logros, con envíos de 20 organizaciones incluyendo Asus, Cisco, Dell Technologies, Google Cloud, HPE, Oracle, Supermicro y otros. Estas contribuciones reflejan la versatilidad y el potencial de optimización de la pila de software impulsada por CUDA de NVIDIA combinada con su última arquitectura de hardware.
Más allá de MLPerf, Vera Rubin también lidera en benchmarks independientes de agentes de IA como SemiAnalysis AgentX y Artificial Analysis AgentPerf, confirmando su capacidad en cargas de trabajo de preentrenamiento, postentrenamiento e inferencia agente. También soporta demandas de computación de alto rendimiento, como se mostró en la reciente conferencia SC26. NVIDIA indica que las optimizaciones continuas de software mejorarán aún más el desempeño de Vera Rubin, prometiendo una expansión continua de valor para los clientes que invierten en esta infraestructura.
Para detalles técnicos, los blogs de NVIDIA sobre MLPerf Training y MLPerf Endpoints ofrecen análisis completos de los logros del benchmark y las configuraciones subyacentes del sistema. La plataforma Vera Rubin establece firmemente el liderazgo de NVIDIA en acelerar el entrenamiento e inferencia de IA a escala, combinando eficiencia energética con un rendimiento y escalabilidad inigualables.
Fuentes e informes originales
Read the original source ↗
Comentarios (0)
Aún no hay comentarios.
Escribe un comentario
Los comentarios se publican tras moderación. Tu nombre y comentario serán públicos. Cuenta