
El Protocolo de Comunicación de Agentes de IA MCP Enfrenta Fallos Críticos de Seguridad

Image: Ars Technica · Source
Un investigador de seguridad descubre vulnerabilidades en el Protocolo de Contexto del Modelo (MCP), ampliamente utilizado para la comunicación entre agentes de IA, que permiten que comandos maliciosos se propaguen y escalen dentro de redes.
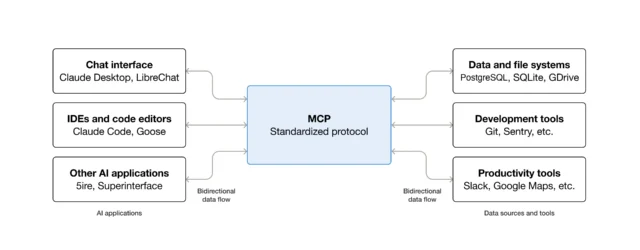
El Protocolo de Contexto del Modelo (MCP), un nuevo estándar que facilita la comunicación entre agentes de IA dentro de redes internas, ha sido encontrado con vulnerabilidades de seguridad significativas que amenazan las implementaciones empresariales de IA en todo el mundo. El investigador independiente Syed Anas Mohiuddin demostró recientemente una serie de ataques que explotan brechas de confianza inherentes al MCP, permitiendo que instrucciones maliciosas se propaguen entre agentes de IA dentro de las organizaciones.
Estos ataques representan una forma especializada de inyección de instrucciones (prompt injection) que no apunta a los modelos de lenguaje extensos subyacentes (LLMs), sino a agentes individuales dedicados a funciones específicas como traducción o análisis de datos. Muchos de estos agentes carecen de salvaguardas internas adecuadas, permitiendo que comandos dañinos de un agente comprometido sean confiados y ejecutados por otros agentes en cascada. El problema se agrava porque los servidores MCP almacenan credenciales que confían implícitamente en agentes pares, permitiendo a los atacantes aprovechar esta confianza para ejecutar acciones no autorizadas.
Mohiuddin probó agentes afectados de organizaciones prominentes como Google, JP Morgan Chase, Rapid7, el gobierno francés y otros, revelando que la técnica de explotación —denominada “pivotamiento de protocolo” (protocol pivoting)— permite a un adversario obtener acceso inicial a través de un protocolo de comunicación y escalar permisos explotando supuestos de confianza a través de diferentes protocolos. Por ejemplo, un atacante podría usar MCP para asignar una tarea maliciosa a un agente, el cual luego reenvía comandos dañinos mediante protocolos alternativos como el protocolo Google Agent-to-Agent (A2A) o estándares emergentes como el Protocolo de Red de Agentes.
De manera notable, las vulnerabilidades identificadas incluyeron un fallo en la caja de herramientas MCP de Google para bases de datos, que carecía de políticas robustas de validación de redirecciones, permitiendo a los atacantes inducir ataques de falsificación de solicitud del lado del servidor (SSRF). Google mitigó esto implementando listas de permiso estrictas por IP y rechazando URLs base inseguras al iniciar. Rapid7 abordó una vulnerabilidad relacionada con MCP con una puntuación de severidad baja pero actuó rápidamente con medidas correctivas.
Expertos enfatizan que los desafíos surgen porque MCP y protocolos relacionados fueron diseñados bajo el supuesto de operación aislada sin verificaciones integrales de confianza cruzada entre protocolos. Douglas McKee de Rapid7 subrayó que “cada protocolo revisa su propia puerta principal mientras nadie vigila el pasillo intermedio,” destacando puntos ciegos arquitectónicos.
Aunque algunos investigadores clasifican estas explotaciones como una subclase de inyección de instrucciones—inyección indirecta—debido a que las entradas maliciosas atraviesan límites de protocolos, la amplia aplicabilidad de la técnica de pivotamiento entre diversas organizaciones señala problemas sistémicos en las redes actuales de agentes IA.
La lección fundamental para desarrolladores y arquitectos de sistemas es la necesidad de adoptar principios de confianza cero dentro de los ecosistemas de agentes de IA. Las entradas pasadas desde LLMs u otros agentes deben ser tratadas con la misma sospecha que datos no confiables de internet, con pasos rigurosos de validación y autorización. Las mitigaciones establecidas contra inyección y vulnerabilidades SSRF siguen siendo relevantes y deben integrarse en flujos de trabajo modernos de IA.
A medida que la adopción de agentes de IA se acelera, descubrir y abordar estas brechas de seguridad en MCP y protocolos relacionados es crítico para salvaguardar datos sensibles y mantener la confianza en sistemas automatizados.
Fuentes e informes originales
Read the original source ↗
Comentarios (0)
Aún no hay comentarios.
Escribe un comentario
Los comentarios se publican tras moderación. Tu nombre y comentario serán públicos. Cuenta