
AI-agentkommunikationsprotokollet MCP har kritiska säkerhetsbrister

Bild: Ars Technica · Källa
En säkerhetsforskare har avslöjat sårbarheter i Model Context Protocol (MCP), som används brett för kommunikation mellan AI-agenter, vilket möjliggör spridning och eskalering av skadliga kommandon inom nätverk.
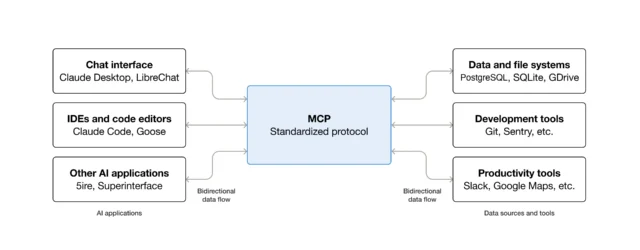
Model Context Protocol (MCP), en ny standard som möjliggör kommunikation mellan AI-agenter inom interna nätverk, har visat sig innehålla betydande säkerhetssårbarheter som hotar företags-implementeringar av AI globalt. Den oberoende forskaren Syed Anas Mohiuddin demonstrerade nyligen en serie attacker som utnyttjar tillitsluckor inneboende i MCP, vilket tillåter att skadliga instruktioner sprids mellan AI-agenter inom organisationer.
Dessa attacker är en specialiserad form av promptinjektion som inte riktar sig mot de underliggande stora språkmodellerna (LLM) utan mot enskilda agenter dedikerade till specifika funktioner såsom översättning eller dataanalys. Många sådana agenter saknar tillräckliga interna skydd, vilket tillåter att skadliga kommandon från en komprometterad agent accepteras och utförs av andra agenter längre ner i kedjan. Problemet förvärras av att MCP-servrar lagrar autentiseringsuppgifter som implicit litar på peer-agenter, vilket gör att angripare kan utnyttja denna tillit för att utföra obehöriga handlingar.
Mohiuddin testade påverkade agenter från framstående organisationer som Google, JP Morgan Chase, Rapid7, den franska regeringen och andra. Han avslöjade att exploateringstekniken — kallad "protocol pivoting" — gör det möjligt för en angripare att initialt få åtkomst via ett kommunikationsprotokoll och sedan eskalera rättigheter genom att utnyttja tillitssatser mellan olika protokoll. Exempelvis kan en angripare använda MCP för att tilldela en skadlig uppgift till en agent, som sedan vidarebefordrar skadliga kommandon via alternativa protokoll som Googles Agent-to-Agent (A2A) protokoll eller framväxande standarder som Agent Network Protocol.
Bland de identifierade sårbarheterna fanns en brist i Googles MCP-verktygslåda för databaser, som saknade robusta valideringsregler för omdirigeringar och därmed tillät attacker via server-side request forgery (SSRF). Google åtgärdade detta genom strikt IP-allowlistning och genom att avvisa osäkra bas-URL:er vid uppstart. Rapid7 åtgärdade en relaterad MCP-sårbarhet med låg allvarlighetsgrad snabbt.
Experter betonar att problemen uppstått eftersom MCP och relaterade protokoll designades med antagandet att de skulle fungera isolerat, utan omfattande kontroller över tillit mellan protokoll. Douglas McKee från Rapid7 påpekade att "varje protokoll kontrollerar sin egen ytterdörr medan ingen vaknar över korridoren däremellan," vilket belyser arkitektoniska blinda fläckar.
Vissa forskare klassificerar dessa attacker som en underkategori av promptinjektion — indirekt promptinjektion — eftersom skadliga instruktioner passerar protokollgränser, men den breda tillämpligheten för pivot-tekniken över olika organisationer antyder systemiska problem i nuvarande AI-agentnätverk.
Den grundläggande lärdomen för utvecklare och systemarkitekter är behovet av att tillämpa zero-trust-principer i AI-agentekosystem. Indata från LLM:er eller andra agenter bör behandlas med samma misstänksamhet som osäkra internetdata, med rigorösa validerings- och auktoriseringssteg. Befintliga motåtgärder mot injektions- och SSRF-sårbarheter är fortsatt relevanta och bör integreras i moderna AI-arbetsflöden.
I takt med att användningen av AI-agenter accelererar är det avgörande att identifiera och åtgärda dessa säkerhetsbrister i MCP och relaterade protokoll för att skydda känslig data och upprätthålla förtroendet för automatiserade system.
Källor och ursprunglig rapportering
Läs den ursprungliga källan ↗
Kommentarer (0)
Inga kommentarer ännu. Börja diskussionen.
Skriv en kommentar
Kommentarer publiceras efter granskning. Ditt namn och kommentar syns offentligt. Konto