
AI-agendi kommunikatsiooniprotokoll MCP seisab silmitsi kriitiliste turvaaukudega

Pilt: Ars Technica · Allikas
Turvauurija avastas Model Context Protocol (MCP) haavatavused, mida laialdaselt kasutatakse AI-agendi vaheliseks suhtluseks, võimaldades pahatahtlikel käskudel võrku levida ning seal eskaleeruda.
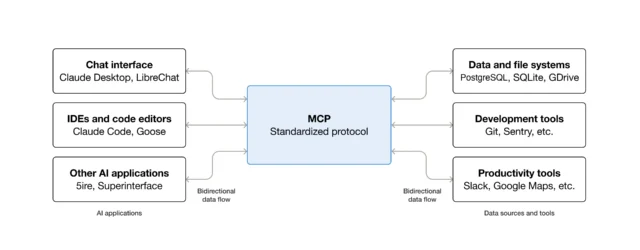
Model Context Protocol (MCP), uus standard AI-agendidevahelise suhtluse hõlbustamiseks ettevõtete sisevõrkudes, on tuvastatud kui sisaldav olulisi turvariske, mis ohustavad AI-lahenduste kasutamist üle maailma. Iseseisev uurija Syed Anas Mohiuddin demonstreeris hiljuti mitmeid rünnakuid, mis kasutavad MCP sisemisi usalduslünki, lubades pahatahtlikel käsklustel liikuda AI-agendide vahel organisatsioonides.
Need rünnakud on spetsiaalne tüüp promptisüstituse (prompt injection) vormist, mis ei ründa otseselt suuri keelemudeleid (LLM-e), vaid individuaalseid agente, kes tegelevad kindlate funktsioonidega, nagu tõlkimine või andmeanalüüs. Paljud sellised agendid ei oma piisavat sisejulgeolekut, võimaldades ühe kompromiteeritud agendi pahatahtlike käskluste usaldamist ja täitmist teistel alluvatel agentidel. Probleemi süvendab MCP serverite kalduvus hoida mandaate, mis automaatselt usaldavad eakaaslasi, laskes ründajatel seda usaldust ära kasutada volitamata tegevuste teostamiseks.
Mohiuddin testis haavatavaid agente tuntud organisatsioonidest nagu Google, JP Morgan Chase, Rapid7, Prantsuse valitsus ja teised, paljastades et selle ründeviisi, mida nimetatakse “protokolli pööramiseks” (protocol pivoting), abil saab ründaja esialgse ligipääsu ühest kommunikatsiooniprotokollist ning seejärel eskaleerida õigusi, kasutades ära usalduse eeldusi erinevate protokollide vahel. Näiteks võib ründaja kasutada MCP-d halbade ülesannete määramiseks agendile, kes omakorda edastab kahjulikud käsud teise protokolli kaudu nagu Google'i Agent-to-Agent (A2A) protokoll või uued standardid nagu Agent Network Protocol.
Tähtsate haavatavustena tuvastati Google'i MCP tööriistakast andmebaaside jaoks, mis puudulikult valideeris ümber suunamisi, lubades ründajatel tekitada serveripoolseid päringupettusi (SSRF). Google parandas selle rangete IP lubamise loendite ja ebaturvaliste baasaadresside käivitamisel tagasilükkamise abil. Rapid7 lahendas seotud MCP haavatavuse, mille raskusaste oli madal, kuid reageeris kiiresti.
Eksperdid rõhutavad, et probleemid tekkisid seetõttu, et MCP ja sellega seotud protokollid loodi oletusega, et toimuvad isoleeritud käivitused ilma põhjalike ristprotokolliliste usalduskontrollideta. Rapid7 Douglas McKee märkis, et „iga protokoll kontrollib oma ust, kuid keegi ei valva vahekäiku,“ osutades arhitektuurilistele pimedatele kohtadele.
Kuigi mõned uurijad liigitavad need rünnakud promptisüstituse alamtüübiks — kaudseks promptisüstituseks — kuna pahatahtlikud sisendid ületavad protokollipiire, viitab laialdane rakendatavus mitmes organisatsioonis sellele, et praegustes AI-agendivõrkudes on süsteemsed probleemid.
Arendajatele ja süsteemiarhitektidele on keskne õppetund vajadus rakendada nullusalduse (zero trust) põhimõtteid AI-agentide ökosüsteemides. LLM-ide või teiste agentide sisendit tuleks käsitleda sama ettevaatlikult kui usaldamata internetiandmeid, kasutades põhjalikku valideerimist ja volitamist. Kehtivad meetmed süstituste ja SSRF-i vastu on jätkuvalt olulised ning tuleks integreerida kaasaegsetesse AI töövoogudesse.
AI agentide kasutuselevõtt kiireneb ning MCP ja seotud protokollide turvaaukude avastamine ja likvideerimine on kriitilise tähtsusega tundlike andmete kaitseks ja automaatsete süsteemide usalduse säilitamiseks.
Allikad ja originaaluudised
Loe originaali allikat ↗
Kommentaarid (0)
Kommentaare veel pole. Alusta arutelu.
Kirjuta kommentaar
Kommentaarid avaldatakse pärast modereerimist. Sinu nimi ja kommentaar on avalikult nähtavad. Konto