
Dirbtinio intelekto agentų komunikacijos protokolas MCP susiduria su kritinėmis saugumo spragomis

Vaizdas: Ars Technica · Šaltinis
Saugumo tyrėjas atskleidžia Model Context Protocol (MCP) pažeidžiamumus, plačiai naudojamus AI agentų tarpusavio komunikacijoje, leidžiančius pavojingoms užklausoms plisti ir eskaluotis tinkluose.
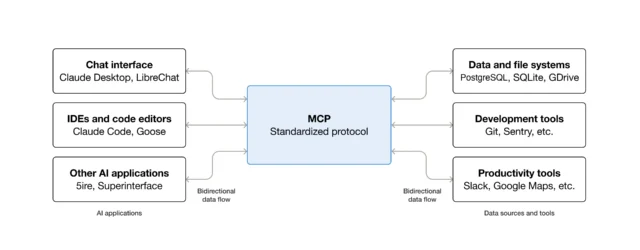
Model Context Protocol (MCP) – naujas standartas, palengvinantis komunikaciją tarp dirbtinio intelekto agentų vidiniuose tinkluose – atskleidė reikšmingas saugumo spragas, keliančias grėsmę verslo AI diegimams visame pasaulyje. Nepriklausomas tyrėjas Syed Anas Mohiuddin neseniai demonstravo kelis atakų scenarijus, išnaudojančius pasitikėjimo spragas MCP protokole, leidžiančius kenksmingoms instrukcijoms plisti tarp AI agentų organizacijų viduje.
Šios atakos yra specializuota „užklausų injekcijos“ forma, nukreipta ne į bazinius didelių kalbos modelių (LLM) mechanizmus, o į atskirus agentus, skirtus specifinėms funkcijoms atlikti, pavyzdžiui, vertimui ar duomenų analizei. Daugelis tokių agentų neturi tinkamų vidinių apsaugos priemonių, leidžiančių kenksmingoms komandoms iš vieno pažeisto agente būti patikėtomis ir vykdomomis kitų agentų. Problema dar labiau komplikavasi dėl MCP serverių, kurie saugo kredencialus ir implicitškai pasitiki bendraamžiais, taip leidžiant užpuolikams pasinaudoti šiuo pasitikėjimu vykdant neteisėtas operacijas.
Mohiuddin testavo paveiktus agentus iš žymių organizacijų, tokių kaip Google, JP Morgan Chase, Rapid7, Prancūzijos vyriausybė ir kitų, atskleisdamas, kad išnaudojimo metodas, vadinamas „protokolų persijungimu“ (protocol pivoting), leidžia užpuolikui pradžioje patekti per vieną komunikacijos protokolą, o vėliau eskaluoti leidimus išnaudojant pasitikėjimo prielaidas tarp skirtingų protokolų. Pavyzdžiui, užpuolikas gali panaudoti MCP, kad paskirtų kenksmingą užduotį agentui, kuris savo ruožtu perduoda blogų komandų per alternatyvius protokolus, tokius kaip Google Agent-to-Agent (A2A) protokolas ar nauji standartai, pavyzdžiui, Agent Network Protocol.
Įdomu tai, kad aptikti pažeidžiamumai apėmė trūkumą Google MCP įrankių rinkinyje, skirtame duomenų bazėms, kuriame trūko tvirtų persiuntimo patvirtinimo taisyklių, leidusių vykdyti serverio pusės užklausų klastojimą (SSRF) atakas. Google sprendė šią problemą įgyvendindami griežtą IP leistinų sąrašų kontrolę ir atmetant nesaugias bazinio URL reikšmes paleidimo metu. Rapid7 taip pat greitai sureagavo į susijusį MCP pažeidžiamumą, nors jo sunkumas buvo vertinamas kaip mažas.
Ekspertai pabrėžia, kad problemos šaknys yra MCP bei susijusių protokolų projektavimo prielaidoje, kad jie veiks izoliuotai, be išsamios kryžminių protokolų pasitikėjimo kontrolės. Rapid7 Douglas McKee pažymėjo, kad „kiekvienas protokolas saugo savo priekinę duris, o niekas nestebi tarpdurio koridoriaus“, akcentuodamas architektūrinius akligatvius.
Nors kai kurie tyrėjai šias atakas klasifikuoja kaip „netiesioginę užklausų injekciją“, nes kenksmingi įvestys tarp protokolų peržengia ribas, plačiai paplitusi protokolų persijungimo technika organizacijose rodo sistemines problemas dabartiniuose AI agentų tinkluose.
Pagrindinė pamoka kūrėjams ir sistemų architektams yra būtinybė įdiegti nulio pasitikėjimo principus AI agentų ekosistemose. Įvestys, perduodamos iš LLM ar kitų agentų, turėtų būti traktuojamos su tokiu pačiu įtarumu kaip ir nepatikimi interneto duomenys, taikant griežtą patvirtinimą bei autorizavimą. Įprastos apsaugos priemonės prieš injekcijas ir SSRF pažeidžiamumus lieka aktualios ir turi būti įdiegtos šiuolaikinėse AI darbo eigose.
Kadangi AI agentų diegimas spartėja, MCP ir susijusių protokolų saugumo spragų identifikavimas ir jų sprendimas yra kritiškai svarbūs norint apsaugoti jautrius duomenis ir išlaikyti pasitikėjimą automatizuotomis sistemomis.
Šaltiniai ir originalūs pranešimai
Skaityti originalų šaltinį ↗
Komentarai (0)
Komentarų dar nėra. Pradėkite diskusiją.
Rašyti komentarą
Komentarai publikuojami po moderavimo. Jūsų vardas ir komentaras bus vieši. Paskyra