
AI-Agenten-Kommunikationsprotokoll MCP mit Kritischen Sicherheitslücken

Image: Ars Technica · Source
Ein Sicherheitsforscher entdeckt Schwachstellen im Model Context Protocol (MCP), das weit verbreitet für die Kommunikation zwischen AI-Agenten verwendet wird, wodurch bösartige Eingaben sich innerhalb von Netzwerken ausbreiten und eskalieren können.
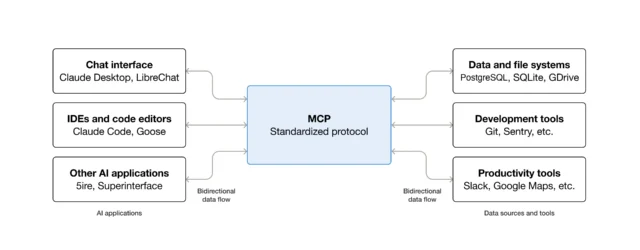
Das Model Context Protocol (MCP), ein neuer Standard zur Erleichterung der Kommunikation zwischen AI-Agenten innerhalb interner Netzwerke, wurde als anfällig für bedeutende Sicherheitslücken erkannt, die weltweit den Einsatz von Unternehmens-KI bedrohen. Der unabhängige Forscher Syed Anas Mohiuddin demonstrierte kürzlich eine Reihe von Angriffen, die Vertrauenslücken inhärent im MCP ausnutzen und es bösartigen Anweisungen ermöglichen, sich zwischen AI-Agenten innerhalb von Organisationen zu verbreiten.
Diese Angriffe stellen eine spezialisierte Form der Prompt Injection dar, die nicht die zugrundeliegenden großen Sprachmodelle (LLMs) betrifft, sondern einzelne Agenten, die für spezifische Funktionen wie Übersetzung oder Datenanalyse zuständig sind. Viele dieser Agenten verfügen nicht über ausreichende interne Schutzmechanismen, was es ermöglicht, dass schädliche Befehle von einem kompromittierten Agenten von nachgelagerten Agenten vertraut und ausgeführt werden. Das Problem wird verschärft durch die Tatsache, dass MCP-Server Anmeldeinformationen speichern, die implizit auf Peer-Agenten vertrauen, was Angreifern erlaubt, dieses Vertrauen auszunutzen und unautorisierte Aktionen durchzuführen.
Mohiuddin testete betroffene Agenten von namhaften Organisationen wie Google, JP Morgan Chase, Rapid7, der französischen Regierung und anderen und deckte auf, dass die Exploit-Technik – bezeichnet als „Protocol Pivoting“ – einem Angreifer ermöglicht, initialen Zugang durch ein Kommunikationsprotokoll zu erlangen und Berechtigungen durch Ausnutzen von Vertrauensannahmen zwischen verschiedenen Protokollen zu eskalieren. Beispielsweise könnte ein Angreifer MCP verwenden, um einer Agenten eine bösartige Aufgabe zuzuweisen, die dann schädliche Befehle über alternative Protokolle wie Googles Agent-to-Agent (A2A)-Protokoll oder aufkommende Standards wie das Agent Network Protocol weiterleitet.
Bemerkenswert waren dabei auch Schwachstellen, darunter eine Lücke im MCP-Toolbox von Google für Datenbanken, die robuste Richtlinien zur Validierung von Weiterleitungen vermissen ließ und Angreifern SSRF-Angriffe (Server-Side Request Forgery) erlaubte. Google reagierte mit strenger IP-Whitelist und Zurückweisung unsicherer Basis-URLs beim Start. Rapid7 behebt eine verwandte MCP-Schwachstelle mit niedriger Schwerebewertung, ergriff aber umgehend Gegenmaßnahmen.
Experten betonen, dass die Probleme entstehen, da MCP und verwandte Protokolle mit der Annahme isolierter Operationen ohne umfassende vertrauensübergreifende Prüfungen konzipiert wurden. Douglas McKee von Rapid7 hob hervor: „Jedes Protokoll prüft seine eigene Haustür, während niemand den Flur dazwischen überwacht,“ was architektonische Blindstellen hervorhebt.
Obwohl einige Forscher diese Exploits als Unterklasse der Prompt Injection – indirekte Prompt Injection – klassifizieren, da bösartige Eingaben Protokollgrenzen überschreiten, weist die breite Anwendbarkeit der Pivoting-Technik bei verschiedenen Organisationen auf systemische Probleme in aktuellen AI-Agenten-Netzwerken hin.
Die zentrale Lehre für Entwickler und Systemarchitekten ist die Notwendigkeit, Zero-Trust-Prinzipien innerhalb von AI-Agenten-Ökosystemen umzusetzen. Eingaben, die von LLMs oder anderen Agenten übergeben werden, sollten mit der gleichen Skepsis behandelt werden wie unzuverlässige Internetdaten, mit rigorosen Validierungs- und Autorisierungsschritten. Etablierte Gegenmaßnahmen gegen Injection- und SSRF-Schwachstellen bleiben relevant und sollten in moderne AI-Workflows integriert werden.
Mit der beschleunigten Einführung von AI-Agenten ist das Aufdecken und Beheben dieser Sicherheitslücken in MCP und verwandten Protokollen entscheidend, um sensible Daten zu schützen und Vertrauen in automatisierte Systeme zu erhalten.
Quellen und Originalberichte
Read the original source ↗
Kommentare (0)
Noch keine Kommentare.
Kommentar schreiben
Kommentare erscheinen nach Moderation. Name und Kommentar werden öffentlich angezeigt. Konto