
Protokół komunikacyjny agentów AI MCP ma krytyczne luki bezpieczeństwa

Image: Ars Technica · Source
Niezależny badacz bezpieczeństwa odkrywa luki w Model Context Protocol (MCP), szeroko stosowanym do komunikacji między agentami AI, które umożliwiają rozprzestrzenianie i eskalację złośliwych poleceń w sieciach.
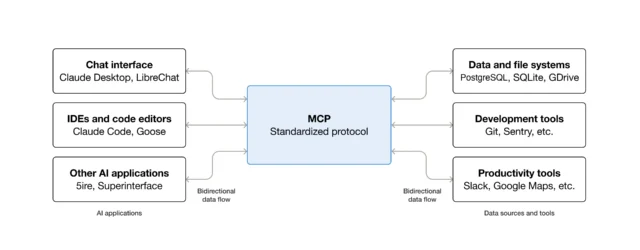
Model Context Protocol (MCP), nowy standard ułatwiający komunikację między agentami AI w sieciach wewnętrznych, zawiera poważne luki bezpieczeństwa, które zagrażają wdrożeniom AI w przedsiębiorstwach na całym świecie. Niezależny badacz Syed Anas Mohiuddin niedawno zaprezentował serię ataków wykorzystujących luki zaufania w MCP, pozwalając na rozprzestrzenianie się złośliwych instrukcji między agentami AI w organizacjach.
Te ataki to specjalistyczna forma wstrzykiwania poleceń (prompt injection), skierowana nie do podstawowych dużych modeli językowych (LLM), lecz do poszczególnych agentów wykonujących specyficzne funkcje, takie jak tłumaczenie czy analiza danych. Wiele takich agentów nie ma odpowiednich zabezpieczeń wewnętrznych, co pozwala na zaufanie i wykonanie szkodliwych poleceń pochodzących od jednego zagrożonego agenta przez inne, znajdujące się dalej w łańcuchu. Problem pogłębia fakt, że serwery MCP przechowują poświadczenia, które implicitnie ufają agentom partnerskim, pozwalając napastnikom wykorzystać to zaufanie do wykonania nieautoryzowanych działań.
Mohiuddin testował podatne agenty od znanych organizacji, m.in. Google, JP Morgan Chase, Rapid7, rząd Francji i inne, ujawniając technikę eksploatacji nazwaną „przechwytywaniem protokołu” (protocol pivoting). Pozwala ona atakującemu uzyskać wstępny dostęp przez jeden protokół komunikacyjny i eskalować uprawnienia, wykorzystując założenia zaufania między różnymi protokołami. Na przykład atakujący może użyć MCP, aby przydzielić złośliwe zadanie agentowi, który następnie przesyła szkodliwe polecenia przez inne protokoły, takie jak Google Agent-to-Agent (A2A) lub nowe standardy, np. Agent Network Protocol.
Wśród wykrytych luk znalazła się wada w toolboxie MCP Google dla baz danych, który nie stosował solidnych zasad walidacji przekierowań, umożliwiając ataki typu server-side request forgery (SSRF). Google zaradził temu poprzez wprowadzenie ścisłego zakresu dozwolonych adresów IP oraz odrzucanie niebezpiecznych bazowych URL-i podczas uruchamiania. Rapid7 szybko poprawił powiązaną lukę MCP, ocenioną jako niskiego ryzyka.
Eksperci podkreślają, że problemy wynikają z założeń projektowych MCP i pokrewnych protokołów, które przyjmowały izolowaną pracę bez pełnych kontroli zaufania między protokołami. Douglas McKee z Rapid7 zwrócił uwagę, że „każdy protokół pilnuje swojego frontowego wejścia, podczas gdy nikt nie strzeże korytarza pomiędzy nimi”, wskazując na architektoniczne punkty ślepe.
Niektórzy badacze klasyfikują te eksploity jako podklasę wstrzykiwania poleceń — pośrednie wstrzykiwanie poleceń — ponieważ złośliwe dane przekraczają granice protokołów. Jednak szeroka zastosowalność techniki przechwytywania protokołu w różnych organizacjach wskazuje na systemowe problemy w obecnych sieciach agentów AI.
Główne przesłanie dla twórców i architektów systemów to konieczność przyjęcia zasad zero-trust (zerowego zaufania) w ekosystemach agentów AI. Dane przekazywane przez LLM lub inne agenty powinny być traktowane z taką samą ostrożnością jak nieufne dane z internetu, z rygorystyczną walidacją i autoryzacją. Sprawdzone środki zaradcze przeciw wstrzyknięciom i lukom SSRF pozostają istotne i należy je integrować z nowoczesnymi procesami AI.
W miarę przyspieszającego wdrażania agentów AI, wykrywanie i eliminowanie tych luk w MCP i pokrewnych protokołach jest kluczowe dla ochrony wrażliwych danych i utrzymania zaufania do systemów automatycznych.
Źródła i oryginalne doniesienia
Read the original source ↗
Komentarze (0)
Nie ma jeszcze komentarzy.
Napisz komentarz
Komentarze publikujemy po moderacji. Nazwa i komentarz będą publiczne. Konto