
Платформа NVIDIA Vera Rubin доминирует в бенчмарках MLPerf Training и Endpoints
Image: NVIDIA · Source
Новая платформа NVIDIA Vera Rubin лидирует во всех категориях бенчмарков MLPerf Training v6.1 и обеспечивает более чем 10-кратный рост эффективности пропускной способности агентного ИИ на ватт в MLPerf Endpoints.
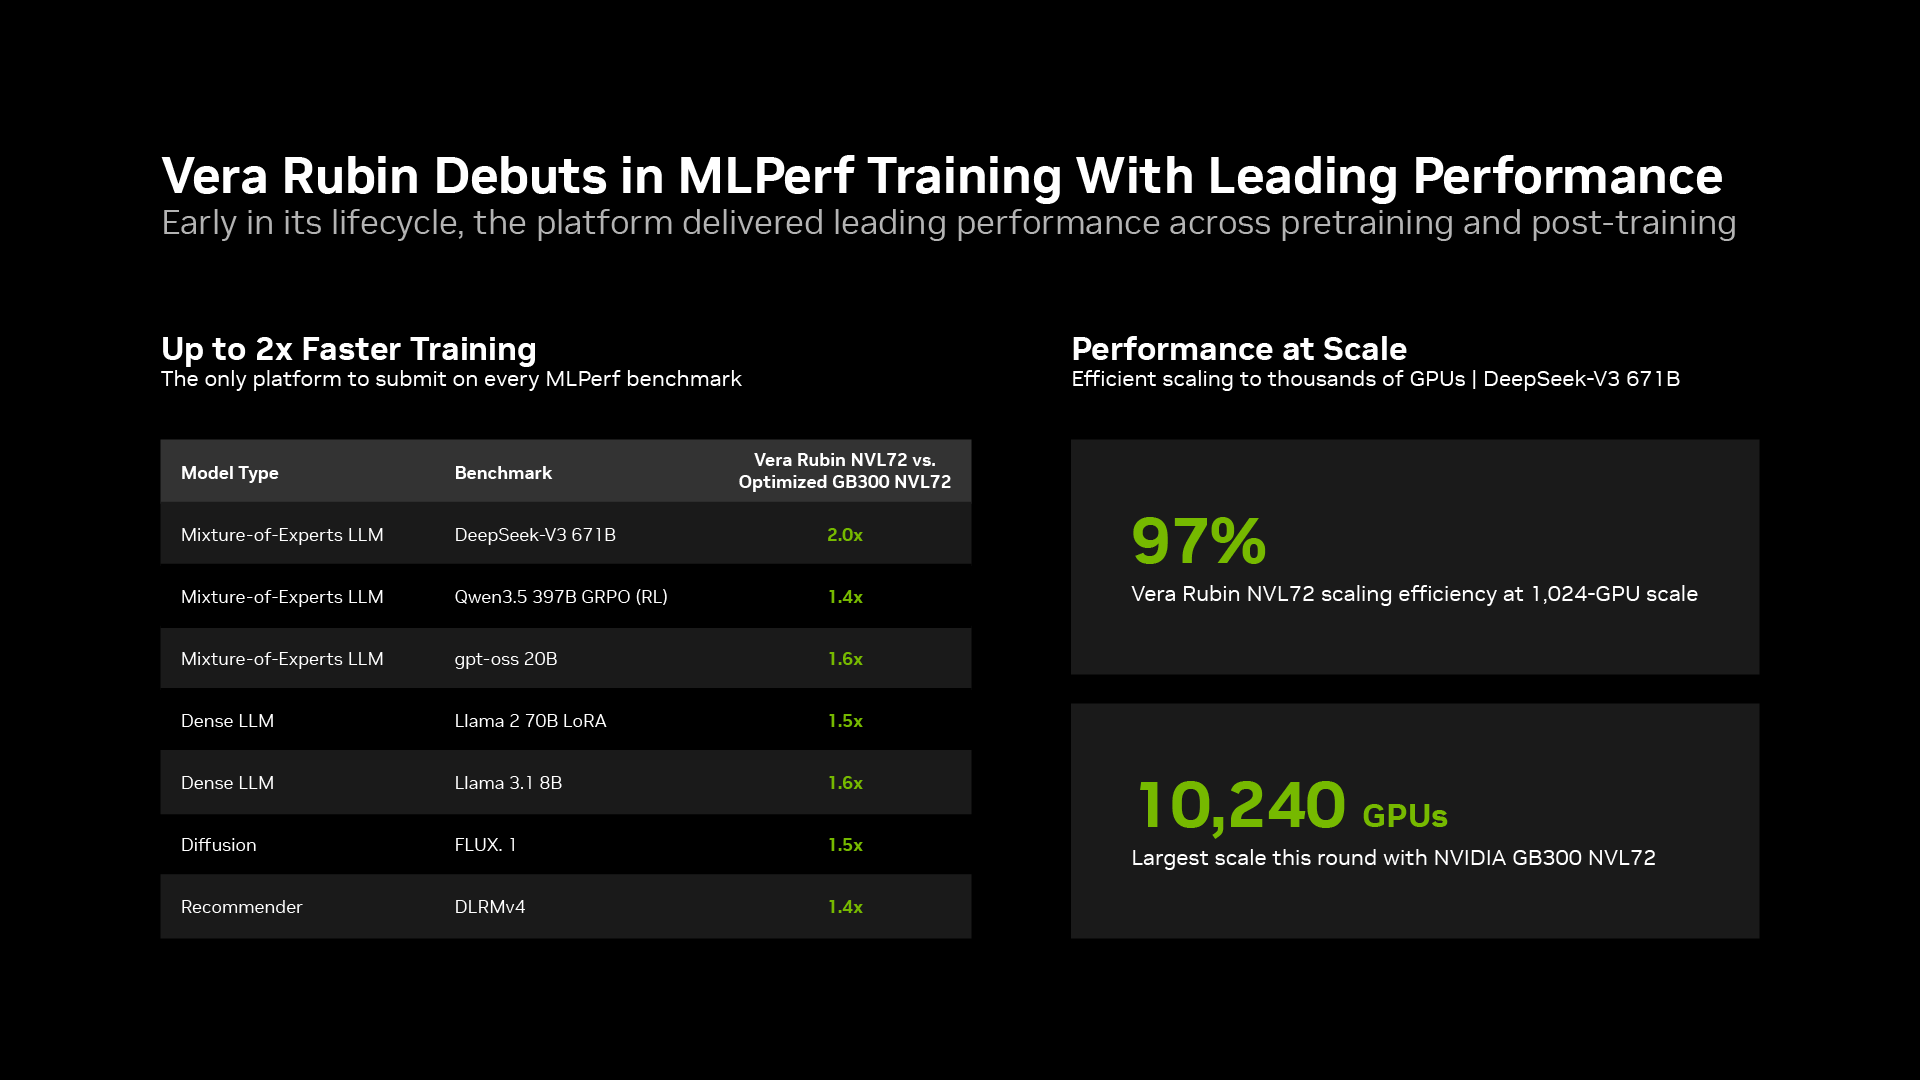
Компания NVIDIA одержала убедительную победу с платформой Vera Rubin в последних результатах бенчмарка MLPerf, отметив сильный дебют как по показателям производительности обучения, так и вывода. В недавно опубликованных бенчмарках MLPerf Training v6.1 система Vera Rubin от NVIDIA была единственной платформой, подавшей результаты по всем тестам, охватывающим крупные языковые модели, генерацию изображений, системы рекомендаций и обучение с подкреплением после тренировки. Она демонстрировала до двухкратного превосходства по производительности на один GPU по сравнению с высоко оптимизированной системой NVIDIA GB300, подчёркивая стремительные улучшения поколений в аппаратном и программном обеспечении.
Масштабируемость стала одним из ключевых достоинств Vera Rubin, особенно в бенчмарке DeepSeek-V3, где система сохраняла около 97% эффективности масштабирования при увеличении количества GPU с 256 до 1024, сокращая время обучения с 16 до примерно 4 минут. NVIDIA также продемонстрировала обучение в очень большом масштабе: системы GB300 выполняли бенчмарки с использованием 10 240 GPU, что является максимальным масштабом, наблюдаемым в этом цикле, сопоставимым с Microsoft Azure, использующим системы GB200. Это подчёркивает важность эффективной координации многих GPU, достигнутой за счёт сетевых технологий NVLink scale-up внутри систем и сетей Quantum-X800 InfiniBand и Spectrum-X Ethernet scale-out в дата-центрах.
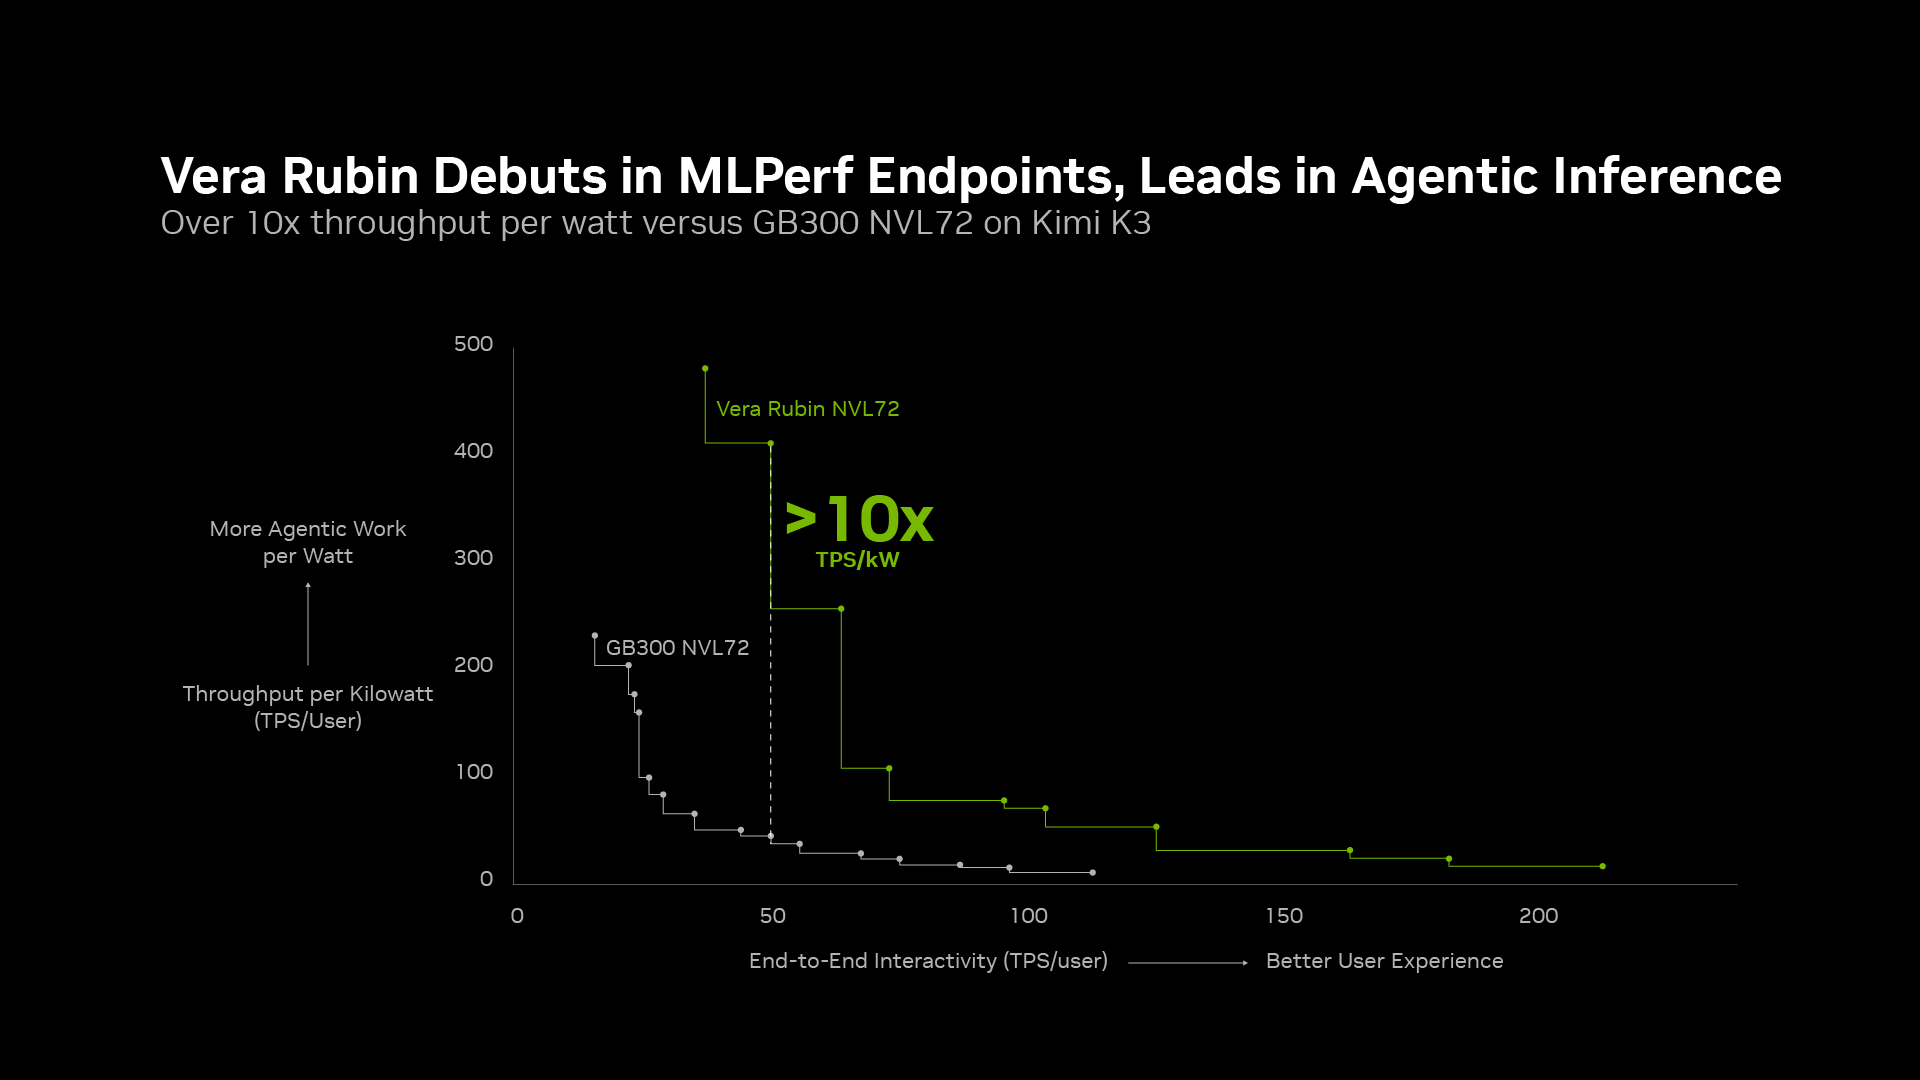
Впервые для NVIDIA в MLPerf Endpoints, ориентированном на задачи агентного ИИ, платформы Vera Rubin обеспечили более чем десятикратное улучшение пропускной способности на ватт по сравнению с системами предыдущего поколения, такими как GB300, при сохранении низких задержек отклика. Это критично, поскольку задачи агентного ИИ часто требуют многоступенчатого рассуждения и многократного вызова инструментов, генерируя множество токенов на каждое выполненное действие. Более высокая генерация токенов на ватт означает, что дата-центры могут обслуживать большее количество ИИ-агентов одновременно при меньших энергозатратах.
Экосистема партнёров NVIDIA сыграла ключевую роль в этих достижениях, с результатами, представленными 20 организациями, включая Asus, Cisco, Dell Technologies, Google Cloud, HPE, Oracle, Supermicro и других. Эти вклады отражают универсальность и потенциал оптимизации программного стека NVIDIA на базе CUDA в сочетании с новейшей архитектурой аппаратного обеспечения.
Помимо MLPerf, Vera Rubin также лидирует в независимых бенчмарках ИИ-агентов, таких как SemiAnalysis AgentX и Artificial Analysis AgentPerf, подтверждая свои возможности в областях предварительного обучения, пост-тренинга и агентного вывода. Она также поддерживает требования высокопроизводительных вычислений, что было продемонстрировано на недавней конференции SC26. NVIDIA отмечает, что текущие оптимизации программного обеспечения еще больше улучшат производительность Vera Rubin, обещая постоянное расширение ценности для клиентов, инвестирующих в эту инфраструктуру.
Для детального технического анализа доступны блоги NVIDIA по MLPerf Training и MLPerf Endpoints, предоставляющие всесторонний разбор достижений в бенчмарках и конфигураций систем. Платформа Vera Rubin уверенно укрепляет лидерство NVIDIA в ускорении обучения и вывода ИИ в масштабах, сочетая энергоэффективность с непревзойденной пропускной способностью и масштабируемостью.
Источники и первоисточники
Read the original source ↗
Комментарии (0)
Комментариев пока нет. Начните обсуждение.
Написать комментарий
Комментарии публикуются после модерации. Ваше имя и комментарий будут видны всем. Аккаунт