
NVIDIA Vera Rubin-plattform dominerer MLPerf Training og Endpoints benchmark
Bilde: NVIDIA · Kilde
NVIDIAs nye Vera Rubin-plattform leder MLPerf Training v6.1 benchmark på tvers av alle kategorier og leverer over 10 ganger bedre effektivitet i MLPerf Endpoints agentisk AI gjennomstrømning per watt.
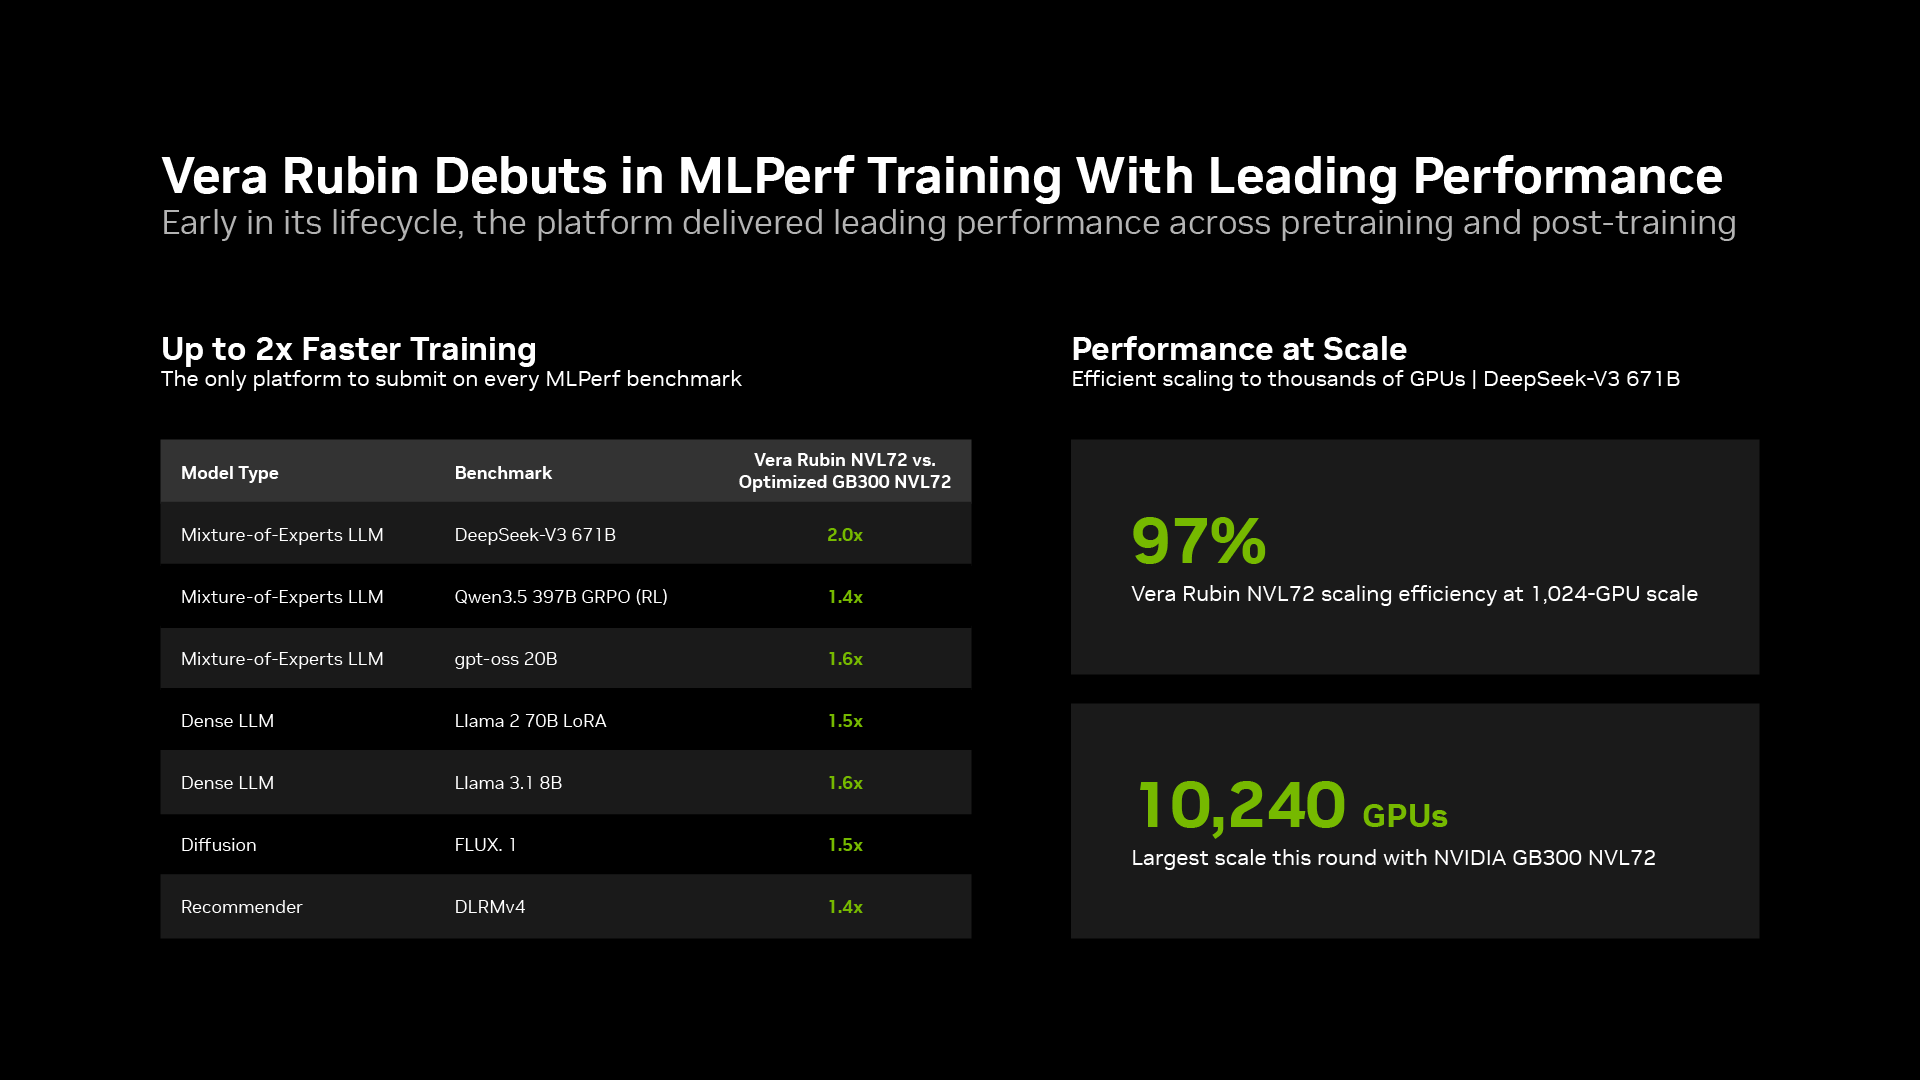
NVIDIA har oppnådd en overveldende seier med sin Vera Rubin-plattform i de siste MLPerf benchmark-resultatene, og markerer en sterk debut både innen trening og inferensytelse. I de nylig utgitte MLPerf Training v6.1 benchmarkene var NVIDIAs Vera Rubin-system den eneste plattformen som leverte resultater for alle benchmark, som omfatter store språkmodeller, bildegenerering, anbefalingssystemer og forsterkningslæring etter trening. Den leverte opptil dobbelt så høy ytelse per GPU sammenlignet med det høyt optimaliserte NVIDIA GB300-systemet, noe som viser raske generasjonsforbedringer i deres maskinvare og programvare.
Skalerbarhet var et høydepunkt for Vera Rubin, spesielt på DeepSeek-V3 benchmarken, hvor systemet opprettholdt cirka 97 % skalerings-effektivitet fra 256 til 1 024 GPU-er, og reduserte treningstiden fra 16 minutter til rundt fire minutter. NVIDIA demonstrerte også trening i massiv skala: GB300-systemene kjørte benchmark med 10 240 GPU-er, den største skalaen observert denne runden, matchet av Microsoft Azure som brukte GB200-systemer. Dette understreker viktigheten av effektiv koordinering av flere GPU-er, oppnådd gjennom NVIDIAs NVLink scale-up-nettverk innenfor systemer, og Quantum-X800 InfiniBand og Spectrum-X Ethernet scale-out-nettverk på tvers av datasentre.
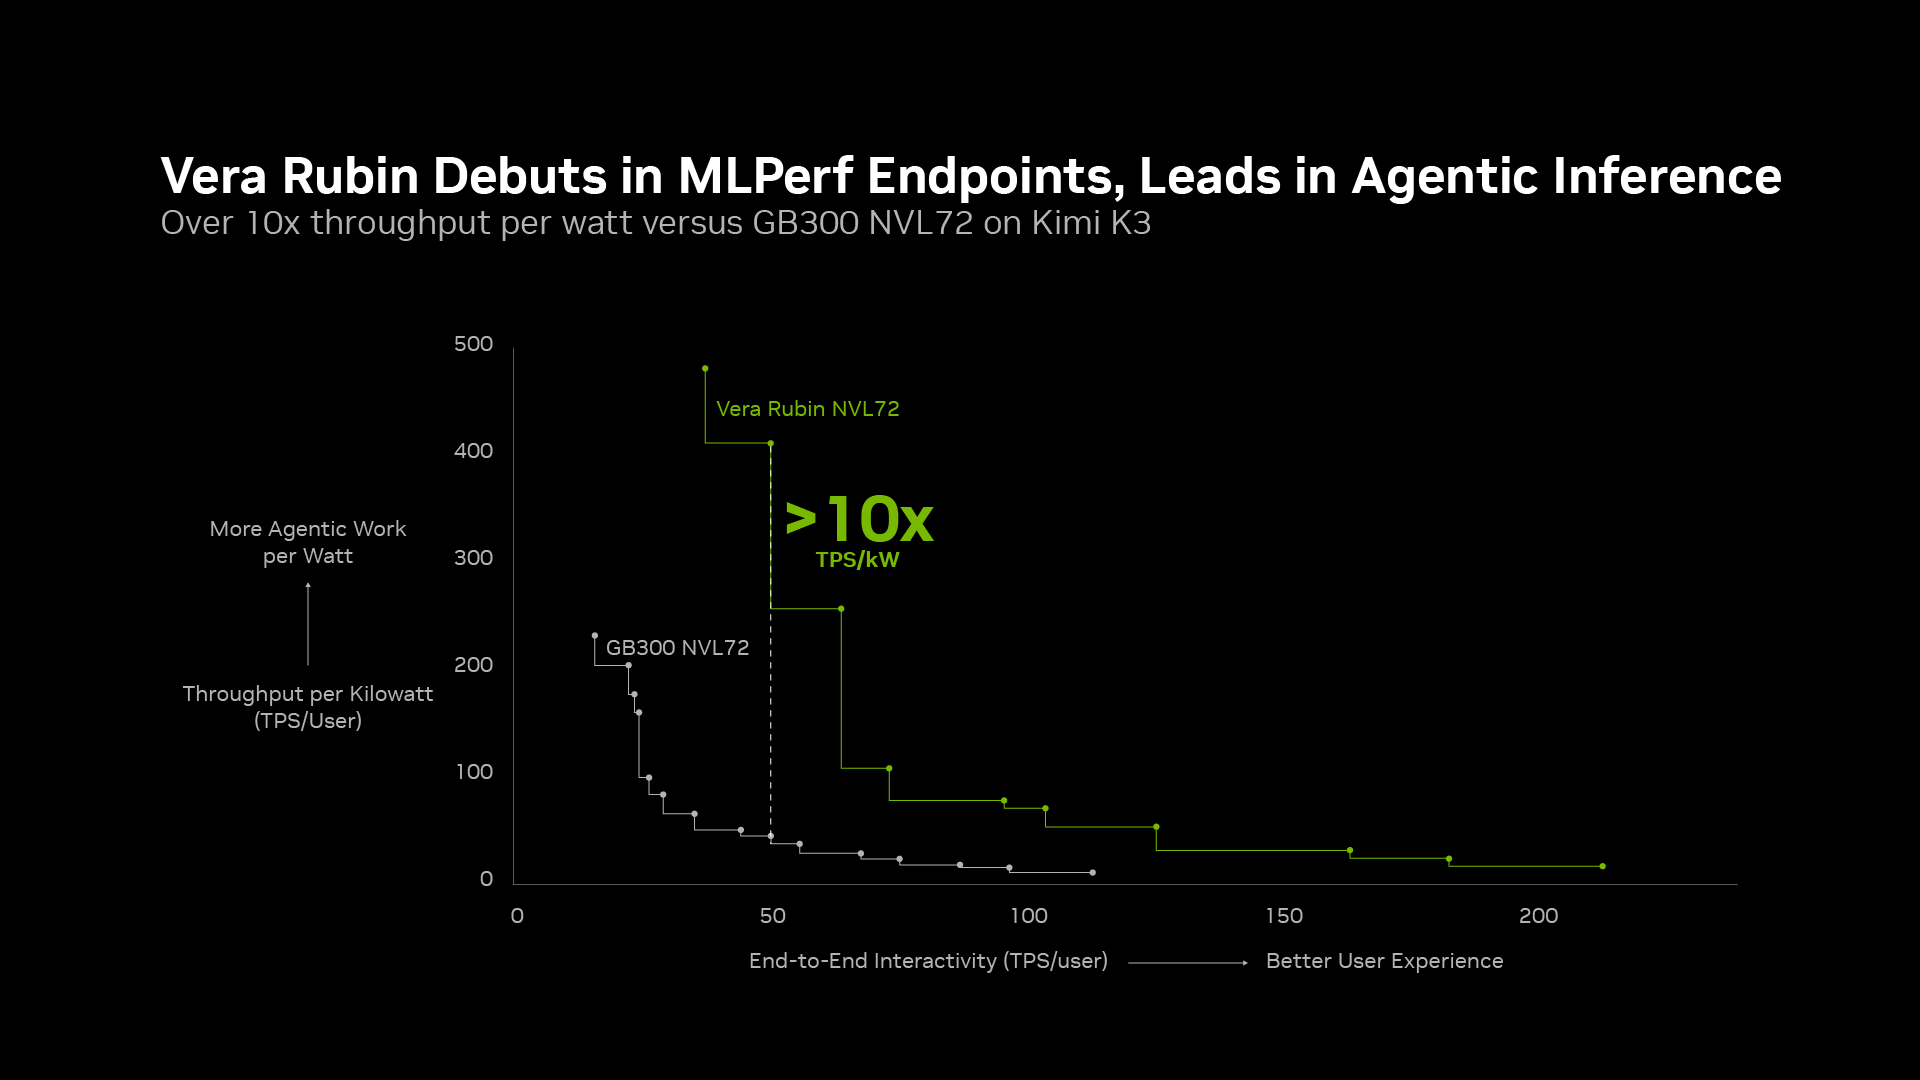
For første gang for NVIDIA i MLPerf Endpoints, som retter seg mot agentisk AI-inferens, leverte Vera Rubin-plattformene mer enn ti ganger forbedret gjennomstrømning per watt sammenlignet med forrige generasjons systemer som GB300, samtidig som responstiden ble opprettholdt. Dette er kritisk fordi agentisk AI-oppgaver ofte krever flertrinns resonnering og gjentatte verktøy-kall, som genererer mange tokens for hver fullførte handling. Høyere tokenproduksjon per watt betyr at datasentre kan betjene flere AI-agenter samtidig med lavere strømforbruk.
NVIDIAs partnerøkosystem spilte en nøkkelrolle i disse prestasjonene, med innleveringer fra 20 organisasjoner inkludert Asus, Cisco, Dell Technologies, Google Cloud, HPE, Oracle, Supermicro og andre. Disse bidragene reflekterer allsidigheten og optimaliseringspotensialet i NVIDIAs CUDA-drevne programvare-stack kombinert med deres nyeste maskinvarearkitektur.
Utover MLPerf leder Vera Rubin også i uavhengige AI-agent-benchmark som SemiAnalysis AgentX og Artificial Analysis AgentPerf, noe som bekrefter dens kapasitet på tvers av fortrening, ettertrening og agentisk inferensarbeidsbelastning. Den støtter også høyytelses databehandlingsbehov, som vist på den nylige SC26-konferansen. NVIDIA antyder at løpende programvareoptimaliseringer ytterligere vil forbedre Vera Rubins ytelse, og lover kontinuerlig verdiskapning for kunder som investerer i denne infrastrukturen.
For detaljert teknisk innsikt tilbyr NVIDIAs MLPerf Training- og MLPerf Endpoints-blogger omfattende analyser av benchmark-prestasjoner og underliggende systemkonfigurasjoner. Vera Rubin-plattformen etablerer solid NVIDIAs lederskap i akselerasjon av AI-trening og inferens i stor skala, og kombinerer energieffektivitet med uslåelig gjennomstrømning og skalerbarhet.
Kilder og originalrapportering
Les originalkilden ↗
Kommentarer (0)
Ingen kommentarer ennå. Start diskusjonen.
Skriv en kommentar
Kommentarer publiseres etter moderering. Ditt navn og kommentar vil være synlige offentlig. Konto